

Un plugin Beekeeper Studio qui transforme les plans d’exécution en diagramme interactif, pour trouver facilement la partie lente d’une requête.
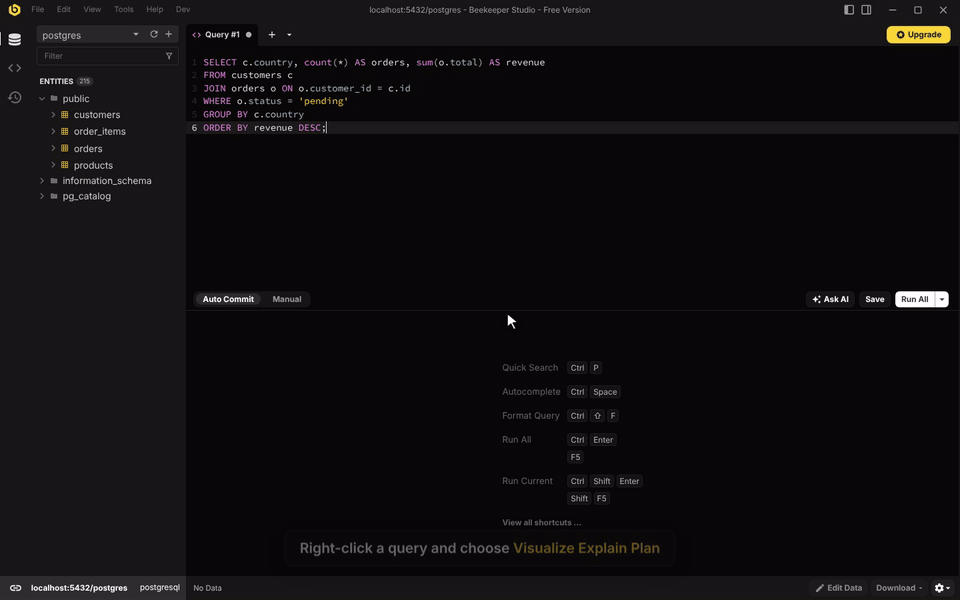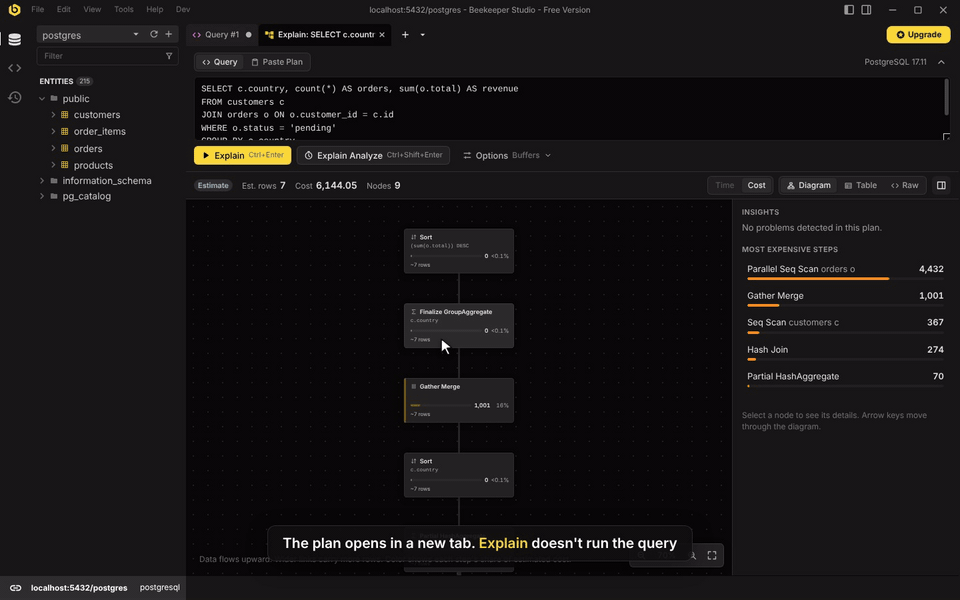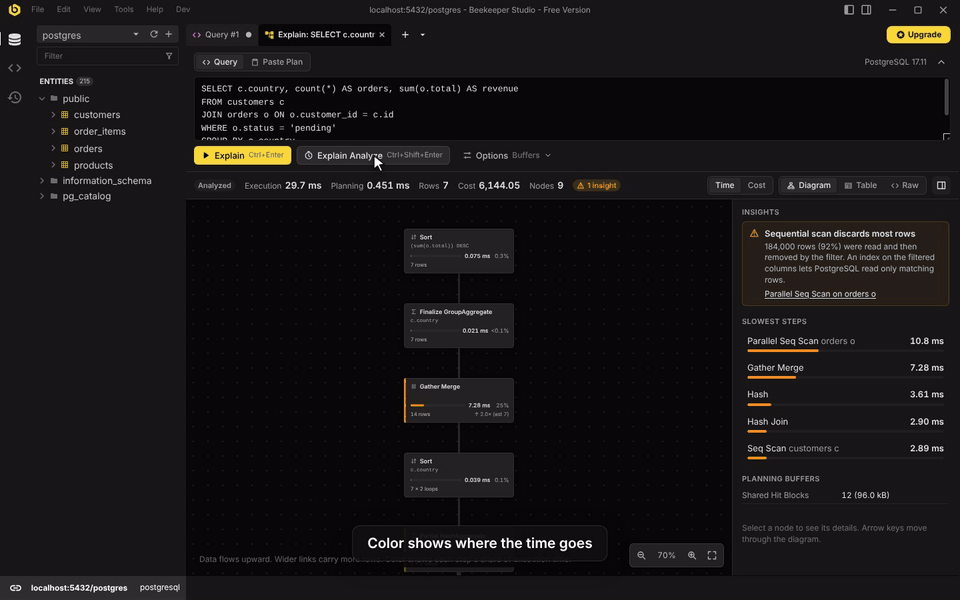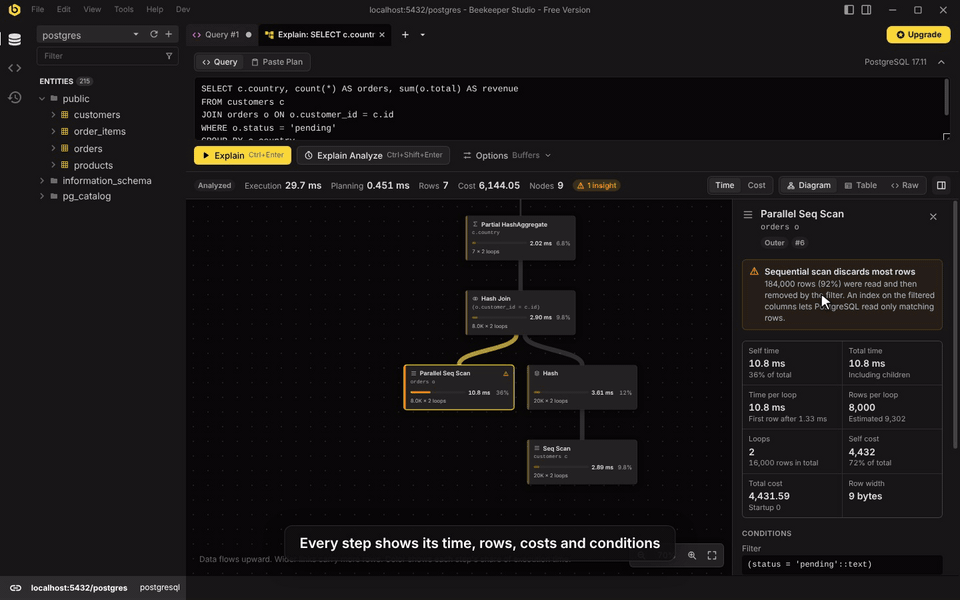
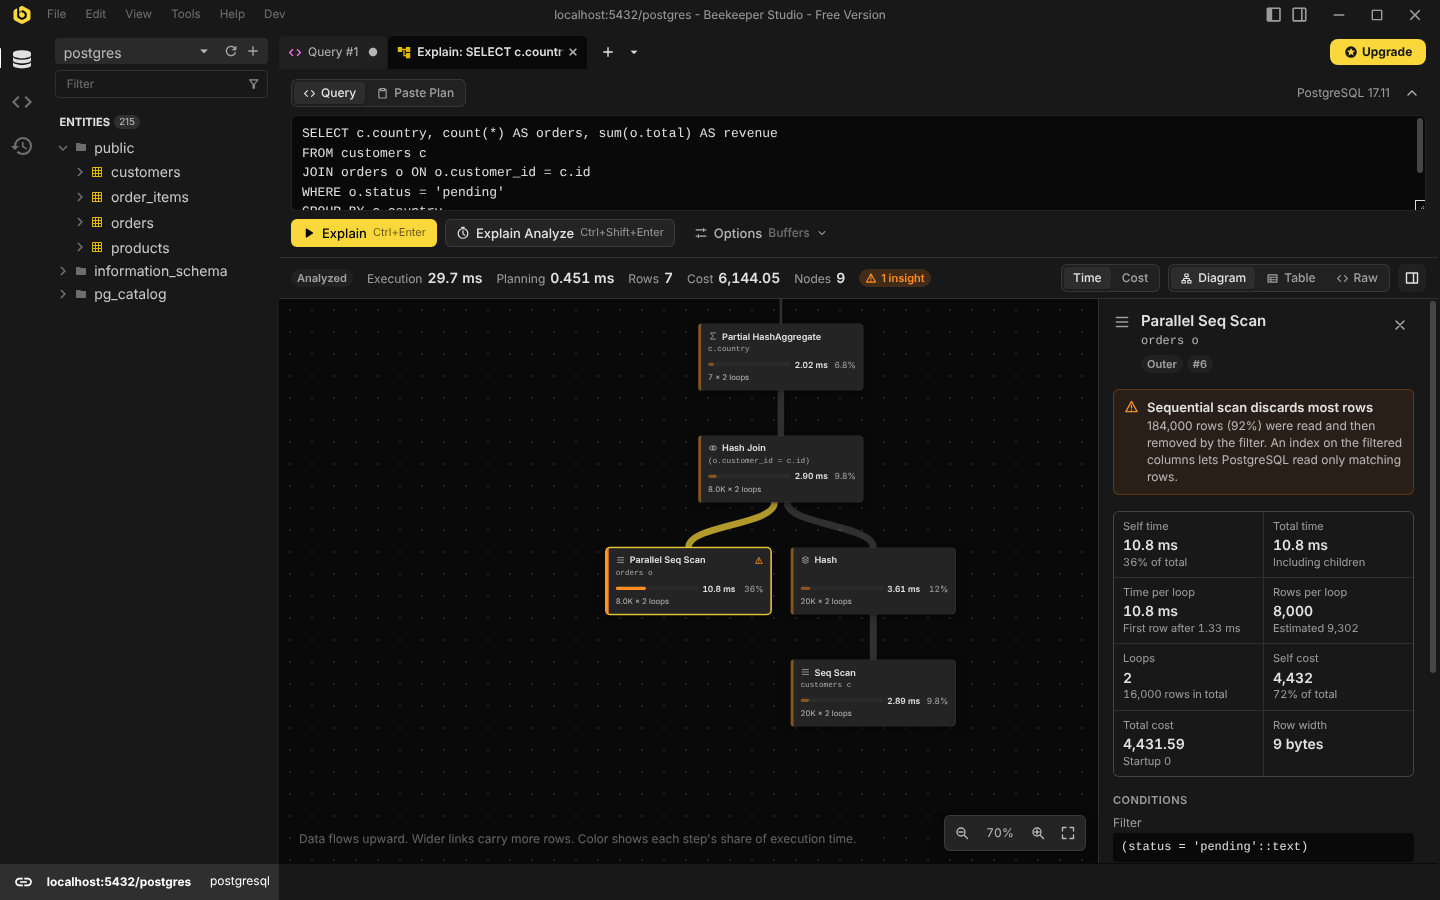
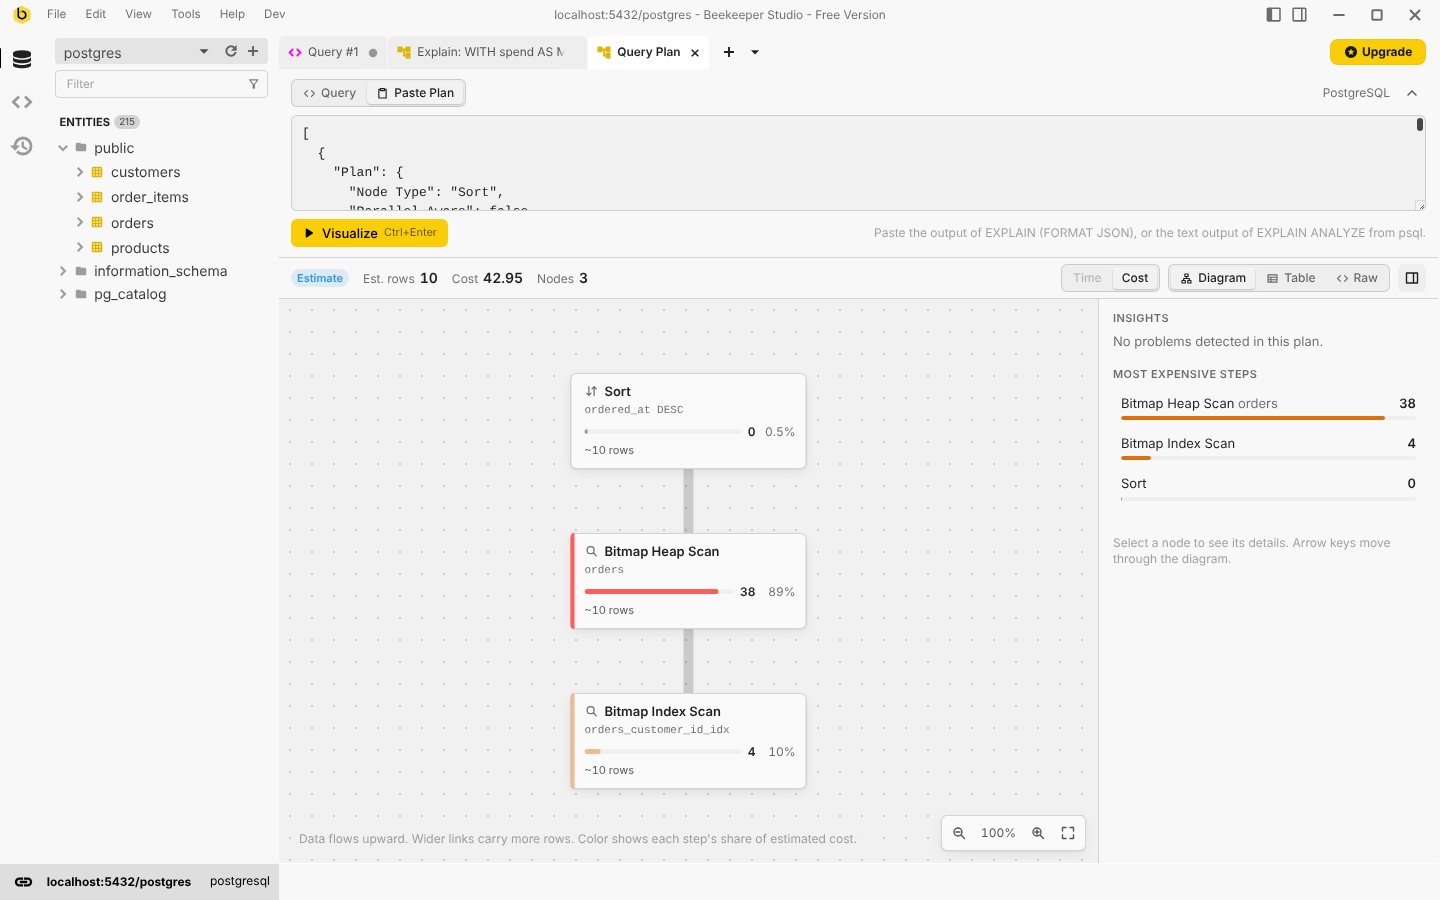
- Diagramme du plan, coloré selon la part du temps d’exécution (ou du coût estimé) de chaque étape. Plus un lien est large, plus il transporte de lignes.
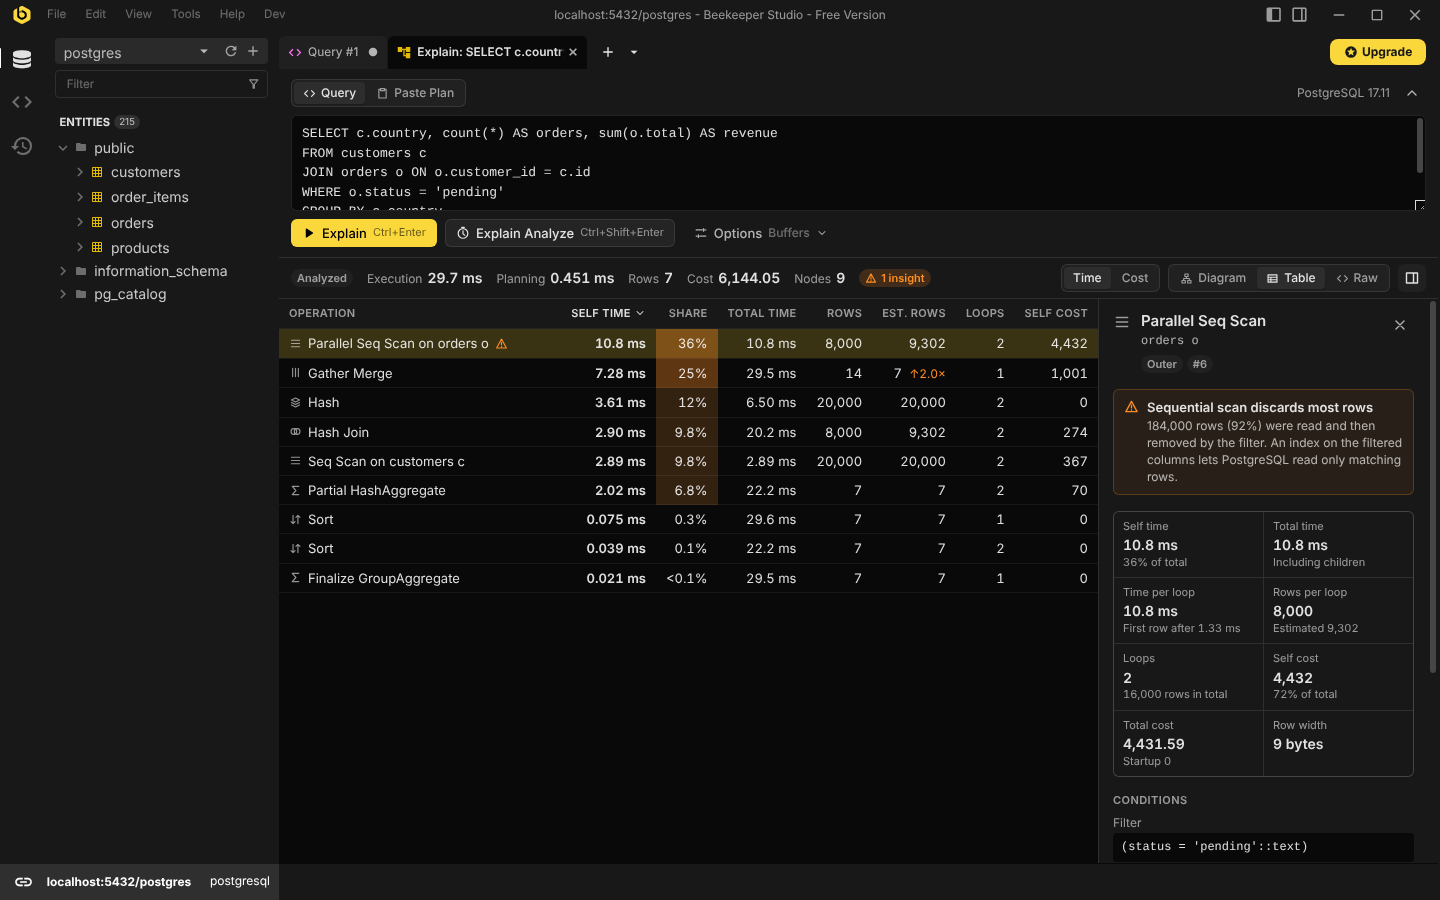
- Vue Tableau dans le style de
explain.depesz.com, triable par temps propre. - Détails de chaque étape : temps propre et total, lignes réelles vs estimées, boucles, coûts, conditions, buffers, mémoire et disque utilisés, workers.
- Insights qui signalent les problèmes courants : scans complets qui écartent la plupart des lignes, tables parcourues une fois par ligne d’une jointure, tris et hachages qui débordent sur disque, sous-requêtes dépendantes, index temporaires que SQLite construit à chaque exécution, grosses erreurs d’estimation de lignes, et plus encore.
- Sortie brute du plan, prête à copier ou enregistrer.
Plus de détails dans les captures d’écran ci-dessous.
Bases de données prises en charge
| Base de données | Explain | Explain Analyze | Coller un plan |
|---|---|---|---|
| PostgreSQL | Oui | Oui | JSON et texte psql |
| MySQL | Oui | 8.0.18+, requêtes de lecture | Arbre, JSON (les deux versions) et le tableau classique |
| MariaDB | Oui | 10.1+, requêtes de lecture | JSON et le tableau classique |
| SQLite, LibSQL | Oui | Non : SQLite ne mesure pas le temps des étapes | L’arbre du shell sqlite3, ou les lignes de résultat |
| SQL Server | Prévu |
Testé avec PostgreSQL 12, 17 et 18 ; MySQL 5.7, 8.0.17, 8.0, 8.4 et 9.7 ; MariaDB 10.4, 10.6 et 11.4 ; et SQLite 3.16, 3.27 et 3.45. Le plugin repose sur un modèle de plan indépendant de la base, donc chaque base n’a besoin que d’un adaptateur (voir Ajouter une base de données).
Utilisation
Il y a plusieurs façons de l’ouvrir :
- Éditeur de requêtes : fais un clic droit sur une requête et choisis Visualize Explain Plan. Le texte sélectionné est utilisé, sinon la requête sous le curseur.
- Menu nouvel onglet : ouvre Explain Visualizer, écris une requête et choisis Explain ou Explain Analyze.
- Grille de résultats : après avoir lancé EXPLAIN toi-même, fais un clic droit sur le plan et choisis Visualize Explain Plan:
- un plan dans une seule cellule (
FORMAT JSONde PostgreSQL, arbre ou JSON de MySQL) : clic droit sur la cellule ; - un plan réparti sur plusieurs lignes (sortie texte de PostgreSQL) : clic droit sur l’en-tête de la colonne
QUERY PLAN; - un tableau (
EXPLAINclassique de MySQL,EXPLAIN QUERY PLANde SQLite) : sélectionne toutes ses lignes et colonnes, puis fais un clic droit sur la sélection. Pour SQLite, la colonne detail seule fonctionne aussi, sans l’imbrication.
- un plan dans une seule cellule (
- Paste Plan : colle une sortie EXPLAIN, par exemple depuis psql, le shell mysql ou sqlite3, ou envoyée par un collègue.
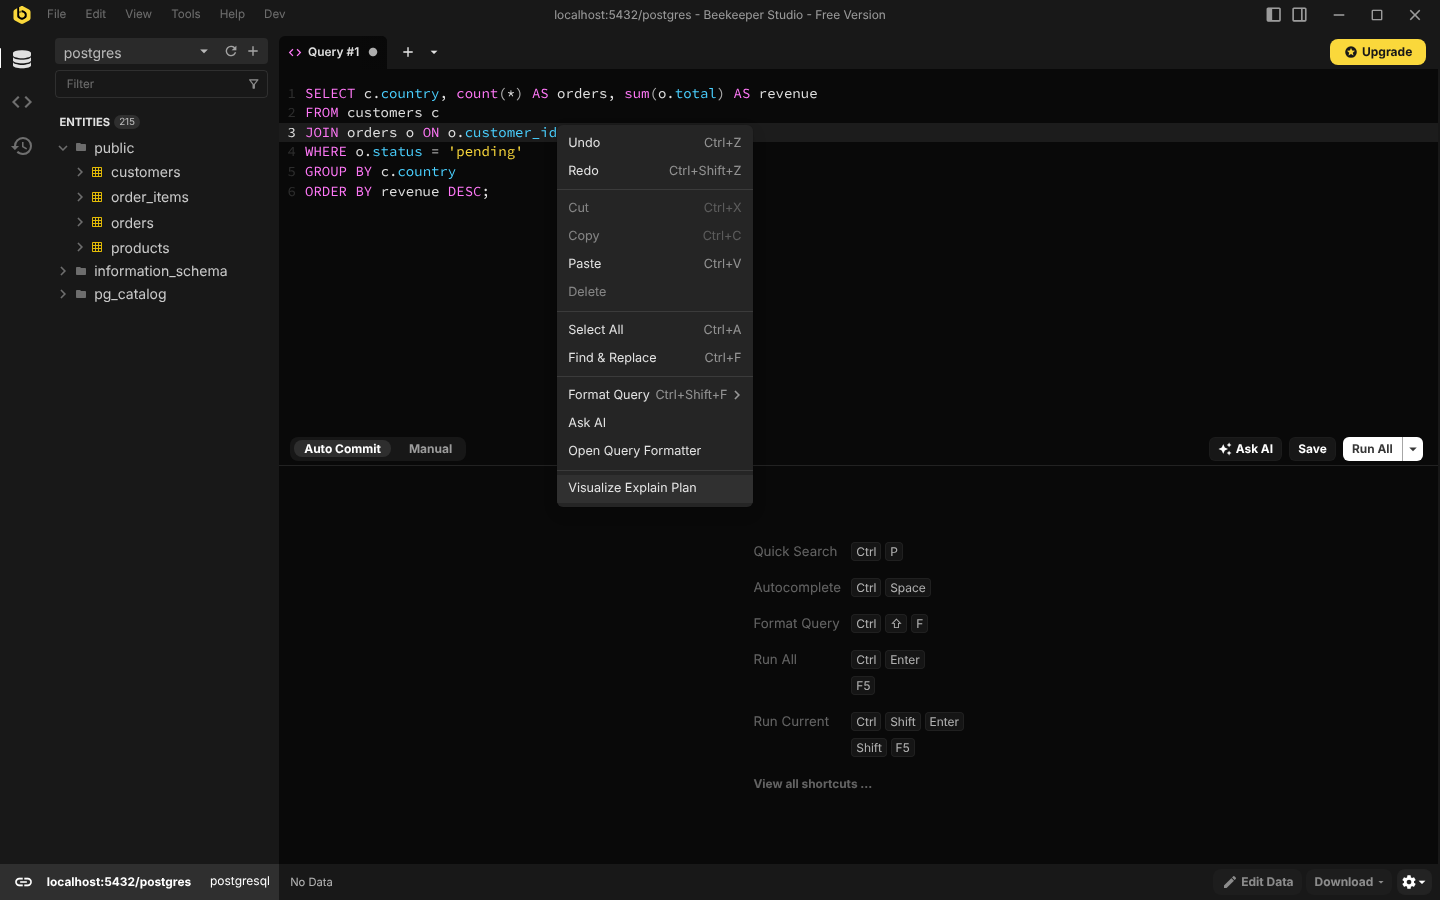
Explain et Explain Analyze
Explain demande son plan à la base sans exécuter la requête. C’est toujours sans risque, donc il se lance automatiquement quand l’onglet s’ouvre depuis l’éditeur.
Explain Analyze exécute la requête et mesure chaque étape. La façon de garder ça sûr dépend de la base, voir ci-dessous. Si le texte de l’éditeur commence déjà par EXPLAIN ANALYZE (ou l’équivalent de la base), le plugin l’utilise ; si la requête ne peut pas être analysée, elle est expliquée à la place, et la raison s’affiche sous l’éditeur.
PostgreSQL
Le plugin envoie EXPLAIN ANALYZE ...; ROLLBACK; en une seule requête : les deux instructions partagent une transaction implicite et tout ce que la requête a modifié est annulé. Ça inclut les simples SELECT, qui peuvent appeler des fonctions qui écrivent. Si la requête échoue, la transaction est annulée d’elle-même et la connexion du pool reste propre. Les effets hors transaction, comme les valeurs de séquence, ne sont pas annulés.
Les requêtes qui modifient des données (INSERT, UPDATE, DELETE, MERGE, CTE qui modifient des données…) ne sont analysées qu’après confirmation. Le plugin lit la requête avec un lexer qui suit les règles de PostgreSQL pour les chaînes, commentaires et dollar quotes, et refuse toute saisie contenant plus d’une instruction.
Sur les connexions en lecture seule, Beekeeper Studio n’autorise pas le ROLLBACK : les requêtes qui modifient des données peuvent seulement être expliquées, et Explain Analyze ne se lance jamais automatiquement. Un SELECT qui appelle une fonction qui écrit n’y est pas détecté, comme quand tu l’exécutes dans un onglet de requête.
Le menu Options active ou désactive BUFFERS, VERBOSE, SETTINGS et WAL. Les options que le serveur ne prend pas en charge sont désactivées. Les requêtes avec des paramètres $1 sont expliquées avec GENERIC_PLAN sur PostgreSQL 16+.
MySQL et MariaDB
Le plugin lit la version du serveur et utilise le format de plan le plus récent disponible :
| Serveur | Explain | Explain Analyze |
|---|---|---|
| MySQL 8.0.18+ | EXPLAIN FORMAT=TREE |
EXPLAIN ANALYZE |
| MySQL 5.6 à 8.0.17 | EXPLAIN FORMAT=JSON |
Non disponible |
| MariaDB 10.1+ | EXPLAIN FORMAT=JSON |
ANALYZE FORMAT=JSON |
| Serveurs plus anciens | Le tableau EXPLAIN classique |
Non disponible |
Les UPDATE et DELETE sur une seule table n’ont pas d’arbre ; le plugin se rabat sur FORMAT=JSON, et sur MySQL 9, dont le JSON ne peut pas les afficher non plus, sur le tableau classique. TiDB est reconnu et refusé plutôt que mal interprété.
Explain Analyze n’exécute que les requêtes de lecture. Contrairement à PostgreSQL, on ne peut pas compter sur MySQL pour annuler une requête échouée : envoyée sous la forme START TRANSACTION; ...; ROLLBACK;, une requête en échec laisserait la transaction ouverte sur une connexion du pool que d’autres onglets utilisent ensuite. Un SELECT qui appelle une fonction stockée qui écrit valide ce que la fonction a fait, comme quand tu l’exécutes dans un onglet de requête. Sur MariaDB, le mode lecture seule de Beekeeper Studio refuse l’instruction ANALYZE, donc Explain Analyze n’est pas disponible sur les connexions en lecture seule.
La requête est lue avec les règles de MySQL : commentaires # et -- qui ne se terminent qu’à un saut de ligne, échappements par antislash, chaînes "..." et commentaires /*! ... */, dont MySQL exécute le contenu. NO_BACKSLASH_ESCAPES et ANSI_QUOTES changent la fin des chaînes, et une connexion du pool peut avoir l’un ou l’autre : une requête doit donc se lire comme une seule instruction, et comme une lecture, quelle que soit leur combinaison. Un texte qu’un serveur pourrait lire de plusieurs façons est refusé plutôt que deviné : un commentaire conditionné par version /*!50700 ... */ ou propre à MariaDB /*M! ... */, un retour chariot dans un commentaire --, ou un caractère NUL.
MariaDB mesure le temps par table plutôt que par étape : le temps d’une jointure ou d’une table temporaire correspond à ce que la requête a pris en plus des tables lues.
SQLite
EXPLAIN QUERY PLAN montre quelles tables sont lues, dans quel ordre et avec quel index. SQLite ne donne ni coûts, ni nombres de lignes, ni temps : le diagramme montre les étapes et la vue tableau leurs détails, et il n’y a pas d’Explain Analyze. Les insights signalent les index temporaires que SQLite construit à chaque exécution, les tables parcourues une fois par ligne d’une jointure ou d’une sous-requête corrélée, et les tris dans un B-tree temporaire. Les connexions LibSQL utilisent le même moteur.
Beekeeper Studio découpe le texte SQLite en instructions avec son propre parser avant de les exécuter : une requête contenant un point-virgule (dans une chaîne, un nom ou un commentaire) est donc refusée, pour qu’aucun découpage ne puisse y trouver une seconde instruction.
Captures d’écran
Explain Analyze, avec l’étape lente sélectionnée et un insight à son sujet :
Le même plan en tableau, trié par temps propre :
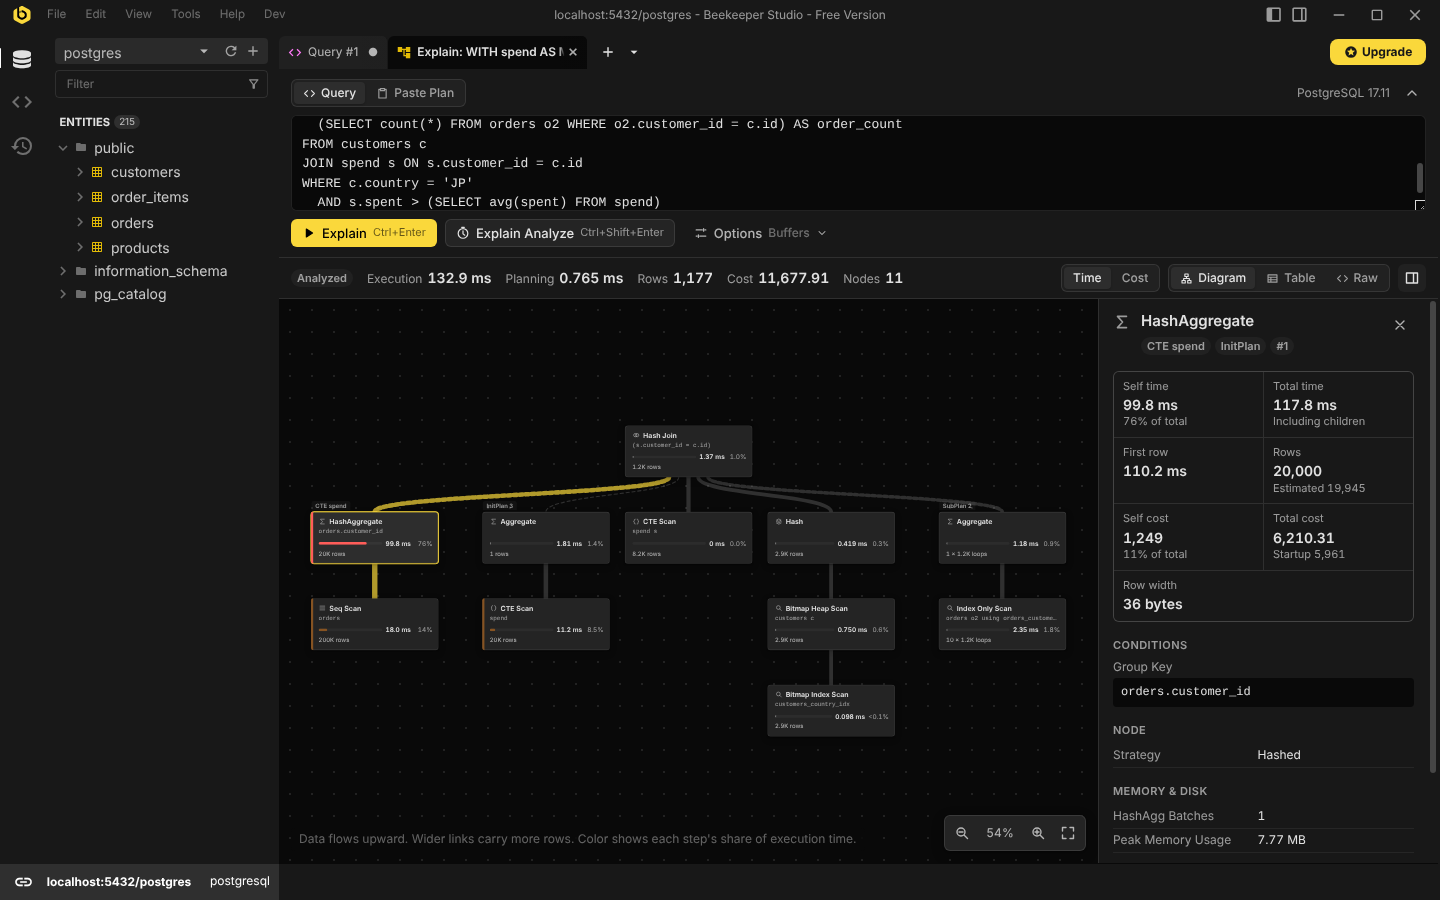
Une requête avec une CTE, un InitPlan et un SubPlan, chacun affiché dans sa propre branche :
Le plugin suit le thème de Beekeeper Studio :
Développement
Nécessite Node.js 22+ et Yarn 1.
yarn install
yarn dev        # builds with hot reload and links the plugin into Beekeeper Studio
yarn test       # unit tests
yarn build      # type-check and build into dist/
yarn dev utilise @beekeeperstudio/vite-plugin, qui crée un lien symbolique de ce dossier dans le répertoire des plugins de Beekeeper Studio.
Par défaut, Beekeeper Studio ne charge que ses propres plugins autorisés. Pour charger celui-ci, ajoute ce qui suit à ton fichier de configuration utilisateur et redémarre l’app :
[pluginSystem]
disabled = false
Connecte-toi ensuite à une base de données : Visualize Explain Plan apparaît dans le menu contextuel de l’éditeur de requêtes et Explain Visualizer dans le menu nouvel onglet.
Harness
dev/harness.html remplace Beekeeper Studio : il charge le plugin dans une iframe et répond à ses requêtes avec les mêmes messages que l’app, en exécutant les requêtes sur de vraies bases. C’est le moyen le plus rapide de travailler sur l’UI, d’essayer toutes les façons d’ouvrir l’onglet, et de changer de base ou de thème.
docker run -d --name pg -e POSTGRES_PASSWORD=pw -p 5432:5432 postgres:17
psql postgres://postgres:pw@localhost:5432/postgres -f scripts/fixtures/seed.sql

docker run -d --name mysql -e MYSQL_ROOT_PASSWORD=pw -e MYSQL_DATABASE=shop -p 3306:3306 mysql:8.4
mysql -h127.0.0.1 -uroot -ppw shop < scripts/fixtures/seed-mysql.sql

PG_URL=postgres://postgres:pw@localhost:5432/postgres \
MYSQL_URL=mysql://root:pw@127.0.0.1:3306/shop \
yarn harness
MARIADB_URL fait pointer le MariaDB du harness vers un autre serveur (sinon il utilise MYSQL_URL). SQLite n’a besoin de rien : une base temporaire est remplie à partir de scripts/fixtures/seed-sqlite.sql à la première utilisation, ou SQLITE_PATH en désigne une.
Tests
tests/postgresparse de vrais plans capturés sur PostgreSQL 12, 17 et 18 (tests/fixtures/postgres). Chaque fixture contient le même plan en JSON et en texte, et les tests vérifient que les deux donnent le même arbre.tests/mysqlparse des plans capturés sur MySQL 5.7, 8.0.17, 8.0, 8.4 et 9.7 et MariaDB 10.4, 10.6 et 11.4 (tests/fixtures/mysql). Chaque fixture contient tous les formats disponibles sur son serveur pour une requête : arbre,EXPLAIN ANALYZE, les deux versions JSON, l’ANALYZEde MariaDB et le tableau classique. Les tests vérifient que les formats concordent.tests/sqliteparse les lignesEXPLAIN QUERY PLANde SQLite 3.16 (le format antérieur à 3.24), 3.27 et 3.45 (tests/fixtures/sqlite).tests/integrationexécute EXPLAIN sur des serveurs réels : PostgreSQL siPG_URLest défini, MySQL ou MariaDB siMYSQL_URLest défini, et SQLite toujours, via le module intégrénode:sqlitede Node.tests/statecouvre le comportement de l’onglet avec un hôte factice.
Pour capturer des fixtures sur une autre version de serveur, remplis-la puis lance son script de capture :
# PostgreSQL: seed with scripts/fixtures/seed.sql
PG_URL=postgres://... FIXTURE_PREFIX=pg16- node scripts/fixtures/capture-postgres.mjs
# MySQL or MariaDB: seed with scripts/fixtures/seed-mysql.sql; named after the server
MYSQL_URL=mysql://root:pw@127.0.0.1:3306/shop node scripts/fixtures/capture-mysql.mjs
# SQLite: uses Python's bundled SQLite, so older Python images give older SQLite
python3 scripts/fixtures/capture-sqlite.py
docker run --rm -v "$PWD:/w" -w /w python:3.6-stretch python3 scripts/fixtures/capture-sqlite.py
Comment ça marche
src/
  core/        database-neutral plan model, analysis, metrics, layout, formatting
  engines/     one adapter per database family, plus the registry
    postgres/  EXPLAIN builder, JSON and text parsers, timing rules, insights
    mysql/     version detection; tree, JSON (both versions) and table readers; insights
    sqlite/    EXPLAIN QUERY PLAN rows and shell text; insights
    shared/    helpers adapters build on: a configurable SQL lexer, statement
               checks, Explain Analyze policies, result readers, a JSON parser
               that keeps repeated keys
  host/        everything that talks to Beekeeper Studio
  state/       the tab's state and actions
  components/  Vue components: diagram, table, details, raw view
Chaque adaptateur convertit la sortie EXPLAIN de sa base dans le modèle Plan de src/core/plan.ts. Un PlanNode a un nom d’opération, un kind (scan, index, join, filter, sort…), des estimations optionnelles (totalCost, estimatedRows), des mesures optionnelles (actualRows, loops, temps), des valeurs dérivées inclusiveTime, exclusiveTime et exclusiveCost, ainsi que des conditions et des propriétés groupées pour le panneau de détails. Chaque métrique est optionnelle et l’UI n’affiche que ce que le moteur fournit : un plan SQLite n’a aucun chiffre, donc le tableau montre les détails de chaque étape au lieu des coûts.
Le temps propre dépend du moteur, c’est donc l’adaptateur qui le calcule. Les règles de PostgreSQL sont dans src/engines/postgres/timing.ts : les temps par boucle sont multipliés par le nombre de boucles, les workers parallèles comptent une seule fois, le temps d’une CTE est imputé aux scans de CTE qui la lisent, et celui d’un InitPlan au nœud qui l’évalue. MySQL donne aussi des temps par boucle et utilise le computeLoopTimings partagé (src/core/metrics.ts), en ajoutant au temps de la requête les sous-requêtes de la liste select, qu’il n’inclut pas. MariaDB mesure les tables et les requêtes entières, pas les étapes ; computeMixedTimings complète le reste.
Les trois formats de MySQL sont lus avec les mêmes noms d’opération : le texte en arbre et le JSON version 2 listent les mêmes itérateurs, et le JSON par bloc de requête (ainsi que le tableau classique, reconstruit dans ce format) devient une chaîne de jointures dans l’ordre des tables. Les règles d’insights s’appuient sur ces noms, pas sur la sortie native.
src/core/analysis.ts ajoute ce que tous les moteurs ont en commun : parts de temps et de coût, étapes les plus lentes et insights sur les erreurs d’estimation de lignes.
Ajouter une base de données
Rien à modifier en dehors du dossier du moteur et du registre.
- Crée
src/engines/<name>/avec un objet qui implémenteExplainEngine(src/engines/types.ts):connectionTypes: les types de connexion Beekeeper Studio qu’il gère, etproductss’il en couvre plusieurs (MySQL et MariaDB).inspect(sql, server): découpe et classe la requête (modifie-t-elle des données ?).src/engines/shared/lexer.tsprend un dialecte : styles de commentaires, guillemets, placeholders.analyzePolicy(statement, context): si Explain Analyze peut l’exécuter, quoi demander d’abord et quoi afficher sous l’éditeur.src/engines/shared/analyzePolicy.tscontient les politiques rollback et lecture seule.explain(request, runQuery): envoie le SQL dont la base a besoin et parse le résultat. Il peut appelerrunQueryplusieurs fois, par exemple pour se rabattre sur un format plus ancien.loadServerInfo(runQuery): la version, et tout ce que le moteur doit savoir d’autre (le mode SQL de MySQL). ÉtendsServerInfoavec tes propres champs.canParse/parse: lit la sortie collée et les valeurs de la grille de résultats. Le texte brut renvoyé par un parse doit redonner le même plan une fois reparsé : les onglets restaurés sont reconstruits à partir de lui.options: les options affichées dans le menu Options, chacune avecunavailable(server)quand elle nécessite un serveur plus récent.
- Associe les opérateurs natifs à des
NodeKindet renseigne les métriques disponibles. Utilise les helpers desrc/core/metrics.tspour les coûts et les temps quand ils conviennent, et appellefinishPlan()desrc/core/analysis.tsà la fin. - Enregistre-le dans
src/engines/registry.ts, ajoute des fixtures capturées sur de vrais serveurs (un script de capture dansscripts/fixtures/) et des tests comme les autres.
Notes pour SQL Server, qui est prévu :
- Le client SQL Server de Beekeeper Studio découpe une requête sur
;et peut exécuter chaque instruction sur une connexion différente du pool.SET SHOWPLAN_XML ONdoit être seul dans son batch et s’applique au batch suivant sur la même connexion : un plan estimé nécessite donc une nouvelle API hôte qui exécute les batchs sur une seule connexion. SET STATISTICS XML ONavec la requête dans un seul batch (sans;) donne le plan réel, mais exécute la requête et renvoie ses lignes au plugin.- Le XML de plan collé depuis SSMS (
.sqlplan) ne nécessite aucun support de l’hôte.
Publication
- Lance
bin/make-release.sh. Il propose la version suivante d’après les tags existants, définitversiondansmanifest.jsonetpackage.json, fait un commit et pousse un tag correspondant commev0.1.0. - Le workflow de release build, teste et crée une release GitHub en brouillon avec
manifest.jsonetexplain-visualizer-<version>.zip. Publie le brouillon.
yarn build && yarn package crée la même archive en local.
Licence
GPL-3.0. Voir LICENSE.