

Un plugin per Beekeeper Studio che trasforma i piani di esecuzione delle query in un diagramma interattivo, così trovare la parte lenta di una query è facile.
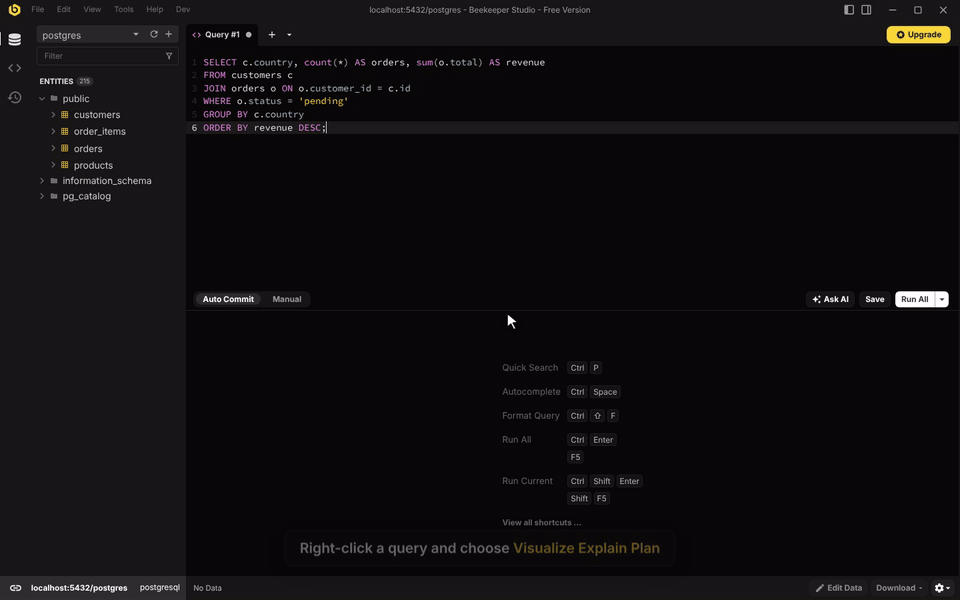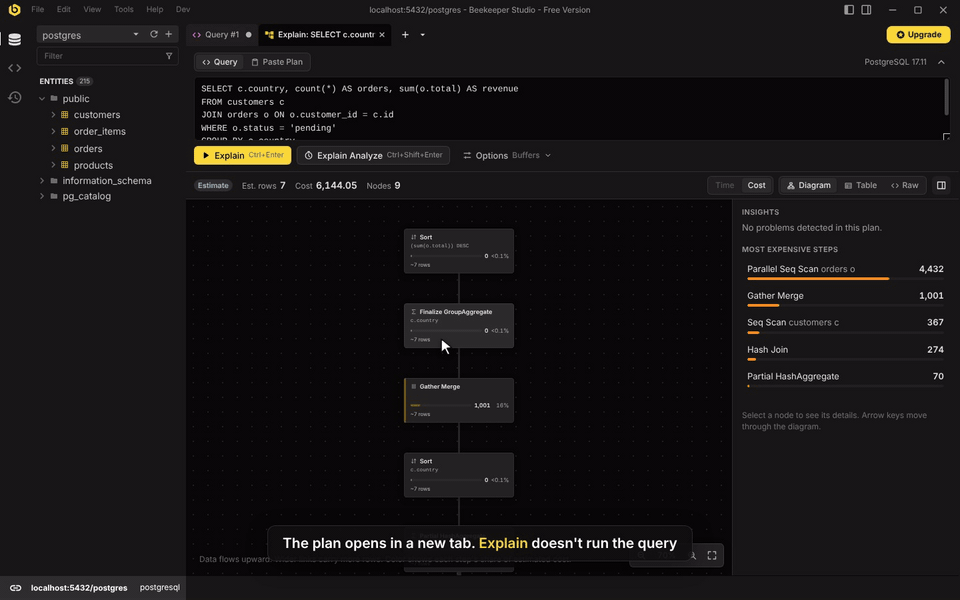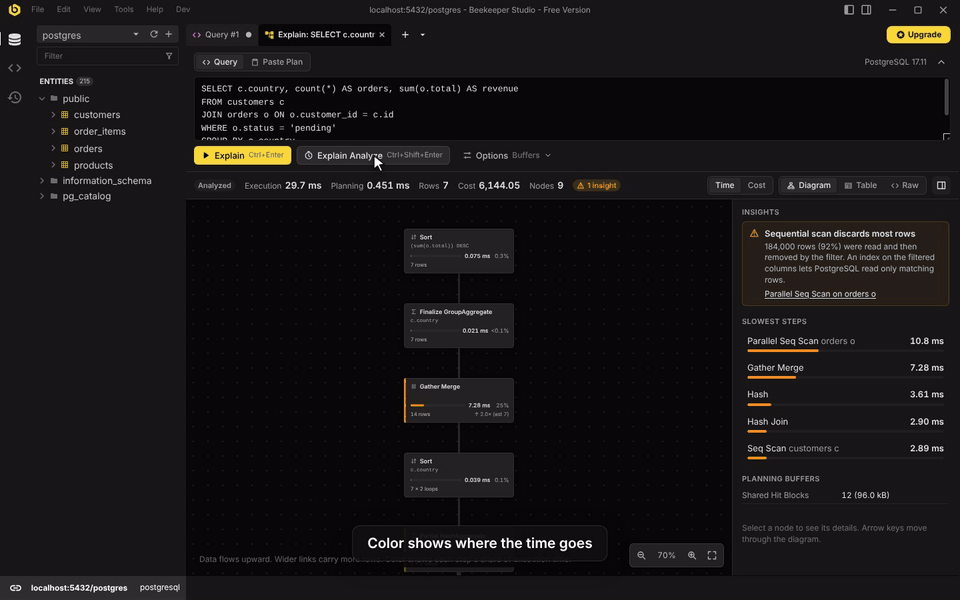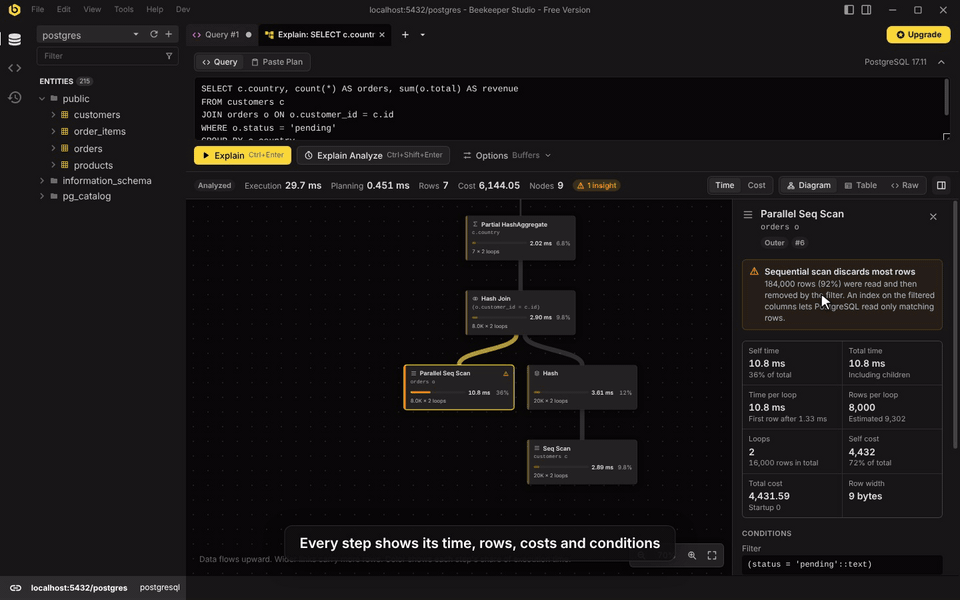
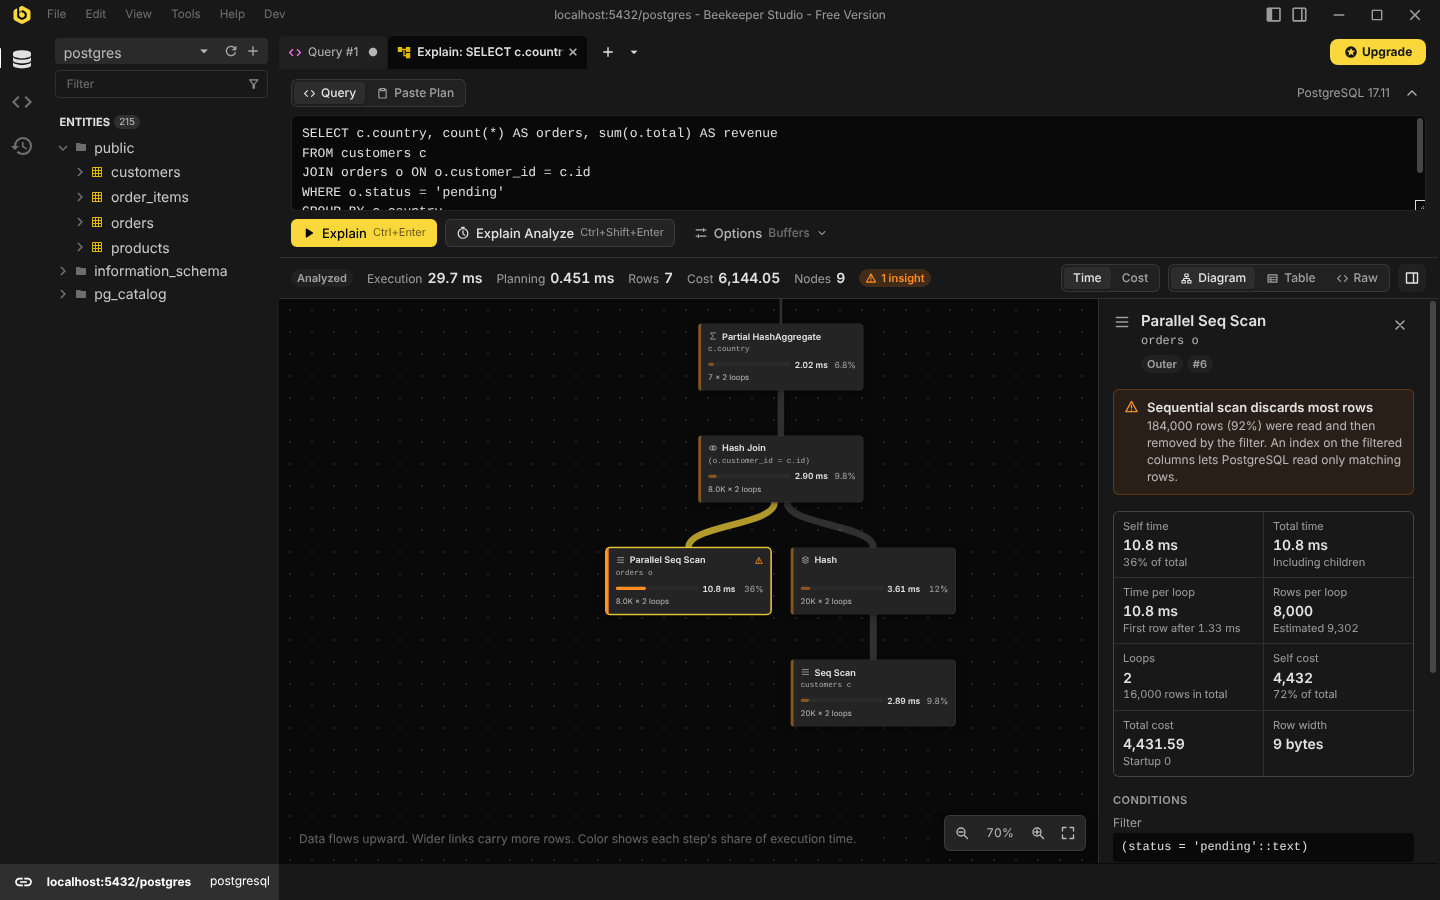
- Diagramma del piano, colorato in base alla quota del tempo di esecuzione (o del costo stimato) di ogni passaggio. I collegamenti più larghi trasportano più righe.
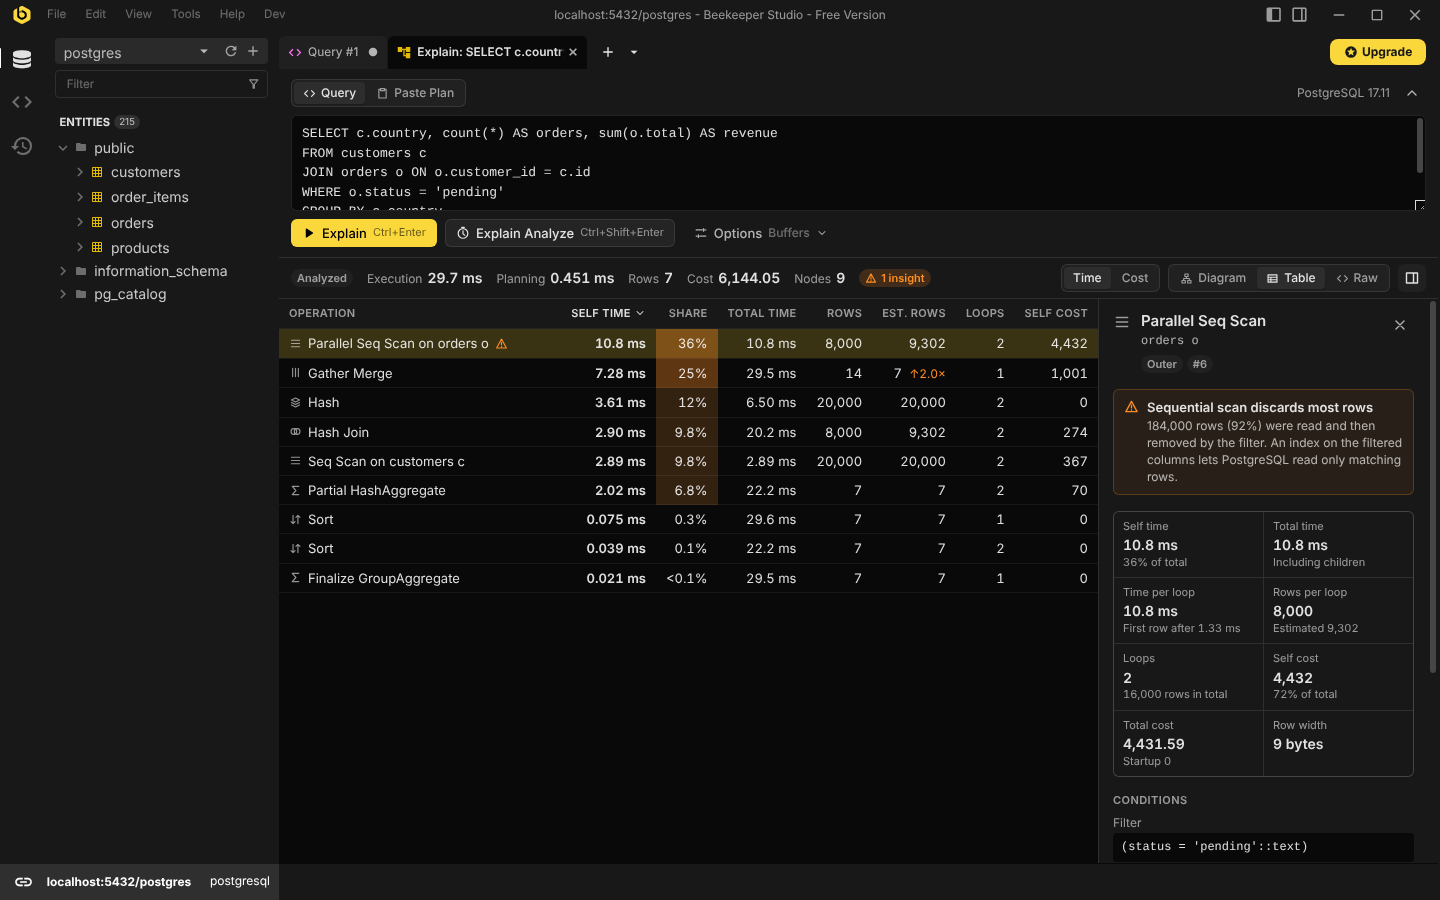
- Vista a tabella nello stile di
explain.depesz.com, ordinabile per tempo proprio. - Dettagli per ogni passaggio: tempo proprio e totale, righe effettive vs. stimate, loop, costi, condizioni, buffer, uso di memoria e disco, worker.
- Suggerimenti che segnalano i problemi più comuni: scansioni complete che scartano la maggior parte delle righe, tabelle scansionate una volta per ogni riga di una join, ordinamenti e hash che finiscono su disco, subquery dipendenti, indici temporanei che SQLite crea a ogni esecuzione, grandi errori di stima delle righe e altro.
- Output grezzo del piano, pronto da copiare o salvare.
Altro negli screenshot qui sotto.
Database supportati
| Database | Explain | Explain Analyze | Incolla un piano |
|---|---|---|---|
| PostgreSQL | Sì | Sì | JSON e testo di psql |
| MySQL | Sì | 8.0.18+, istruzioni di lettura | Tree, JSON (entrambe le versioni) e la tabella classica |
| MariaDB | Sì | 10.1+, istruzioni di lettura | JSON e la tabella classica |
| SQLite, LibSQL | Sì | No: SQLite non ha tempi per passaggio | L'albero della shell sqlite3, o le righe del risultato |
| SQL Server | Pianificato |
Testato con PostgreSQL 12, 17 e 18; MySQL 5.7, 8.0.17, 8.0, 8.4 e 9.7; MariaDB 10.4, 10.6 e 11.4; e SQLite 3.16, 3.27 e 3.45. Il plugin è costruito attorno a un modello di piano indipendente dal database, quindi ogni database ha bisogno solo di un adapter (vedi Aggiungere un database).
Come usarlo
Ci sono diversi modi per iniziare:
- Editor di query: fai clic destro su una query e scegli Visualize Explain Plan. Viene usato il testo selezionato, o l'istruzione sotto il cursore.
- Menu nuova scheda: apri Explain Visualizer, scrivi un'istruzione e scegli Explain o Explain Analyze.
- Griglia dei risultati: dopo aver eseguito EXPLAIN da te, fai clic destro sul piano e scegli Visualize Explain Plan:
- un piano in una cella (
FORMAT JSONdi PostgreSQL, tree o JSON di MySQL): fai clic destro sulla cella; - un piano distribuito su più righe (l'output testuale di PostgreSQL): fai clic destro sull'intestazione della colonna
QUERY PLAN; - una tabella (l'
EXPLAINclassico di MySQL, l'EXPLAIN QUERY PLANdi SQLite): seleziona tutte le righe e colonne, poi fai clic destro sulla selezione. Per SQLite funziona anche la sola colonna detail, senza l'annidamento.
- un piano in una cella (
- Paste Plan: incolla l'output di EXPLAIN, ad esempio da psql, dalla shell mysql o sqlite3, o da un collega.
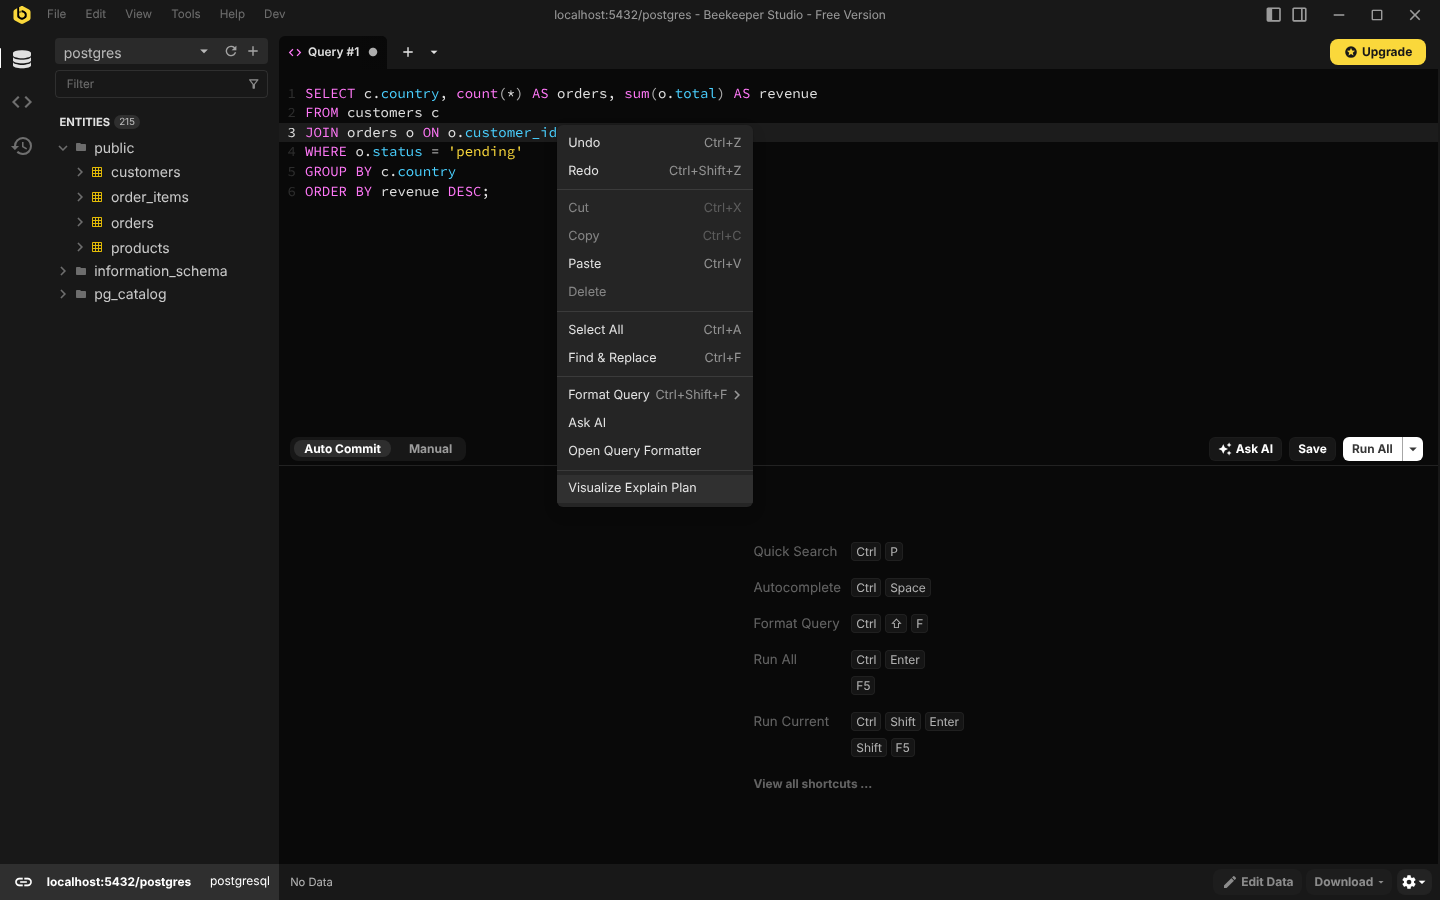
Explain ed Explain Analyze
Explain chiede al database il suo piano senza eseguire l'istruzione. È sempre sicuro, quindi viene eseguito automaticamente quando la scheda si apre dall'editor.
Explain Analyze esegue l'istruzione e misura ogni passaggio. Come resta sicuro dipende dal database, vedi sotto. Se il testo nell'editor inizia già con EXPLAIN ANALYZE (o l'equivalente del database), il plugin lo usa; quando l'istruzione non può essere analizzata viene invece eseguito l'explain, e il motivo è mostrato sotto l'editor.
PostgreSQL
Il plugin invia EXPLAIN ANALYZE ...; ROLLBACK; come singola richiesta, così entrambe le istruzioni condividono una transazione implicita e tutto ciò che l'istruzione ha modificato viene annullato. Questo vale anche per le semplici SELECT, che possono chiamare funzioni che scrivono. Se l'istruzione fallisce, la transazione viene interrotta da sola e la connessione del pool resta pulita. Gli effetti esterni alla transazione, come i valori delle sequence, non vengono annullati.
Le istruzioni che modificano i dati (INSERT, UPDATE, DELETE, MERGE, CTE che modificano dati…) vengono analizzate solo dopo una conferma. Il plugin legge l'istruzione con un lexer che segue le regole di PostgreSQL per stringhe, commenti e dollar quote, e rifiuta input che contengono più di un'istruzione.
Sulle connessioni in sola lettura Beekeeper Studio non consente il ROLLBACK, quindi per le istruzioni che modificano i dati è possibile solo l'explain, ed Explain Analyze non parte mai automaticamente. Una SELECT che chiama una funzione che scrive non viene rilevata, esattamente come quando la esegui in una scheda query.
Il menu Options attiva o disattiva BUFFERS, VERBOSE, SETTINGS e WAL. Le opzioni non supportate dal server sono disabilitate. Le istruzioni con parametri $1 vengono spiegate con GENERIC_PLAN su PostgreSQL 16+.
MySQL e MariaDB
Il plugin legge la versione del server e usa il formato di piano più recente disponibile:
| Server | Explain | Explain Analyze |
|---|---|---|
| MySQL 8.0.18+ | EXPLAIN FORMAT=TREE |
EXPLAIN ANALYZE |
| MySQL da 5.6 a 8.0.17 | EXPLAIN FORMAT=JSON |
Non disponibile |
| MariaDB 10.1+ | EXPLAIN FORMAT=JSON |
ANALYZE FORMAT=JSON |
| Server più vecchi | La tabella EXPLAIN classica |
Non disponibile |
UPDATE e DELETE su una sola tabella non hanno un tree; il plugin ripiega su FORMAT=JSON e, su MySQL 9, il cui JSON non riesce a mostrarli, sulla tabella classica. TiDB viene riconosciuto e rifiutato invece di essere interpretato male.
Explain Analyze esegue solo istruzioni di lettura. A differenza di PostgreSQL, non si può contare su MySQL per annullare una richiesta fallita: inviata come START TRANSACTION; ...; ROLLBACK;, un'istruzione fallita lascerebbe la transazione aperta su una connessione del pool usata poi da altre schede. Una SELECT che chiama una stored function che scrive esegue il commit di ciò che la funzione ha fatto, come quando la esegui in una scheda query. Su MariaDB, la modalità sola lettura di Beekeeper Studio rifiuta l'istruzione ANALYZE, quindi Explain Analyze non è disponibile sulle connessioni in sola lettura.
L'istruzione viene letta con le regole di MySQL: commenti # e -- che terminano solo a un line feed, escape con backslash, stringhe "..." e commenti /*! ... */, il cui contenuto viene eseguito da MySQL. NO_BACKSLASH_ESCAPES e ANSI_QUOTES cambiano il modo in cui terminano le stringhe, e una connessione del pool può avere l'una o l'altra, quindi un'istruzione deve risultare un'unica istruzione, e di lettura, con ogni loro combinazione. Il testo che un server può interpretare in più modi viene rifiutato invece di tirare a indovinare: un commento /*!50700 ... */ legato alla versione o /*M! ... */ solo per MariaDB, un carriage return dentro un commento --, o un carattere NUL.
MariaDB misura il tempo per ogni tabella anziché per ogni passaggio, quindi il tempo di una join o di una tabella temporanea è quanto la query ha impiegato oltre alle tabelle lette.
SQLite
EXPLAIN QUERY PLAN mostra quali tabelle vengono lette, in che ordine e con quale indice. SQLite non riporta costi, conteggi di righe o tempi, quindi il diagramma mostra i passaggi e la vista a tabella i loro dettagli, e non c'è Explain Analyze. I suggerimenti segnalano gli indici temporanei che SQLite crea a ogni esecuzione, le tabelle scansionate una volta per ogni riga di una join o di una subquery correlata, e gli ordinamenti in un B-tree temporaneo. Le connessioni LibSQL usano lo stesso motore.
Beekeeper Studio divide il testo SQLite in istruzioni con il proprio parser prima di eseguirle, quindi un'istruzione con un punto e virgola al suo interno (in una stringa, un nome o un commento) viene rifiutata: nessuno splitter può allora trovarci una seconda istruzione.
Screenshot
Explain Analyze, con il passaggio lento selezionato e un suggerimento al riguardo:
Lo stesso piano come tabella, ordinato per tempo proprio:
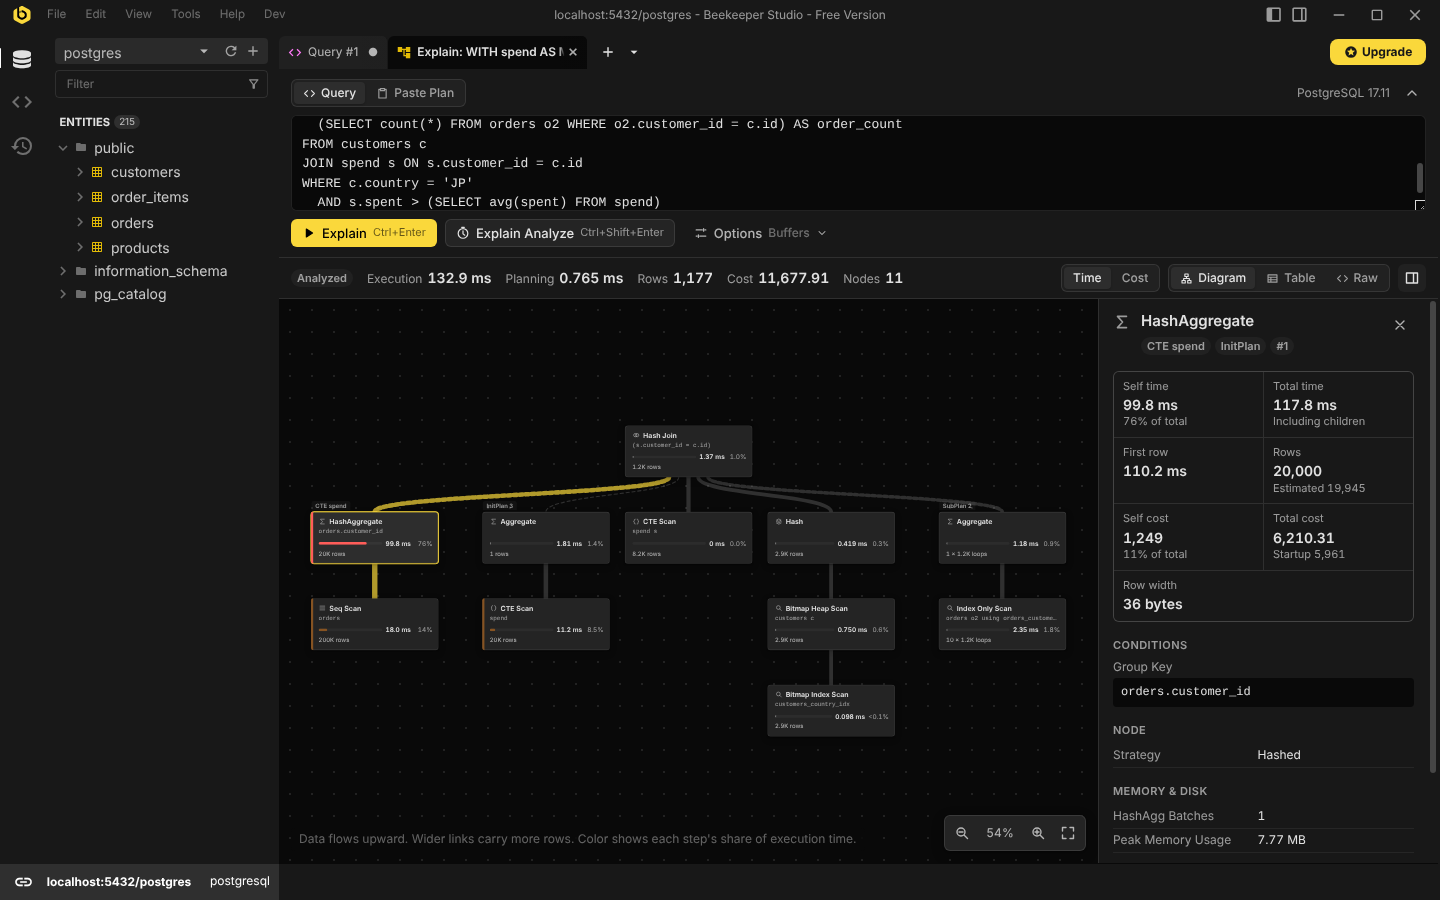
Una query con una CTE, un InitPlan e un SubPlan, ognuno mostrato come ramo separato:
Il plugin segue il tema di Beekeeper Studio:
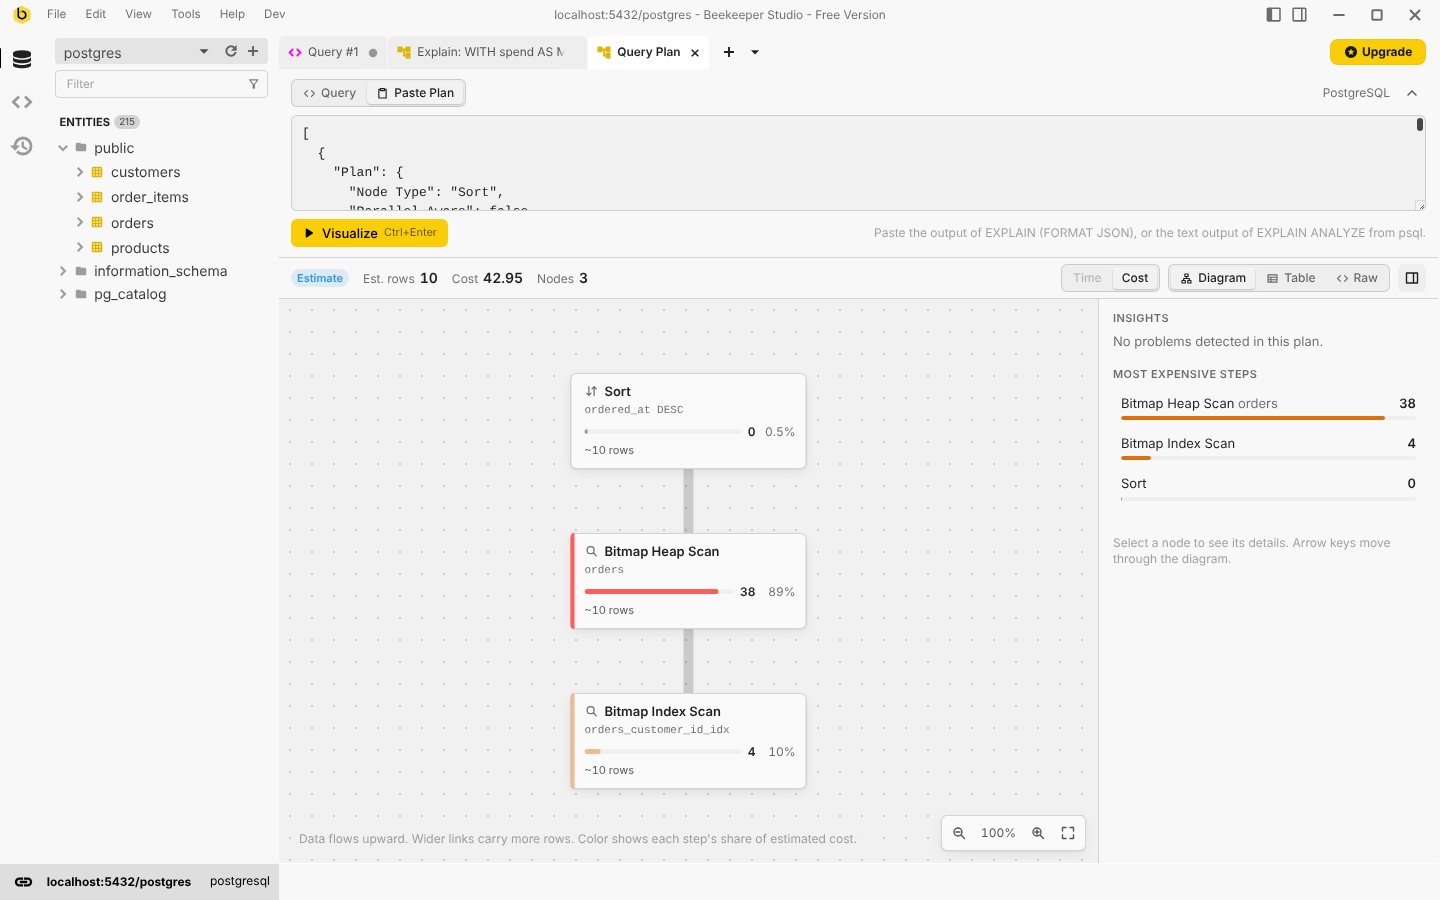
Sviluppo
Richiede Node.js 22+ e Yarn 1.
yarn install
yarn dev        # builds with hot reload and links the plugin into Beekeeper Studio
yarn test       # unit tests
yarn build      # type-check and build into dist/
yarn dev usa @beekeeperstudio/vite-plugin, che crea un symlink di questa cartella nella directory dei plugin di Beekeeper Studio.
Per impostazione predefinita Beekeeper Studio carica solo i propri plugin in allow-list. Per caricare questo, aggiungi quanto segue al tuo file di configurazione utente e riavvia l'app:
[pluginSystem]
disabled = false
Poi connettiti a un database: Visualize Explain Plan compare nel menu contestuale dell'editor di query ed Explain Visualizer nel menu nuova scheda.
Harness
dev/harness.html fa le veci di Beekeeper Studio: carica il plugin in un iframe e risponde alle sue richieste con gli stessi messaggi usati dall'app, eseguendo query su database reali. È il modo più rapido per lavorare sulla UI, provare tutti i modi in cui la scheda può essere aperta, cambiare database e cambiare tema.
docker run -d --name pg -e POSTGRES_PASSWORD=pw -p 5432:5432 postgres:17
psql postgres://postgres:pw@localhost:5432/postgres -f scripts/fixtures/seed.sql

docker run -d --name mysql -e MYSQL_ROOT_PASSWORD=pw -e MYSQL_DATABASE=shop -p 3306:3306 mysql:8.4
mysql -h127.0.0.1 -uroot -ppw shop < scripts/fixtures/seed-mysql.sql

PG_URL=postgres://postgres:pw@localhost:5432/postgres \
MYSQL_URL=mysql://root:pw@127.0.0.1:3306/shop \
yarn harness
MARIADB_URL punta il MariaDB dell'harness a un altro server (altrimenti usa MYSQL_URL). SQLite non richiede nulla: un database temporaneo viene popolato da scripts/fixtures/seed-sqlite.sql al primo utilizzo, oppure SQLITE_PATH ne indica uno.
Test
tests/postgresanalizza piani reali catturati da PostgreSQL 12, 17 e 18 (tests/fixtures/postgres). Ogni fixture contiene lo stesso piano in formato JSON e testo, e i test verificano che entrambi producano lo stesso albero.tests/mysqlanalizza piani catturati da MySQL 5.7, 8.0.17, 8.0, 8.4 e 9.7 e MariaDB 10.4, 10.6 e 11.4 (tests/fixtures/mysql). Ogni fixture contiene tutti i formati che il suo server offre per un'istruzione: tree,EXPLAIN ANALYZE, entrambe le versioni JSON, l'ANALYZEdi MariaDB e la tabella classica. I test verificano che i formati concordino.tests/sqliteanalizza le righe diEXPLAIN QUERY PLANda SQLite 3.16 (il formato precedente alla 3.24), 3.27 e 3.45 (tests/fixtures/sqlite).tests/integrationesegue EXPLAIN su server attivi: PostgreSQL quando è impostatoPG_URL, MySQL o MariaDB quando è impostatoMYSQL_URL, e SQLite sempre, tramite il modulo integrato di Nodenode:sqlite.tests/statecopre il comportamento della scheda con un host fittizio.
Per catturare fixture da un'altra versione del server, popolalo ed esegui il suo script di cattura:
# PostgreSQL: seed with scripts/fixtures/seed.sql
PG_URL=postgres://... FIXTURE_PREFIX=pg16- node scripts/fixtures/capture-postgres.mjs
# MySQL or MariaDB: seed with scripts/fixtures/seed-mysql.sql; named after the server
MYSQL_URL=mysql://root:pw@127.0.0.1:3306/shop node scripts/fixtures/capture-mysql.mjs
# SQLite: uses Python's bundled SQLite, so older Python images give older SQLite
python3 scripts/fixtures/capture-sqlite.py
docker run --rm -v "$PWD:/w" -w /w python:3.6-stretch python3 scripts/fixtures/capture-sqlite.py
Come funziona
src/
  core/        database-neutral plan model, analysis, metrics, layout, formatting
  engines/     one adapter per database family, plus the registry
    postgres/  EXPLAIN builder, JSON and text parsers, timing rules, insights
    mysql/     version detection; tree, JSON (both versions) and table readers; insights
    sqlite/    EXPLAIN QUERY PLAN rows and shell text; insights
    shared/    helpers adapters build on: a configurable SQL lexer, statement
               checks, Explain Analyze policies, result readers, a JSON parser
               that keeps repeated keys
  host/        everything that talks to Beekeeper Studio
  state/       the tab's state and actions
  components/  Vue components: diagram, table, details, raw view
Ogni adapter converte l'output di EXPLAIN del proprio database nel modello Plan in src/core/plan.ts. Un PlanNode ha un nome di operazione, un kind (scan, index, join, filter, sort…), stime opzionali (totalCost, estimatedRows), misurazioni opzionali (actualRows, loops, tempi), i valori derivati inclusiveTime, exclusiveTime ed exclusiveCost, oltre a condizioni e proprietà raggruppate per il pannello dei dettagli. Ogni metrica è opzionale e la UI mostra solo ciò che un motore fornisce: un piano SQLite non ha numeri, quindi la tabella mostra i dettagli di ogni passaggio al posto dei costi.
Il tempo proprio dipende dal motore, quindi lo calcola l'adapter. Le regole di PostgreSQL stanno in src/engines/postgres/timing.ts: i tempi per loop vengono moltiplicati per i loop, i worker paralleli vengono contati una sola volta, il tempo delle CTE viene attribuito alle scansioni CTE che le leggono e il tempo di un InitPlan al nodo che lo valuta. Anche MySQL riporta i tempi per loop e usa il computeLoopTimings condiviso (src/core/metrics.ts), con le subquery nella select list aggiunte sopra la query, che non le include. MariaDB misura tabelle e query intere, non passaggi; computeMixedTimings completa il resto.
I tre formati di MySQL vengono letti con gli stessi nomi di operazione: il testo tree e il JSON versione 2 elencano gli stessi iteratori, e il JSON a query block (e la tabella classica, ricostruita in esso) diventa una catena di join nell'ordine delle tabelle. Le regole dei suggerimenti lavorano su questi nomi, non sull'output nativo.
src/core/analysis.ts aggiunge ciò che tutti i motori condividono: quote di tempo e costo, i passaggi più lenti e i suggerimenti sugli errori di stima delle righe.
Aggiungere un database
Non serve modificare nulla al di fuori della cartella del motore e del registry.
- Crea
src/engines/<name>/con un oggetto che implementaExplainEngine(src/engines/types.ts):connectionTypes: i tipi di connessione di Beekeeper Studio che gestisce, eproductsquando ne copre diversi (MySQL e MariaDB).inspect(sql, server): divide e classifica l'istruzione (modifica i dati?).src/engines/shared/lexer.tsaccetta un dialetto: stili di commento, virgolette, placeholder.analyzePolicy(statement, context): se Explain Analyze può eseguirla, cosa chiedere prima e cosa mostrare sotto l'editor.src/engines/shared/analyzePolicy.tscontiene le policy di rollback e di sola lettura.explain(request, runQuery): invia l'SQL di cui il database ha bisogno e analizza il risultato. Può chiamarerunQuerypiù volte, ad esempio per ripiegare su un formato più vecchio.loadServerInfo(runQuery): la versione e qualsiasi altra cosa il motore debba sapere (l'SQL mode di MySQL). EstendiServerInfocon i tuoi campi.canParse/parse: leggono l'output incollato e i valori dalla griglia dei risultati. Il testo grezzo restituito da un parse deve produrre di nuovo lo stesso piano: le schede ripristinate vengono ricostruite da esso.options: opzioni mostrate nel menu Options, ciascuna conunavailable(server)quando richiede un server più recente.
- Mappa gli operatori nativi sui
NodeKinde compila le metriche disponibili. Usa gli helper insrc/core/metrics.tsper costi e tempi quando servono, e chiamafinishPlan()dasrc/core/analysis.tsalla fine. - Registralo in
src/engines/registry.ts, aggiungi fixture catturate da server reali (uno script di cattura inscripts/fixtures/) e test come gli altri.
Note per SQL Server, che è pianificato:
- Il client SQL Server di Beekeeper Studio divide una richiesta su
;e può eseguire ogni istruzione su una connessione del pool diversa.SET SHOWPLAN_XML ONdeve stare da solo nel suo batch e si applica al batch successivo sulla stessa connessione, quindi un piano stimato richiede una nuova API host che esegua i batch su una sola connessione. SET STATISTICS XML ONcon l'istruzione in un unico batch (senza;) fornisce il piano effettivo, ma esegue l'istruzione e restituisce le sue righe al plugin.- L'XML del piano incollato da SSMS (
.sqlplan) non richiede supporto dall'host.
Rilascio
- Esegui
bin/make-release.sh. Suggerisce la prossima versione in base ai tag esistenti, impostaversioninmanifest.jsonepackage.json, fa il commit e pubblica un tag corrispondente comev0.1.0. - Il workflow di rilascio compila, testa e crea una bozza di release su GitHub con
manifest.jsoneexplain-visualizer-<version>.zip. Pubblica la bozza.
yarn build && yarn package crea lo stesso archivio in locale.
Licenza
GPL-3.0. Vedi LICENSE.