

쿼리 실행 계획을 인터랙티브 다이어그램으로 바꿔 쿼리의 느린 부분을 쉽게 찾을 수 있게 해 주는 Beekeeper Studio 플러그인이에요.
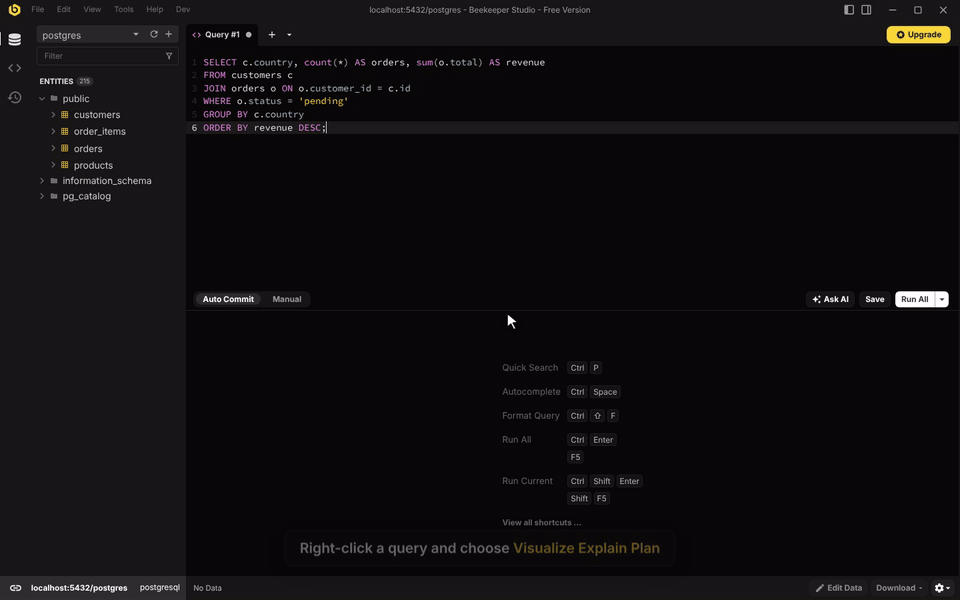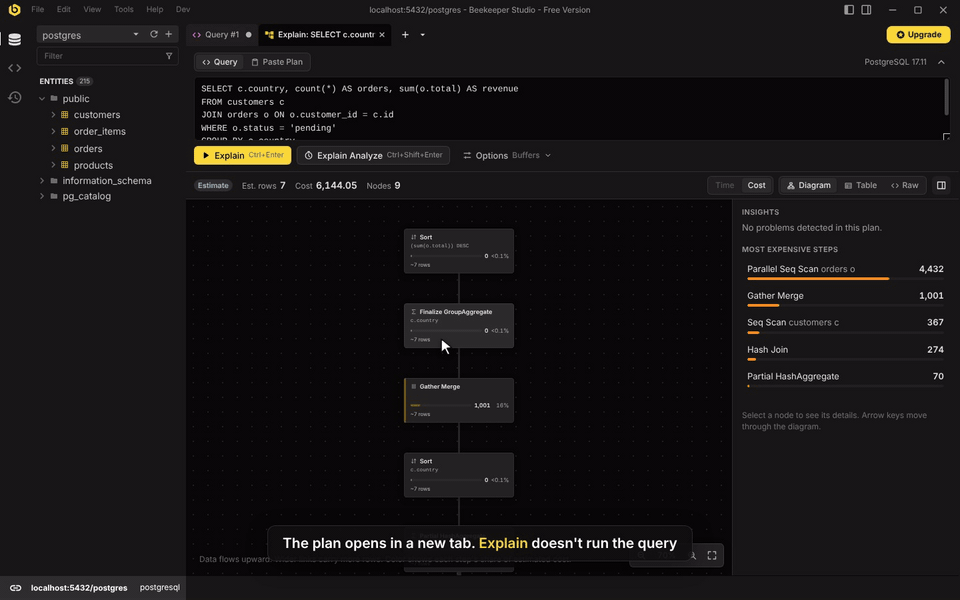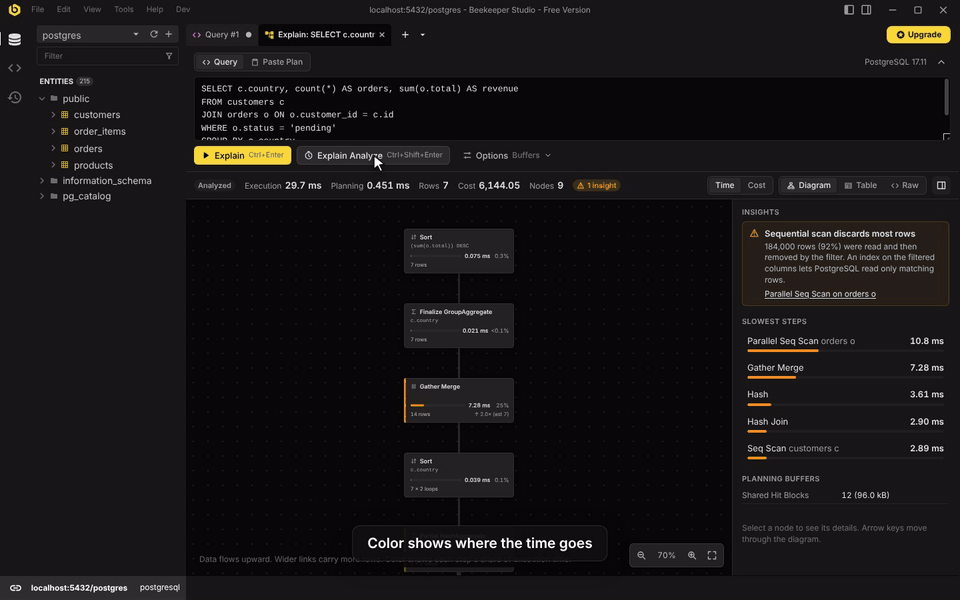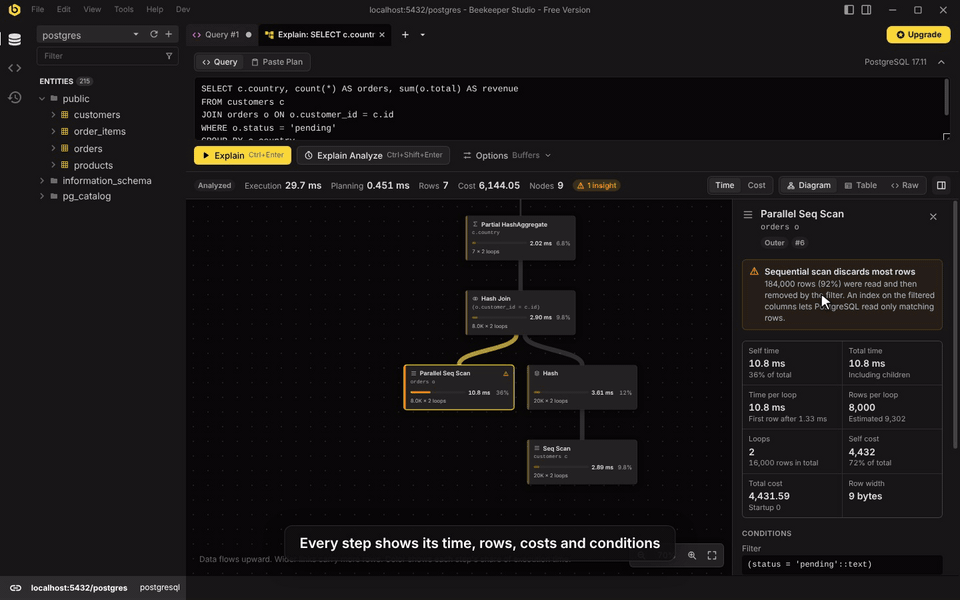
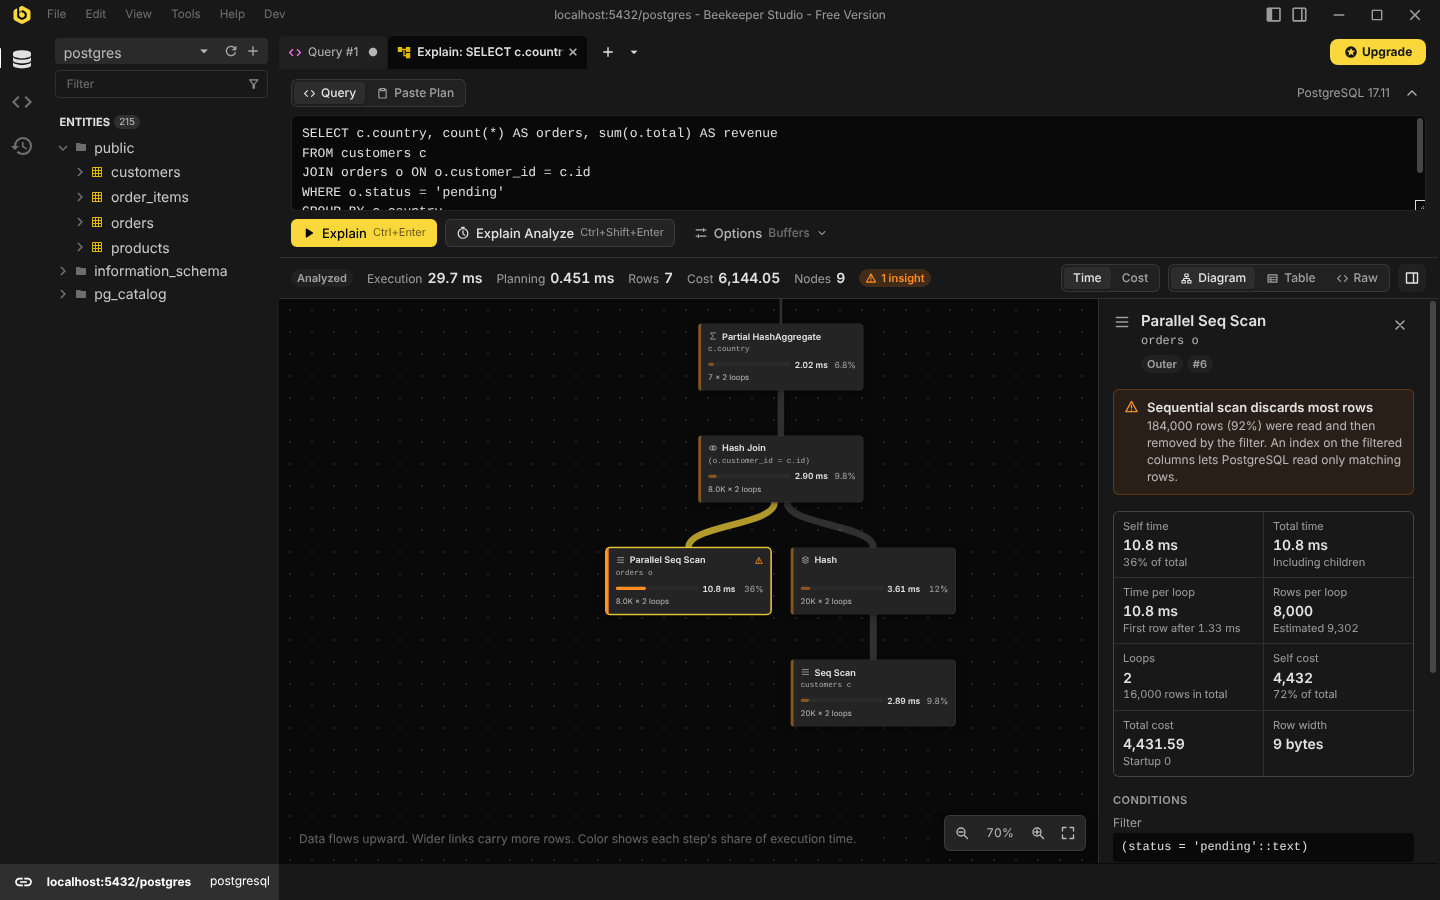
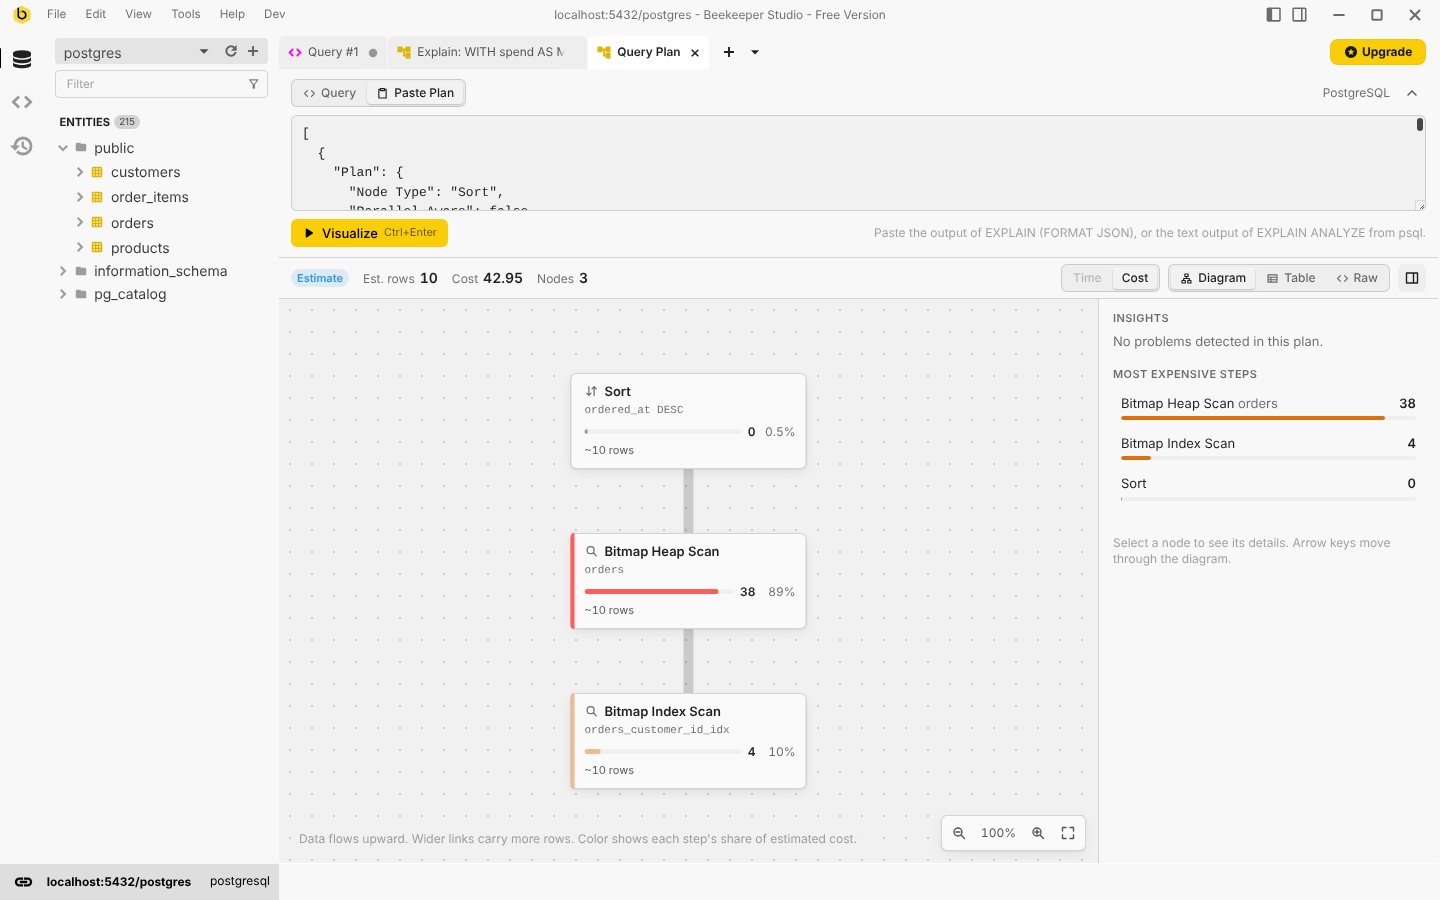
- 계획의 다이어그램: 각 단계가 전체 실행 시간(또는 예상 비용)에서 차지하는 비중에 따라 색이 칠해져요. 연결선이 넓을수록 더 많은 행이 흘러요.
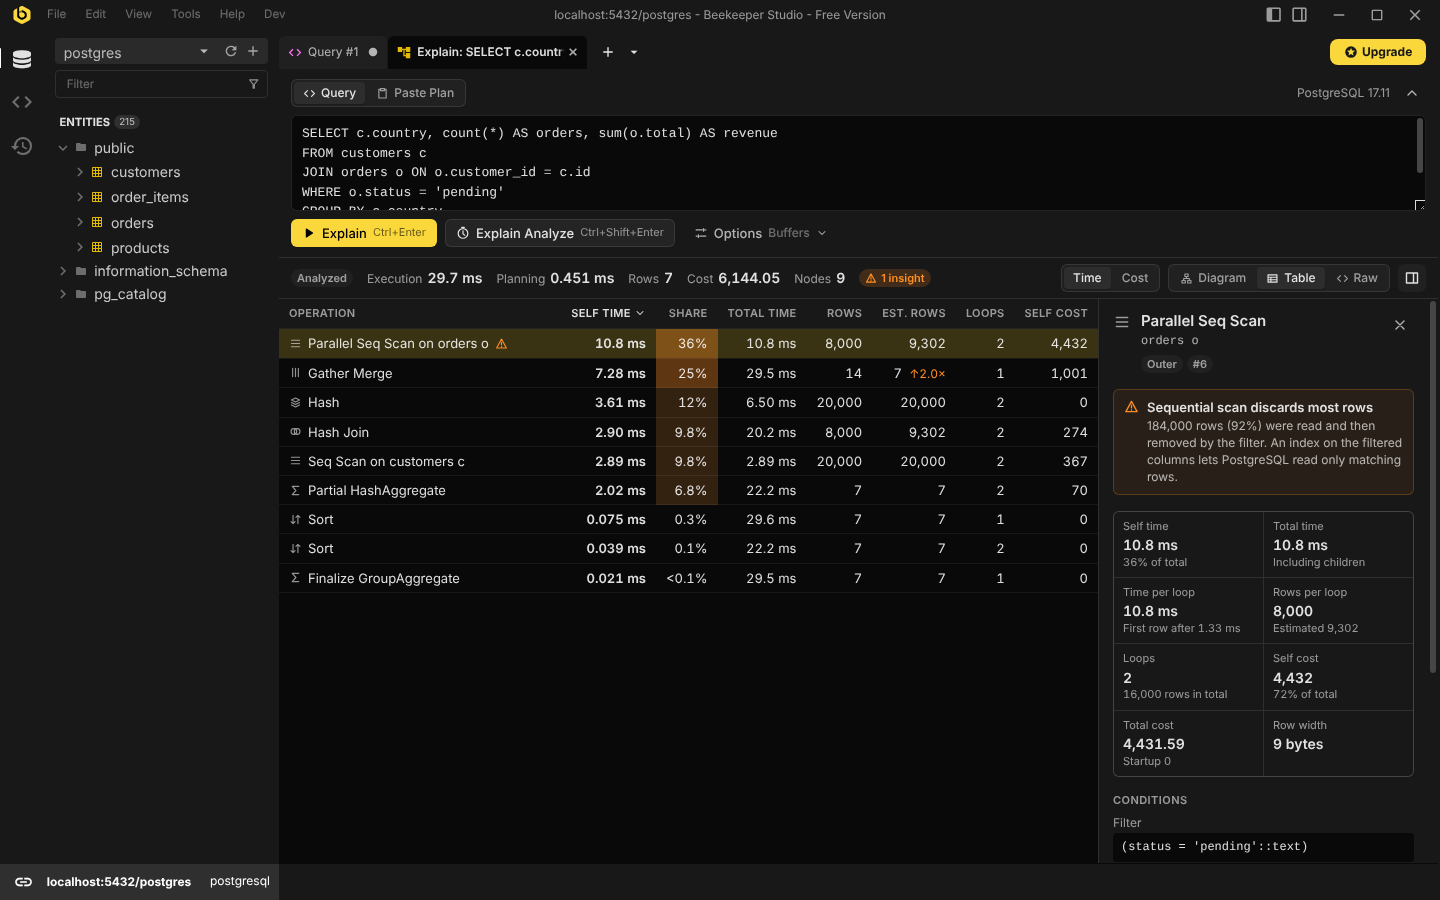
explain.depesz.com스타일의 테이블 뷰로, 자체 시간 기준으로 정렬할 수 있어요.- 모든 단계의 상세 정보: 자체 시간과 전체 시간, 실제 행 수와 예상 행 수, 루프, 비용, 조건, 버퍼, 메모리 및 디스크 사용량, 워커.
- 흔한 문제를 짚어 주는 인사이트: 대부분의 행을 버리는 전체 스캔, 조인의 행마다 반복되는 테이블 스캔, 디스크로 넘치는 정렬과 해시, 종속 서브쿼리, SQLite가 실행할 때마다 만드는 임시 인덱스, 크게 빗나간 행 수 추정 등.
- 원본 계획 출력으로, 바로 복사하거나 저장할 수 있어요.
아래 스크린샷에서 더 볼 수 있어요.
지원 데이터베이스
| 데이터베이스 | Explain | Explain Analyze | 계획 붙여넣기 |
|---|---|---|---|
| PostgreSQL | 예 | 예 | JSON 및 psql 텍스트 |
| MySQL | 예 | 8.0.18+, 읽기 구문 | 트리, JSON(두 버전 모두), 기존 테이블 형식 |
| MariaDB | 예 | 10.1+, 읽기 구문 | JSON 및 기존 테이블 형식 |
| SQLite, LibSQL | 예 | 아니요: SQLite는 단계별 시간을 제공하지 않아요 | sqlite3 셸의 트리 또는 결과 행 |
| SQL Server | 예정 |
PostgreSQL 12, 17, 18, MySQL 5.7, 8.0.17, 8.0, 8.4, 9.7, MariaDB 10.4, 10.6, 11.4, SQLite 3.16, 3.27, 3.45에서 테스트했어요. 이 플러그인은 데이터베이스에 독립적인 계획 모델을 기반으로 만들어져서, 데이터베이스마다 어댑터만 있으면 돼요(데이터베이스 추가하기 참고).
사용 방법
여는 방법은 여러 가지예요:
- 쿼리 편집기: 쿼리를 오른쪽 클릭하고 Visualize Explain Plan을 선택하세요. 선택한 텍스트나 커서 아래의 구문이 사용돼요.
- 새 탭 메뉴: Explain Visualizer를 열고 구문을 작성한 뒤 Explain 또는 Explain Analyze를 선택하세요.
- 결과 그리드: 직접 EXPLAIN을 실행한 뒤 계획을 오른쪽 클릭하고 다음을 선택하세요 Visualize Explain Plan:
- 한 셀에 담긴 계획(PostgreSQL의
FORMAT JSON, MySQL의 트리 또는 JSON): 셀을 오른쪽 클릭하세요. - 여러 행에 걸친 계획(PostgreSQL의 텍스트 출력):
QUERY PLAN열 헤더를 오른쪽 클릭하세요. - 테이블 형식(MySQL의 기존
EXPLAIN, SQLite의EXPLAIN QUERY PLAN): 모든 행과 열을 선택한 뒤 선택 영역을 오른쪽 클릭하세요. SQLite는 detail 열만 선택해도 동작하지만, 중첩 구조는 표시되지 않아요.
- 한 셀에 담긴 계획(PostgreSQL의
- Paste Plan: psql, mysql 또는 sqlite3 셸, 동료 등에게서 받은 EXPLAIN 출력을 붙여넣으세요.
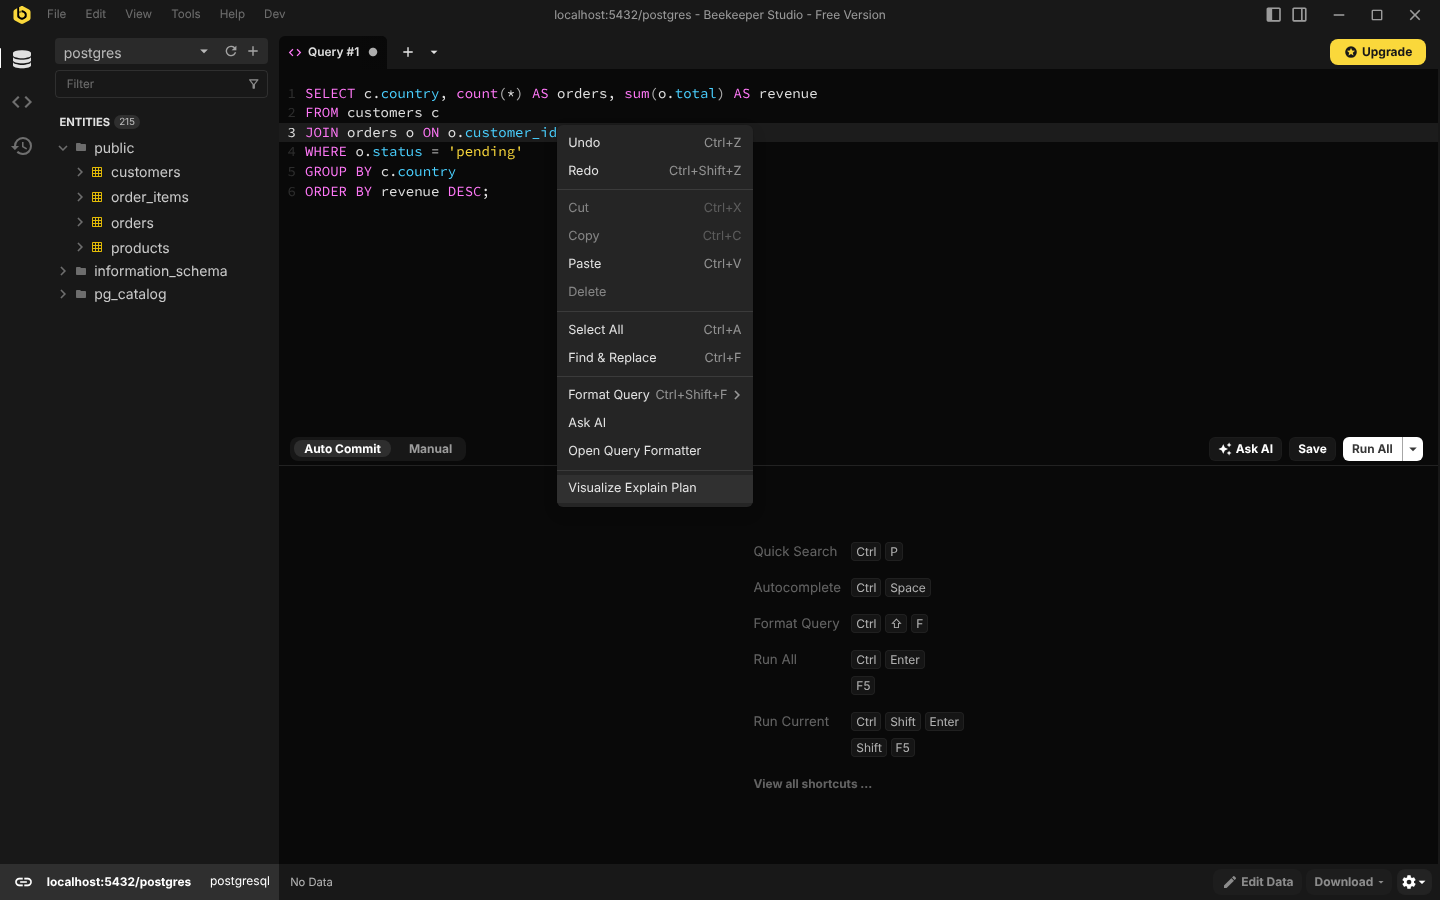
Explain과 Explain Analyze
Explain은 구문을 실행하지 않고 데이터베이스에 계획만 요청해요. 항상 안전하기 때문에 편집기에서 탭을 열면 자동으로 실행돼요.
Explain Analyze는 구문을 실행하고 모든 단계를 측정해요. 이를 안전하게 처리하는 방식은 아래와 같이 데이터베이스마다 달라요. 편집기 텍스트가 이미 EXPLAIN ANALYZE(또는 해당 데이터베이스의 동등한 구문)로 시작하면 플러그인이 그대로 사용해요. 구문을 분석할 수 없으면 대신 Explain을 실행하고, 그 이유를 편집기 아래에 표시해요.
PostgreSQL
플러그인은 EXPLAIN ANALYZE ...; ROLLBACK;을 하나의 요청으로 보내요. 그래서 두 구문이 하나의 암시적 트랜잭션을 공유하고, 구문이 변경한 내용은 모두 롤백돼요. 쓰기를 하는 함수를 호출할 수 있는 일반 SELECT도 마찬가지예요. 구문이 실패하면 트랜잭션은 자동으로 중단되고 풀의 연결은 깨끗한 상태로 남아요. 시퀀스 값처럼 트랜잭션 밖에서 일어난 효과는 되돌려지지 않아요.
데이터를 변경하는 구문(INSERT, UPDATE, DELETE, MERGE, 데이터 변경 CTE 등)은 확인을 받은 뒤에만 분석해요. 플러그인은 문자열, 주석, 달러 인용에 대한 PostgreSQL 자체 규칙을 따르는 렉서로 구문을 읽고, 구문이 둘 이상 들어 있는 입력은 거부해요.
읽기 전용 연결에서는 Beekeeper Studio가 ROLLBACK을 허용하지 않기 때문에, 데이터를 변경하는 구문은 Explain만 할 수 있고 Explain Analyze는 자동으로 실행되지 않아요. 쓰기를 하는 함수를 호출하는 SELECT는 여기서 감지되지 않는데, 쿼리 탭에서 실행할 때와 같아요.
Options 메뉴에서 BUFFERS, VERBOSE, SETTINGS, WAL을 켜고 끌 수 있어요. 서버가 지원하지 않는 옵션은 비활성화돼요. $1 파라미터가 있는 구문은 PostgreSQL 16+에서 GENERIC_PLAN으로 Explain해요.
MySQL 및 MariaDB
플러그인은 서버 버전을 읽고, 지원되는 가장 최신 계획 형식을 사용해요:
| 서버 | Explain | Explain Analyze |
|---|---|---|
| MySQL 8.0.18+ | EXPLAIN FORMAT=TREE |
EXPLAIN ANALYZE |
| MySQL 5.6 ~ 8.0.17 | EXPLAIN FORMAT=JSON |
사용 불가 |
| MariaDB 10.1+ | EXPLAIN FORMAT=JSON |
ANALYZE FORMAT=JSON |
| 이전 서버 | 기존 EXPLAIN 테이블 |
사용 불가 |
단일 테이블 UPDATE와 DELETE는 트리가 없어서 플러그인이 FORMAT=JSON으로 대체하고, JSON으로도 표시할 수 없는 MySQL 9에서는 기존 테이블 형식으로 대체해요. TiDB는 잘못 해석하지 않도록 감지해서 거부해요.
Explain Analyze는 읽기 구문만 실행해요. PostgreSQL과 달리 MySQL은 실패한 요청을 되돌린다고 믿을 수 없어요. START TRANSACTION; ...; ROLLBACK;으로 보내면, 실패한 구문이 다른 탭에서도 쓰는 풀 연결에 트랜잭션을 열어 둔 채로 남길 수 있거든요. 쓰기를 하는 저장 함수를 호출하는 SELECT는 함수가 한 작업을 커밋하는데, 쿼리 탭에서 실행할 때와 같아요. MariaDB에서는 Beekeeper Studio의 읽기 전용 모드가 ANALYZE 구문을 거부하므로, 읽기 전용 연결에서는 Explain Analyze를 사용할 수 없어요.
구문은 MySQL 규칙에 따라 읽어요: 줄바꿈(LF)에서만 끝나는 # 및 -- 주석, 백슬래시 이스케이프, "..." 문자열, 그리고 MySQL이 내용을 실행하는 /*! ... */ 주석이에요. NO_BACKSLASH_ESCAPES와 ANSI_QUOTES는 문자열이 끝나는 위치를 바꾸고 풀 연결은 둘 중 어느 쪽이든 가질 수 있어서, 모든 조합에서 구문이 하나의 구문이자 읽기 구문으로 해석되어야 해요. 서버가 여러 방식으로 해석할 수 있는 텍스트는 추측하지 않고 거부해요: 버전 조건부 /*!50700 ... */ 주석이나 MariaDB 전용 /*M! ... */ 주석, -- 주석 안의 캐리지 리턴, NUL 문자가 그래요.
MariaDB는 단계가 아니라 테이블별로 시간을 측정해요. 그래서 조인이나 임시 테이블의 시간은 읽은 테이블들을 제외하고 쿼리에 걸린 시간이에요.
SQLite
EXPLAIN QUERY PLAN은 어떤 테이블을 어떤 순서로, 어떤 인덱스로 읽는지 보여 줘요. SQLite는 비용, 행 수, 시간을 제공하지 않으므로 다이어그램은 단계를, 테이블 뷰는 각 단계의 상세 정보를 보여 주고, Explain Analyze는 없어요. 인사이트는 SQLite가 실행할 때마다 만드는 임시 인덱스, 조인이나 상관 서브쿼리의 행마다 반복되는 테이블 스캔, 임시 B-tree에서의 정렬을 짚어 줘요. LibSQL 연결도 같은 엔진을 사용해요.
Beekeeper Studio는 SQLite 텍스트를 실행하기 전에 자체 파서로 구문을 나누기 때문에, 내부(문자열, 이름, 주석)에 세미콜론이 있는 구문은 거부해요. 그래야 어떤 분할기도 그 안에서 두 번째 구문을 찾을 수 없어요.
스크린샷
느린 단계를 선택하고 그에 대한 인사이트를 표시한 Explain Analyze:
같은 계획을 자체 시간 기준으로 정렬한 테이블:
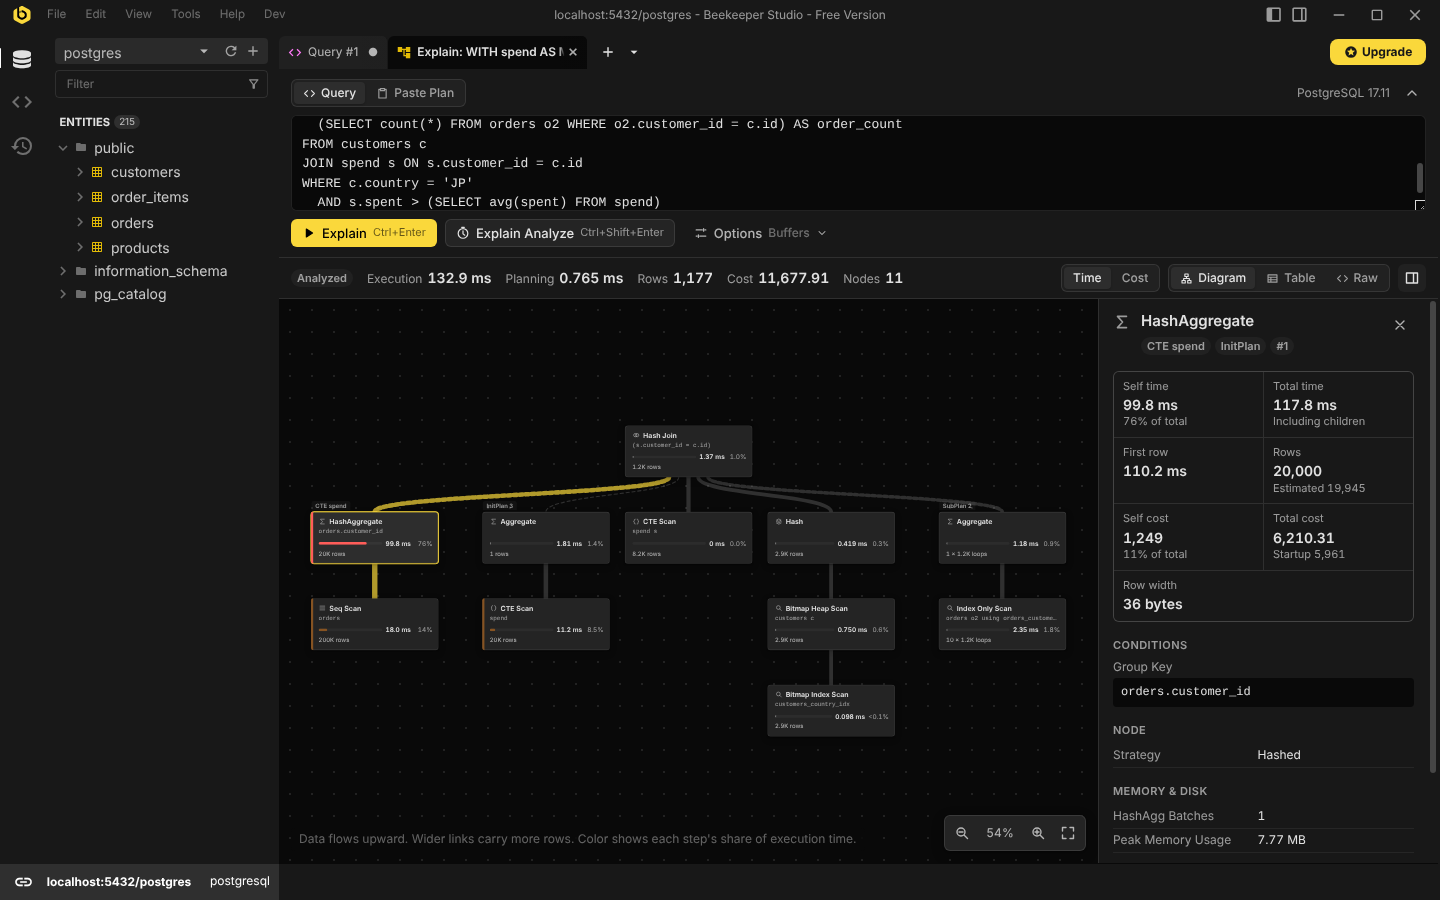
CTE, InitPlan, SubPlan이 각각 별도 분기로 표시된 쿼리:
플러그인은 Beekeeper Studio의 테마를 따라가요:
개발
Node.js 22+와 Yarn 1이 필요해요.
yarn install
yarn dev        # builds with hot reload and links the plugin into Beekeeper Studio
yarn test       # unit tests
yarn build      # type-check and build into dist/
yarn dev는 @beekeeperstudio/vite-plugin을 사용해 이 폴더를 Beekeeper Studio의 플러그인 디렉터리에 심볼릭 링크로 연결해요.
기본적으로 Beekeeper Studio는 허용 목록에 있는 자체 플러그인만 불러와요. 이 플러그인을 불러오려면 사용자 설정 파일에 다음을 추가하고 앱을 다시 시작하세요:
[pluginSystem]
disabled = false
그런 다음 데이터베이스에 연결하면 쿼리 편집기의 컨텍스트 메뉴에 Visualize Explain Plan이, 새 탭 메뉴에 Explain Visualizer가 나타나요.
하네스
dev/harness.html은 Beekeeper Studio를 대신해요. iframe에 플러그인을 불러오고, 앱과 같은 메시지로 요청에 응답하면서 실제 데이터베이스에 쿼리를 실행해요. UI 작업, 탭을 여는 모든 방법 시험, 데이터베이스와 테마 전환을 가장 빠르게 할 수 있는 방법이에요.
docker run -d --name pg -e POSTGRES_PASSWORD=pw -p 5432:5432 postgres:17
psql postgres://postgres:pw@localhost:5432/postgres -f scripts/fixtures/seed.sql

docker run -d --name mysql -e MYSQL_ROOT_PASSWORD=pw -e MYSQL_DATABASE=shop -p 3306:3306 mysql:8.4
mysql -h127.0.0.1 -uroot -ppw shop < scripts/fixtures/seed-mysql.sql

PG_URL=postgres://postgres:pw@localhost:5432/postgres \
MYSQL_URL=mysql://root:pw@127.0.0.1:3306/shop \
yarn harness
MARIADB_URL로 하네스의 MariaDB를 다른 서버로 지정할 수 있어요(지정하지 않으면 MYSQL_URL을 사용해요). SQLite는 따로 필요한 게 없어요. 처음 사용할 때 scripts/fixtures/seed-sqlite.sql로 임시 데이터베이스를 만들거나, SQLITE_PATH로 데이터베이스를 지정할 수 있어요.
테스트
tests/postgres는 PostgreSQL 12, 17, 18에서 캡처한 실제 계획(tests/fixtures/postgres)을 파싱해요. 각 픽스처에는 같은 계획이 JSON과 텍스트 형식으로 들어 있고, 테스트는 둘이 같은 트리를 만드는지 확인해요.tests/mysql은 MySQL 5.7, 8.0.17, 8.0, 8.4, 9.7과 MariaDB 10.4, 10.6, 11.4에서 캡처한 계획(tests/fixtures/mysql)을 파싱해요. 각 픽스처에는 한 구문에 대해 해당 서버가 지원하는 모든 형식이 들어 있어요: 트리,EXPLAIN ANALYZE, 두 JSON 버전, MariaDB의ANALYZE, 기존 테이블 형식. 테스트는 형식들이 일치하는지 확인해요.tests/sqlite는 SQLite 3.16(3.24 이전 형식), 3.27, 3.45의EXPLAIN QUERY PLAN행(tests/fixtures/sqlite)을 파싱해요.tests/integration은 실제 서버에 EXPLAIN을 실행해요:PG_URL이 설정되면 PostgreSQL,MYSQL_URL이 설정되면 MySQL 또는 MariaDB, 그리고 SQLite는 Node 내장node:sqlite로 항상 실행해요.tests/state는 가짜 호스트로 탭의 동작을 테스트해요.
다른 서버 버전에서 픽스처를 캡처하려면 데이터를 시드하고 캡처 스크립트를 실행하세요:
# PostgreSQL: seed with scripts/fixtures/seed.sql
PG_URL=postgres://... FIXTURE_PREFIX=pg16- node scripts/fixtures/capture-postgres.mjs
# MySQL or MariaDB: seed with scripts/fixtures/seed-mysql.sql; named after the server
MYSQL_URL=mysql://root:pw@127.0.0.1:3306/shop node scripts/fixtures/capture-mysql.mjs
# SQLite: uses Python's bundled SQLite, so older Python images give older SQLite
python3 scripts/fixtures/capture-sqlite.py
docker run --rm -v "$PWD:/w" -w /w python:3.6-stretch python3 scripts/fixtures/capture-sqlite.py
작동 방식
src/
  core/        database-neutral plan model, analysis, metrics, layout, formatting
  engines/     one adapter per database family, plus the registry
    postgres/  EXPLAIN builder, JSON and text parsers, timing rules, insights
    mysql/     version detection; tree, JSON (both versions) and table readers; insights
    sqlite/    EXPLAIN QUERY PLAN rows and shell text; insights
    shared/    helpers adapters build on: a configurable SQL lexer, statement
               checks, Explain Analyze policies, result readers, a JSON parser
               that keeps repeated keys
  host/        everything that talks to Beekeeper Studio
  state/       the tab's state and actions
  components/  Vue components: diagram, table, details, raw view
모든 어댑터는 해당 데이터베이스의 EXPLAIN 출력을 src/core/plan.ts의 Plan 모델로 변환해요. PlanNode에는 연산 이름, kind(scan, index, join, filter, sort 등), 선택적 추정값(totalCost, estimatedRows), 선택적 측정값(actualRows, loops, 시간), 파생값 inclusiveTime, exclusiveTime, exclusiveCost, 그리고 상세 패널용 조건과 그룹화된 속성이 있어요. 모든 지표는 선택 사항이고, UI는 엔진이 제공하는 것만 보여 줘요. SQLite 계획에는 숫자가 없으므로 테이블은 비용 대신 각 단계의 상세 정보를 보여 줘요.
자체 시간은 엔진마다 다르므로 어댑터가 계산해요. PostgreSQL의 규칙은 src/engines/postgres/timing.ts에 있어요: 루프당 시간에 루프 수를 곱하고, 병렬 워커는 한 번만 세고, CTE 시간은 그것을 읽는 CTE 스캔에 귀속하고, InitPlan의 시간은 그것을 평가하는 노드에 귀속해요. MySQL도 루프당 시간을 보고하며 공용 computeLoopTimings(src/core/metrics.ts)를 사용하고, select 목록의 서브쿼리는 쿼리 시간에 포함되지 않으므로 그 위에 더해요. MariaDB는 단계가 아니라 테이블과 전체 쿼리의 시간을 측정하고, 나머지는 computeMixedTimings가 채워요.
MySQL의 세 가지 형식은 같은 연산 이름으로 읽혀요: 트리 텍스트와 JSON 버전 2는 같은 이터레이터를 나열하고, 쿼리 블록 JSON(과 이를 바탕으로 재구성한 기존 테이블 형식)은 테이블 순서대로 이어진 조인 체인이 돼요. 인사이트 규칙은 원본 출력이 아니라 이 이름들을 기준으로 동작해요.
src/core/analysis.ts는 모든 엔진에 공통인 것을 더해요: 시간과 비용의 비중, 가장 느린 단계, 행 수 추정 오차 인사이트.
데이터베이스 추가하기
엔진 폴더와 레지스트리 외에는 바꿀 필요가 없어요.
- 다음을 만드세요:
src/engines/<name>/다음을 구현하는 객체 포함:ExplainEngine(src/engines/types.ts):connectionTypes: 처리하는 Beekeeper Studio 연결 유형, 여러 제품을 다룰 때(MySQL과 MariaDB)는products.inspect(sql, server): 구문을 나누고 분류해요(데이터를 변경하는지?).src/engines/shared/lexer.ts는 방언(주석 스타일, 따옴표, 플레이스홀더)을 받아요.analyzePolicy(statement, context): Explain Analyze가 구문을 실행해도 되는지, 먼저 무엇을 물어볼지, 편집기 아래에 무엇을 표시할지 정해요.src/engines/shared/analyzePolicy.ts에 롤백 정책과 읽기 전용 정책이 있어요.explain(request, runQuery): 데이터베이스에 필요한 SQL을 보내고 결과를 파싱해요. 예를 들어 이전 형식으로 대체하기 위해runQuery를 여러 번 호출할 수 있어요.loadServerInfo(runQuery): 버전과 엔진이 알아야 하는 기타 정보(MySQL의 SQL 모드)를 가져와요.ServerInfo에 직접 필드를 추가해 확장하세요.canParse/parse: 붙여넣은 출력과 결과 그리드의 값을 읽어요. 파싱이 반환하는 원본 텍스트는 다시 파싱했을 때 같은 계획이 되어야 해요. 복원된 탭은 이 텍스트로 다시 만들어지거든요.options: Options 메뉴에 표시되는 토글로, 더 새로운 서버가 필요한 경우 각각unavailable(server)를 가져요.
- 네이티브 연산자를
NodeKind에 매핑하고 존재하는 지표를 채우세요. 비용과 시간에는 적합한 경우src/core/metrics.ts의 헬퍼를 사용하고, 마지막에src/core/analysis.ts의finishPlan()을 호출하세요. src/engines/registry.ts에 등록하고, 실제 서버에서 캡처한 픽스처(scripts/fixtures/의 캡처 스크립트)와 다른 엔진과 같은 방식의 테스트를 추가하세요.
지원 예정인 SQL Server에 대한 참고 사항:
- Beekeeper Studio의 SQL Server 클라이언트는 요청을
;기준으로 나누고, 각 구문을 서로 다른 풀 연결에서 실행할 수 있어요.SET SHOWPLAN_XML ON은 배치에 단독으로 있어야 하고 같은 연결의 다음 배치에 적용되므로, 예상 계획을 얻으려면 한 연결에서 배치를 실행하는 새로운 호스트 API가 필요해요. SET STATISTICS XML ON을 구문과 함께 한 배치에 넣으면(;없이) 실제 계획을 얻을 수 있지만, 구문이 실행되고 그 결과 행이 플러그인으로 반환돼요.- SSMS에서 붙여넣은 계획 XML(
.sqlplan)은 호스트 지원이 필요 없어요.
릴리스
bin/make-release.sh를 실행하세요. 기존 태그를 바탕으로 다음 버전을 제안하고,manifest.json과package.json의version을 설정한 뒤 커밋하고,v0.1.0같은 대응 태그를 푸시해요.- 릴리스 워크플로가 빌드와 테스트를 하고,
manifest.json과explain-visualizer-<version>.zip이 포함된 GitHub 릴리스 초안을 만들어요. 초안을 게시하세요.
yarn build && yarn package로 같은 아카이브를 로컬에서 만들 수 있어요.
라이선스
GPL-3.0. LICENSE를 참고하세요.