
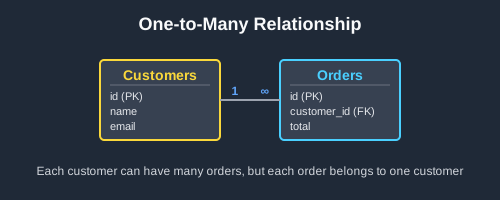
Une relation un-à-plusieurs relie une ligne d’une table parente à un nombre quelconque de lignes d’une table enfant, comme un client et ses commandes. On la construit avec une colonne de clé étrangère dans la table enfant qui pointe vers le parent. Les exemples fonctionnent sous PostgreSQL, MySQL, SQLite et SQL Server.
Comment modéliser une relation un-à-plusieurs
Ajoute à la table enfant, le côté « plusieurs », une colonne qui contient la clé primaire de son parent, et déclare-la comme clé étrangère. Chaque commande stocke l’id du client qui l’a passée, et la table des clients ne change pas du tout.
CREATE TABLE customers (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL
);

-- Each order stores the id of the customer who placed it
CREATE TABLE orders (
    id INTEGER PRIMARY KEY,
    customer_id INTEGER NOT NULL,
    order_date DATE NOT NULL,
    total DECIMAL(10,2) NOT NULL,
    FOREIGN KEY (customer_id) REFERENCES customers(id)
);
Joins les deux tables sur la clé étrangère pour voir chaque client avec ses commandes :
-- Input: customers
-- id | name
-- ---+------
-- 1  | Alice
-- 2  | Bob
-- 3  | Carol

-- Input: orders
-- id | customer_id | order_date | total
-- ---+-------------+------------+-------
-- 1  | 2           | 2026-03-02 | 42.50
-- 2  | 1           | 2026-03-05 | 18.00
-- 3  | 2           | 2026-04-11 | 120.00
-- 4  | 2           | 2026-05-20 | 64.99

SELECT c.name, o.order_date, o.total
FROM customers c
JOIN orders o ON c.id = o.customer_id
ORDER BY c.name, o.order_date;

-- Output:
-- name  | order_date | total
-- ------+------------+-------
-- Alice | 2026-03-05 | 18.00
-- Bob   | 2026-03-02 | 42.50
-- Bob   | 2026-04-11 | 120.00
-- Bob   | 2026-05-20 | 64.99
Bob a trois commandes et chaque commande a un seul client.
Règles à connaître
-
La clé étrangère va dans la table enfant. Chaque commande enregistre son client. Ne donne jamais à
customersune colonne qui liste des ID de commandes. - Un simple JOIN écarte les parents sans enfants. Carol n’apparaît pas dans le résultat ci-dessus. Utilise un LEFT JOIN quand chaque parent doit apparaître, comme dans les exemples plus bas.
-
Indexe la clé étrangère. Les jointures et les recherches par client ont besoin d’un index sur
orders.customer_id(MySQL en crée un pour toi avec la clé étrangère) :
CREATE INDEX idx_orders_customer_id ON orders(customer_id);
-
La clé étrangère protège les deux tables. Elle rejette une commande pour un client qui n’existe pas et, par défaut, refuse de supprimer un client qui a encore des commandes. Ajoute
ON DELETE CASCADEpour supprimer ses commandes avec lui, ouON DELETE SET NULLpour garder les commandes sans client (la colonne doit alors accepter NULL) :
-- Input: the customers and orders tables above

INSERT INTO orders VALUES (5, 99, '2026-06-01', 10.00);
-- ERROR: insert or update on table "orders" violates foreign key constraint "orders_customer_id_fkey"

DELETE FROM customers WHERE id = 1;
-- ERROR: update or delete on table "customers" violates foreign key constraint "orders_customer_id_fkey" on table "orders"

-- With FOREIGN KEY (customer_id) REFERENCES customers(id) ON DELETE CASCADE
DELETE FROM customers WHERE id = 1;

-- Output (orders after the DELETE):
-- id | customer_id | order_date | total
-- ---+-------------+------------+-------
-- 1  | 2           | 2026-03-02 | 42.50
-- 3  | 2           | 2026-04-11 | 120.00
-- 4  | 2           | 2026-05-20 | 64.99
-
SQLite ignore les clés étrangères tant que tu ne les actives pas. Exécute
PRAGMA foreign_keys = ON;sur chaque connexion, sinon SQLite accepte des commandes pour des clients qui n’existent pas.
Syntaxe alternative
Il existe trois autres façons de déclarer la même clé :
-- Inline on the column (MySQL 8.0 accepts this but silently ignores it)
customer_id INTEGER NOT NULL REFERENCES customers(id)

-- Named, so errors and later changes can refer to it
CONSTRAINT fk_orders_customer FOREIGN KEY (customer_id) REFERENCES customers(id)

-- Added to an existing table (SQLite can't add a foreign key this way)
ALTER TABLE orders ADD CONSTRAINT fk_orders_customer
    FOREIGN KEY (customer_id) REFERENCES customers(id);
Pour des id remplis automatiquement par la base de données, déclare la clé du parent en SERIAL PRIMARY KEY sous PostgreSQL, INT AUTO_INCREMENT PRIMARY KEY sous MySQL, INTEGER PRIMARY KEY sous SQLite ou INT IDENTITY PRIMARY KEY sous SQL Server. La colonne de clé étrangère reste un simple entier.
Quand utiliser une relation un-à-plusieurs ?
Utilise-la dès que chaque enfant appartient à exactement un parent : clients et commandes, articles et commentaires, services et employés, catégories et produits. Si un enfant peut avoir plusieurs parents, comme un étudiant qui suit plusieurs cours, il te faut plutôt une relation plusieurs-à-plusieurs. Voici les problèmes qu’une relation un-à-plusieurs permet de résoudre.
Afficher chaque parent avec ses enfants
Une facture avec ses lignes, un article avec ses commentaires : joins la table enfant au parent sur la clé étrangère. Les colonnes du parent se répètent sur chaque ligne enfant.
Compter les enfants de chaque parent
Combien de commandes chaque client a passées, combien d’articles chaque auteur a écrits : LEFT JOIN, regroupe par parent et compte une colonne enfant. Compter une colonne enfant plutôt que * fait apparaître les parents sans enfants avec 0.
Trouver les parents sans enfants
Les clients qui n’ont jamais commandé, les services sans projets, les produits que personne n’a évalués. Un LEFT JOIN remplit les colonnes enfant avec NULL quand il n’y a pas de correspondance : garde donc les lignes où l’id de l’enfant est NULL.
Totaliser les valeurs des enfants
Chiffre d’affaires par client, valeur du stock par catégorie, heures saisies par projet : SUM, AVG, MIN ou MAX sur les lignes enfant, regroupées par parent. Un parent sans enfants obtient NULL, que COALESCE transforme en 0.
Stocker une hiérarchie dans une seule table
Les employés et leurs managers, les dossiers et sous-dossiers, les catégories et sous-catégories : la clé étrangère pointe vers la même table, et un NULL marque le sommet de l’arbre. Joins la table à elle-même pour placer chaque ligne à côté de son parent.
Exemples concrets de relations un-à-plusieurs
Afficher la dernière commande de chaque client
ROW_NUMBER() numérote les commandes de chaque client de la plus récente à la plus ancienne. Garde le numéro 1 :
-- Input: customers
-- id | name
-- ---+------
-- 1  | Alice
-- 2  | Bob
-- 3  | Carol

-- Input: orders
-- id | customer_id | order_date | total
-- ---+-------------+------------+-------
-- 1  | 2           | 2026-03-02 | 42.50
-- 2  | 1           | 2026-03-05 | 18.00
-- 3  | 2           | 2026-04-11 | 120.00
-- 4  | 2           | 2026-05-20 | 64.99

SELECT name, order_date, total
FROM (
    SELECT c.name, o.order_date, o.total,
           ROW_NUMBER() OVER (PARTITION BY c.id ORDER BY o.order_date DESC) AS rn
    FROM customers c
    JOIN orders o ON c.id = o.customer_id
) latest
WHERE rn = 1
ORDER BY name;

-- Output:
-- name  | order_date | total
-- ------+------------+------
-- Alice | 2026-03-05 | 18.00
-- Bob   | 2026-05-20 | 64.99
Classer les clients par nombre de commandes
-- Input: the customers and orders tables above

SELECT c.name, COUNT(o.id) AS order_count
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
GROUP BY c.id, c.name
ORDER BY order_count DESC;

-- Output:
-- name  | order_count
-- ------+------------
-- Bob   | 3
-- Alice | 1
-- Carol | 0
Trouver les clients qui n’ont jamais commandé
-- Input: the customers and orders tables above

SELECT c.name
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
WHERE o.id IS NULL;

-- Output:
-- name
-- -----
-- Carol
NOT EXISTS fait le même travail et colle davantage à la question :
-- Input: the customers and orders tables above

SELECT c.name
FROM customers c
WHERE NOT EXISTS (
    SELECT 1 FROM orders o WHERE o.customer_id = c.id
);

-- Output:
-- name
-- -----
-- Carol
Trouver tes plus gros clients
SUM sur aucune ligne donne NULL, donc COALESCE transforme le total de Carol en 0 :
-- Input: the customers and orders tables above

SELECT c.name, COALESCE(SUM(o.total), 0) AS total_spent
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
GROUP BY c.id, c.name
ORDER BY total_spent DESC;

-- Output:
-- name  | total_spent
-- ------+------------
-- Bob   | 227.49
-- Alice | 18.00
-- Carol | 0
Parcourir un organigramme du haut vers le bas
Le manager_id de chaque employé pointe vers un autre employé. Une requête récursive part de la personne sans manager et ajoute un niveau de subordonnés à la fois :
CREATE TABLE employees (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL,
    manager_id INTEGER,  -- NULL for the person at the top
    FOREIGN KEY (manager_id) REFERENCES employees(id)
);

-- Input: employees
-- id | name  | manager_id
-- ---+-------+-----------
-- 1  | Maya  | NULL
-- 2  | Raj   | 1
-- 3  | Lena  | 1
-- 4  | Tom   | 2
-- 5  | Sofia | 2

-- In SQL Server, write WITH instead of WITH RECURSIVE
WITH RECURSIVE org_chart AS (
    -- Start at the top: the employee with no manager
    SELECT id, name, 0 AS level
    FROM employees
    WHERE manager_id IS NULL

    UNION ALL

    -- Then add each employee's direct reports, one level at a time
    SELECT e.id, e.name, oc.level + 1
    FROM employees e
    JOIN org_chart oc ON e.manager_id = oc.id
)
SELECT name, level
FROM org_chart
ORDER BY level, name;

-- Output:
-- name  | level
-- ------+------
-- Maya  | 0
-- Lena  | 1
-- Raj   | 1
-- Sofia | 2
-- Tom   | 2
Pour aller plus loin sur les relations un-à-plusieurs
Sur ce blog :
- Guide des relations en base de données : un-à-un, un-à-plusieurs et plusieurs-à-plusieurs côte à côte
- Guide de la relation plusieurs-à-plusieurs : quand les deux côtés peuvent en avoir plusieurs, avec une table de jonction
- Relations un-à-un en base de données : quand chaque ligne a exactement un partenaire
- Utiliser les clés étrangères dans PostgreSQL : créer des clés étrangères et choisir ce qui se passe quand un parent change
- Guide des JOIN SQL en diagrammes : jointures INNER et LEFT entre tables parente et enfant
- Guide du GROUP BY SQL : compter et additionner les lignes enfant par parent
- Guide CTE vs sous-requête SQL : les CTE, y compris récursives
Documentation officielle :
- PostgreSQL : clés étrangères
- MySQL : contraintes FOREIGN KEY
- SQLite : prise en charge des clés étrangères
- SQL Server : contraintes de clé primaire et étrangère
 Beekeeper Studio est une interface de base de données gratuite & open source
Le meilleur outil de requêtes & éditeur SQL que j’aie jamais utilisé. Il m’offre tout ce dont j’ai besoin pour gérer ma base de données. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio est rapide, intuitif et facile à utiliser. Beekeeper prend en charge plein de bases de données et fonctionne parfaitement sous Windows, Mac et Linux.
Ce que les utilisateurs disent de Beekeeper Studio
« Beekeeper Studio a complètement remplacé mon ancien workflow SQL. C’est rapide, intuitif, et ça rend le travail sur les bases de données à nouveau agréable. »
« J’ai essayé beaucoup d’interfaces de base de données, mais Beekeeper trouve l’équilibre parfait entre fonctionnalités et simplicité. Ça marche, tout simplement. »