
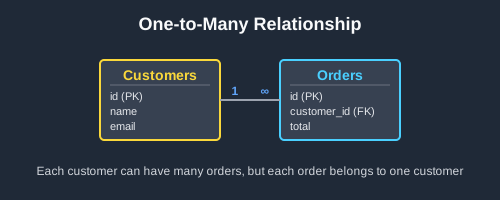
Eine 1:n-Beziehung (One-to-Many) verknüpft eine Zeile in einer Elterntabelle mit beliebig vielen Zeilen in einer Kindtabelle, etwa einen Kunden mit seinen Bestellungen. Du baust sie mit einer Fremdschlüsselspalte in der Kindtabelle, die auf das Elternelement zeigt. Die Beispiele funktionieren in PostgreSQL, MySQL, SQLite und SQL Server.
So modellierst du eine 1:n-Beziehung
Gib der Kindtabelle, also der „n“-Seite, eine Spalte mit dem Primärschlüssel ihres Elternelements und deklariere sie als Fremdschlüssel. Jede Bestellung speichert die id des Kunden, der sie aufgegeben hat, und die Tabelle customers ändert sich überhaupt nicht.
CREATE TABLE customers (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL
);

-- Each order stores the id of the customer who placed it
CREATE TABLE orders (
    id INTEGER PRIMARY KEY,
    customer_id INTEGER NOT NULL,
    order_date DATE NOT NULL,
    total DECIMAL(10,2) NOT NULL,
    FOREIGN KEY (customer_id) REFERENCES customers(id)
);
Verknüpfe die beiden Tabellen über den Fremdschlüssel, um jeden Kunden mit seinen Bestellungen zu sehen:
-- Input: customers
-- id | name
-- ---+------
-- 1  | Alice
-- 2  | Bob
-- 3  | Carol

-- Input: orders
-- id | customer_id | order_date | total
-- ---+-------------+------------+-------
-- 1  | 2           | 2026-03-02 | 42.50
-- 2  | 1           | 2026-03-05 | 18.00
-- 3  | 2           | 2026-04-11 | 120.00
-- 4  | 2           | 2026-05-20 | 64.99

SELECT c.name, o.order_date, o.total
FROM customers c
JOIN orders o ON c.id = o.customer_id
ORDER BY c.name, o.order_date;

-- Output:
-- name  | order_date | total
-- ------+------------+-------
-- Alice | 2026-03-05 | 18.00
-- Bob   | 2026-03-02 | 42.50
-- Bob   | 2026-04-11 | 120.00
-- Bob   | 2026-05-20 | 64.99
Bob hat drei Bestellungen, und jede Bestellung hat genau einen Kunden.
Wichtige Regeln
-
Der Fremdschlüssel gehört in die Kindtabelle. Jede Bestellung speichert ihren Kunden. Gib
customersniemals eine Spalte, die Bestell-IDs auflistet. - Ein einfacher JOIN lässt Eltern ohne Kinder weg. Carol fehlt in der Ausgabe oben. Nimm einen LEFT JOIN, wenn jedes Elternelement erscheinen soll, wie in den Beispielen weiter unten.
-
Indiziere den Fremdschlüssel. Joins und Abfragen nach Kunde brauchen einen Index auf
orders.customer_id(MySQL legt ihn zusammen mit dem Fremdschlüssel automatisch an):
CREATE INDEX idx_orders_customer_id ON orders(customer_id);
-
Der Fremdschlüssel schützt beide Tabellen. Er lehnt Bestellungen für nicht existierende Kunden ab und verweigert standardmäßig das Löschen eines Kunden, der noch Bestellungen hat. Füge
ON DELETE CASCADEhinzu, um seine Bestellungen mitzulöschen, oderON DELETE SET NULL, um die Bestellungen ohne Kunden zu behalten (die Spalte muss dann NULL erlauben):
-- Input: the customers and orders tables above

INSERT INTO orders VALUES (5, 99, '2026-06-01', 10.00);
-- ERROR: insert or update on table "orders" violates foreign key constraint "orders_customer_id_fkey"

DELETE FROM customers WHERE id = 1;
-- ERROR: update or delete on table "customers" violates foreign key constraint "orders_customer_id_fkey" on table "orders"

-- With FOREIGN KEY (customer_id) REFERENCES customers(id) ON DELETE CASCADE
DELETE FROM customers WHERE id = 1;

-- Output (orders after the DELETE):
-- id | customer_id | order_date | total
-- ---+-------------+------------+-------
-- 1  | 2           | 2026-03-02 | 42.50
-- 3  | 2           | 2026-04-11 | 120.00
-- 4  | 2           | 2026-05-20 | 64.99
-
SQLite ignoriert Fremdschlüssel, bis du sie einschaltest. Führe
PRAGMA foreign_keys = ON;bei jeder Verbindung aus, sonst akzeptiert SQLite Bestellungen für Kunden, die es nicht gibt.
Alternative Syntax
Es gibt drei weitere Möglichkeiten, denselben Schlüssel zu deklarieren:
-- Inline on the column (MySQL 8.0 accepts this but silently ignores it)
customer_id INTEGER NOT NULL REFERENCES customers(id)

-- Named, so errors and later changes can refer to it
CONSTRAINT fk_orders_customer FOREIGN KEY (customer_id) REFERENCES customers(id)

-- Added to an existing table (SQLite can't add a foreign key this way)
ALTER TABLE orders ADD CONSTRAINT fk_orders_customer
    FOREIGN KEY (customer_id) REFERENCES customers(id);
Für ids, die die Datenbank automatisch vergibt, deklarierst du den Schlüssel der Elterntabelle als SERIAL PRIMARY KEY in PostgreSQL, INT AUTO_INCREMENT PRIMARY KEY in MySQL, INTEGER PRIMARY KEY in SQLite oder INT IDENTITY PRIMARY KEY in SQL Server. Die Fremdschlüsselspalte bleibt ein einfacher Integer.
Wann solltest du eine 1:n-Beziehung verwenden?
Immer dann, wenn jedes Kind zu genau einem Elternelement gehört: Kunden und Bestellungen, Beiträge und Kommentare, Abteilungen und Mitarbeiter, Kategorien und Produkte. Kann ein Kind mehrere Eltern haben, etwa ein Student mit mehreren Kursen, brauchst du stattdessen eine n:m-Beziehung. Diese Probleme löst du mit einer 1:n-Beziehung.
Jedes Elternelement mit seinen Kindern anzeigen
Eine Rechnung mit ihren Positionen, ein Beitrag mit seinen Kommentaren: Verknüpfe die Kindtabelle über den Fremdschlüssel mit der Elterntabelle. Die Spalten des Elternelements wiederholen sich in jeder Kindzeile.
Die Kinder jedes Elternelements zählen
Wie viele Bestellungen jeder Kunde aufgegeben hat, wie viele Artikel jeder Autor geschrieben hat: LEFT JOIN, nach dem Elternelement gruppieren und eine Kindspalte zählen. Zählst du eine Kindspalte statt *, erscheinen Eltern ohne Kinder mit 0.
Eltern ohne Kinder finden
Kunden, die nie bestellt haben, Abteilungen ohne Projekte, Produkte ohne Bewertung. Ein LEFT JOIN füllt die Kindspalten mit NULL, wenn es keinen Treffer gibt, also behältst du die Zeilen, in denen die id des Kindes NULL ist.
Werte der Kinder aufsummieren
Umsatz pro Kunde, Lagerwert pro Kategorie, erfasste Stunden pro Projekt: SUM, AVG, MIN oder MAX über die Kindzeilen, gruppiert nach dem Elternelement. Ein Elternelement ohne Kinder bekommt NULL, was COALESCE in 0 umwandelt.
Eine Hierarchie in einer Tabelle speichern
Mitarbeiter und ihre Vorgesetzten, Ordner und Unterordner, Kategorien und Unterkategorien: Der Fremdschlüssel zeigt auf dieselbe Tabelle zurück, und ein NULL darin markiert die Spitze des Baums. Verknüpfe die Tabelle mit sich selbst, um jede Zeile neben ihr Elternelement zu stellen.
Praxisbeispiele für 1:n-Beziehungen
Die neueste Bestellung jedes Kunden anzeigen
ROW_NUMBER() nummeriert die Bestellungen jedes Kunden von der neuesten zur ältesten. Behalte Nummer 1:
-- Input: customers
-- id | name
-- ---+------
-- 1  | Alice
-- 2  | Bob
-- 3  | Carol

-- Input: orders
-- id | customer_id | order_date | total
-- ---+-------------+------------+-------
-- 1  | 2           | 2026-03-02 | 42.50
-- 2  | 1           | 2026-03-05 | 18.00
-- 3  | 2           | 2026-04-11 | 120.00
-- 4  | 2           | 2026-05-20 | 64.99

SELECT name, order_date, total
FROM (
    SELECT c.name, o.order_date, o.total,
           ROW_NUMBER() OVER (PARTITION BY c.id ORDER BY o.order_date DESC) AS rn
    FROM customers c
    JOIN orders o ON c.id = o.customer_id
) latest
WHERE rn = 1
ORDER BY name;

-- Output:
-- name  | order_date | total
-- ------+------------+------
-- Alice | 2026-03-05 | 18.00
-- Bob   | 2026-05-20 | 64.99
Kunden nach Anzahl der Bestellungen sortieren
-- Input: the customers and orders tables above

SELECT c.name, COUNT(o.id) AS order_count
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
GROUP BY c.id, c.name
ORDER BY order_count DESC;

-- Output:
-- name  | order_count
-- ------+------------
-- Bob   | 3
-- Alice | 1
-- Carol | 0
Kunden finden, die nie bestellt haben
-- Input: the customers and orders tables above

SELECT c.name
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
WHERE o.id IS NULL;

-- Output:
-- name
-- -----
-- Carol
NOT EXISTS erledigt dasselbe und liest sich näher an der Fragestellung:
-- Input: the customers and orders tables above

SELECT c.name
FROM customers c
WHERE NOT EXISTS (
    SELECT 1 FROM orders o WHERE o.customer_id = c.id
);

-- Output:
-- name
-- -----
-- Carol
Deine umsatzstärksten Kunden finden
SUM über keine Zeilen ergibt NULL, also wandelt COALESCE Carols Summe in 0 um:
-- Input: the customers and orders tables above

SELECT c.name, COALESCE(SUM(o.total), 0) AS total_spent
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
GROUP BY c.id, c.name
ORDER BY total_spent DESC;

-- Output:
-- name  | total_spent
-- ------+------------
-- Bob   | 227.49
-- Alice | 18.00
-- Carol | 0
Ein Organigramm von oben nach unten durchlaufen
Die manager_id jedes Mitarbeiters zeigt auf einen anderen Mitarbeiter. Eine rekursive Abfrage beginnt bei der Person ohne Vorgesetzten und fügt Ebene für Ebene die unterstellten Mitarbeiter hinzu:
CREATE TABLE employees (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL,
    manager_id INTEGER,  -- NULL for the person at the top
    FOREIGN KEY (manager_id) REFERENCES employees(id)
);

-- Input: employees
-- id | name  | manager_id
-- ---+-------+-----------
-- 1  | Maya  | NULL
-- 2  | Raj   | 1
-- 3  | Lena  | 1
-- 4  | Tom   | 2
-- 5  | Sofia | 2

-- In SQL Server, write WITH instead of WITH RECURSIVE
WITH RECURSIVE org_chart AS (
    -- Start at the top: the employee with no manager
    SELECT id, name, 0 AS level
    FROM employees
    WHERE manager_id IS NULL

    UNION ALL

    -- Then add each employee's direct reports, one level at a time
    SELECT e.id, e.name, oc.level + 1
    FROM employees e
    JOIN org_chart oc ON e.manager_id = oc.id
)
SELECT name, level
FROM org_chart
ORDER BY level, name;

-- Output:
-- name  | level
-- ------+------
-- Maya  | 0
-- Lena  | 1
-- Raj   | 1
-- Sofia | 2
-- Tom   | 2
Weiterführende Artikel zu 1:n-Beziehungen
In diesem Blog:
- Leitfaden zu Datenbankbeziehungen: 1:1, 1:n und n:m im direkten Vergleich
- Leitfaden zu n:m-Beziehungen: wenn beide Seiten viele haben können, mit einer Verknüpfungstabelle
- 1:1-Datenbankbeziehungen: wenn jede Zeile genau einen Partner hat
- Fremdschlüssel in PostgreSQL verwenden: Fremdschlüssel anlegen und festlegen, was bei Änderungen am Elternelement passiert
- SQL-JOINs mit Diagrammen: INNER und LEFT JOINs zwischen Eltern- und Kindtabellen
- Leitfaden zu SQL GROUP BY: Kindzeilen pro Elternelement zählen und summieren
- SQL CTE vs. Unterabfrage: CTEs, auch rekursive
Offizielle Dokumentation:
- PostgreSQL: Fremdschlüssel
- MySQL: FOREIGN-KEY-Constraints
- SQLite: Unterstützung für Fremdschlüssel
- SQL Server: Primär- und Fremdschlüssel-Constraints
 Beekeeper Studio ist eine kostenlose & quelloffene Datenbank-GUI
Das beste SQL-Abfrage- & Editor-Tool, das ich je benutzt habe. Es bietet alles, was ich zum Verwalten meiner Datenbank brauche. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio ist schnell, intuitiv und einfach zu bedienen. Beekeeper unterstützt jede Menge Datenbanken und läuft hervorragend auf Windows, Mac und Linux.
Was Nutzer über Beekeeper Studio sagen
„Beekeeper Studio hat meinen alten SQL-Workflow komplett ersetzt. Es ist schnell, intuitiv und macht die Arbeit mit Datenbanken wieder angenehm.“
„Ich habe viele Datenbank-GUIs ausprobiert, aber Beekeeper trifft die perfekte Balance zwischen Funktionsumfang und Einfachheit. Es funktioniert einfach.“