
Eine n:m-Beziehung (Many-to-Many) verknüpft zwei Tabellen, bei denen eine Zeile auf jeder Seite zu vielen Zeilen auf der anderen passen kann: Ein Student belegt viele Kurse, und ein Kurs hat viele Studenten. Du modellierst sie mit einer Verknüpfungstabelle, die pro Verknüpfung eine Zeile speichert. Die Beispiele funktionieren in PostgreSQL, MySQL, SQLite und SQL Server.
So modellierst du eine n:m-Beziehung
Leg eine dritte Tabelle an, die Verknüpfungstabelle (auch Brücken-, Assoziations- oder Join-Tabelle genannt), mit einem Fremdschlüssel zu jeder Seite. Jede Zeile ist eine Verknüpfung: Dieser Student belegt diesen Kurs.
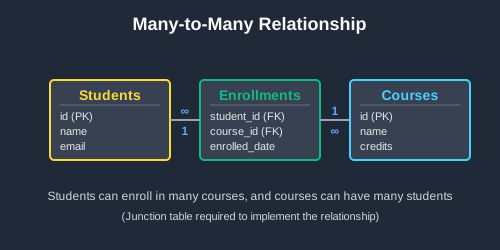
CREATE TABLE students (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
    id INTEGER PRIMARY KEY,
    course_name VARCHAR(100) NOT NULL
);

-- The junction table: one row per student per course
CREATE TABLE enrollments (
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    PRIMARY KEY (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);
Um von einer Seite zur anderen zu kommen, joinst du über die Verknüpfungstabelle:
-- Input: students
-- id | name
-- ---+------
-- 1  | Ana
-- 2  | Ben
-- 3  | Chloe

-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT s.name, c.course_name
FROM students s
JOIN enrollments e ON s.id = e.student_id
JOIN courses c ON e.course_id = c.id
ORDER BY s.name, c.course_name;

-- Output:
-- name  | course_name
-- ------+------------
-- Ana   | Biology
-- Ana   | Chemistry
-- Ben   | Biology
-- Chloe | Biology
Ana belegt zwei Kurse und Biologie hat drei Studenten, die Beziehung ist also in beide Richtungen „viele“.
Wichtige Regeln
-
Mach das Paar zum Primärschlüssel.
PRIMARY KEY (student_id, course_id)verhindert, dass dieselbe Verknüpfung doppelt gespeichert wird:
-- Input: the enrollments table above

INSERT INTO enrollments VALUES (1, 1);
-- ERROR: duplicate key value violates unique constraint "enrollments_pkey"
-
Indiziere die zweite Spalte. Der Index des Primärschlüssels beginnt mit
student_id, findet also die Kurse eines Studenten bereits schnell. Um die Studenten eines Kurses schnell zu finden, brauchst du einen Index, der mitcourse_idbeginnt (MySQL legt ihn zusammen mit dem Fremdschlüssel automatisch an):
CREATE INDEX idx_enrollments_course_id ON enrollments(course_id);
-
Speichere eine Zeile pro Verknüpfung, niemals eine Liste. Eine Spalte
course_idsmit'1,2'lässt sich weder joinen noch indizieren noch per Fremdschlüssel prüfen. -
SQLite ignoriert Fremdschlüssel, bis du sie aktivierst. Führ
PRAGMA foreign_keys = ON;bei jeder Verbindung aus, sonst akzeptiert SQLite eine Einschreibung für einen Studenten, den es gar nicht gibt.
Alternative Syntax
Manche Frameworks geben jeder Tabelle eine eigene id-Spalte, auch Verknüpfungstabellen. Das funktioniert, solange du einen UNIQUE-Constraint auf das Paar setzt, denn die id allein verhindert keine doppelten Verknüpfungen. Nur die id-Spalte unterscheidet sich je nach Datenbank:
-- PostgreSQL
CREATE TABLE enrollments (
    id SERIAL PRIMARY KEY,
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    UNIQUE (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);

-- MySQL:      id INT AUTO_INCREMENT PRIMARY KEY
-- SQLite:     id INTEGER PRIMARY KEY
-- SQL Server: id INT IDENTITY PRIMARY KEY
Du kannst einen Fremdschlüssel auch inline deklarieren: student_id INTEGER NOT NULL REFERENCES students(id). MySQL 8.0 akzeptiert diese Form, ignoriert sie aber stillschweigend, also behalte dort die separate FOREIGN KEY-Klausel bei.
Wann solltest du eine n:m-Beziehung verwenden?
Immer dann, wenn Zeilen auf beiden Seiten viele Partner haben können: Studenten und Kurse, Posts und Tags, Nutzer und Rollen, Produkte und Kategorien. Wenn jede Zeile auf einer Seite immer nur einen Partner hat, reicht eine 1:n-Beziehung. Sobald die Verknüpfungstabelle steht, löst sie diese Probleme.
Nachschlagen, womit eine Zeile verknüpft ist
Welche Kurse belegt ein Student? Welche Tags hat ein Post? Joine von der Zeile zur Verknüpfungstabelle und weiter zur anderen Seite. Dieselbe Verknüpfungstabelle beantwortet die Frage in beide Richtungen.
Verknüpfungen auf jeder Seite zählen
Der vollste Kurs, das meistgenutzte Tag, das Mitglied in den meisten Clubs: Gruppiere nach einer Seite und zähle ihre Zeilen in der Verknüpfungstabelle. Nutze einen LEFT JOIN, wenn Zeilen ohne Verknüpfungen als 0 zählen sollen, statt zu verschwinden.
Details zu jeder Verknüpfung speichern
Eine Note gehört zu einem Studenten in einem Kurs, nicht zum Studenten oder zum Kurs allein, und ein Tantiemenanteil gehört zu einem Autor bei einem bestimmten Buch. Leg diese Spalten in der Verknüpfungstabelle an und frag sie ab wie jede andere Spalte.
Zeilen in derselben Tabelle verknüpfen
Follower, Freunde und Mentoren verbinden Personen mit anderen Personen. Beide Fremdschlüssel der Verknüpfungstabelle zeigen auf dieselbe Tabelle, also joinst du diese Tabelle zweimal, jeweils mit einem anderen Alias.
Echte Beispiele für n:m-Beziehungen
Posts finden, die alle Tags einer Liste haben
Ein Tag-Filter bedeutet meist „Posts mit all diesen Tags“. Suche nach irgendeinem der Tags und behalte dann die Posts, die alle getroffen haben:
-- Input: posts
-- id | title
-- ---+----------------
-- 1  | Indexing basics
-- 2  | Weekend hiking
-- 3  | Joins explained

-- Input: tags
-- id | name
-- ---+---------
-- 1  | sql
-- 2  | outdoors
-- 3  | beginner

-- Input: post_tags
-- post_id | tag_id
-- --------+-------
-- 1       | 1
-- 1       | 3
-- 2       | 2
-- 2       | 3
-- 3       | 1

SELECT p.title
FROM posts p
JOIN post_tags pt ON p.id = pt.post_id
JOIN tags t ON pt.tag_id = t.id
WHERE t.name IN ('sql', 'beginner')
GROUP BY p.id, p.title
HAVING COUNT(*) = 2;

-- Output:
-- title
-- ---------------
-- Indexing basics
„Joins explained“ hat nur eines der beiden Tags und fällt deshalb beim HAVING raus. Passe die 2 an die Anzahl der Tags in der Liste an.
Die beliebtesten Kurse finden
Zähle die Einschreibungen jedes Kurses. Der LEFT JOIN behält Physik, wofür sich niemand angemeldet hat:
-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT c.course_name, COUNT(e.student_id) AS student_count
FROM courses c
LEFT JOIN enrollments e ON c.id = e.course_id
GROUP BY c.id, c.course_name
ORDER BY student_count DESC;

-- Output:
-- course_name | student_count
-- ------------+--------------
-- Biology     | 3
-- Chemistry   | 1
-- Physics     | 0
Erfassen, wer wann wo gearbeitet hat
Gib jeder Verknüpfung ein Start- und Enddatum, und die Verknüpfungstabelle speichert eine Historie. Jemand kann in eine Abteilung zurückkehren, die er verlassen hat, also ist das Paar nicht mehr eindeutig und das Startdatum wird Teil des Primärschlüssels. Die aktuelle Abteilung ist die Zeile ohne Enddatum:
CREATE TABLE employee_departments (
    employee_id INTEGER NOT NULL,
    department_id INTEGER NOT NULL,
    start_date DATE NOT NULL,
    end_date DATE,  -- NULL while it's their current department
    PRIMARY KEY (employee_id, department_id, start_date),
    FOREIGN KEY (employee_id) REFERENCES employees(id),
    FOREIGN KEY (department_id) REFERENCES departments(id)
);

-- Input: employees
-- id | name
-- ---+------
-- 1  | Grace
-- 2  | Omar
-- 3  | Wei

-- Input: departments
-- id | name
-- ---+------------
-- 1  | Sales
-- 2  | Support
-- 3  | Engineering

-- Input: employee_departments
-- employee_id | department_id | start_date | end_date
-- ------------+---------------+------------+-----------
-- 1           | 1             | 2022-03-01 | 2024-06-30
-- 1           | 3             | 2024-07-01 | NULL
-- 2           | 2             | 2023-01-09 | NULL
-- 3           | 1             | 2021-05-17 | NULL

SELECT e.name, d.name AS department, ed.start_date
FROM employees e
JOIN employee_departments ed ON e.id = ed.employee_id
JOIN departments d ON ed.department_id = d.id
WHERE ed.end_date IS NULL
ORDER BY e.name;

-- Output:
-- name  | department  | start_date
-- ------+-------------+-----------
-- Grace | Engineering | 2024-07-01
-- Omar  | Support     | 2023-01-09
-- Wei   | Sales       | 2021-05-17
Damit niemand zwei aktuelle Abteilungen hat, füge einen partiellen Unique-Index hinzu: CREATE UNIQUE INDEX idx_current_dept ON employee_departments(employee_id) WHERE end_date IS NULL;. MySQL kennt keine partiellen Indizes, dort funktioniert das also nicht.
Nutzer finden, die sich gegenseitig folgen
Eine follows-Tabelle verknüpft Nutzer mit Nutzern. Ein CHECK-Constraint verhindert, dass jemand sich selbst folgt, und ein Self-Join der Tabelle findet die Paare, die sich gegenseitig folgen:
CREATE TABLE follows (
    follower_id INTEGER NOT NULL,
    followed_id INTEGER NOT NULL,
    PRIMARY KEY (follower_id, followed_id),
    FOREIGN KEY (follower_id) REFERENCES users(id),
    FOREIGN KEY (followed_id) REFERENCES users(id),
    CONSTRAINT no_self_follow CHECK (follower_id <> followed_id)
);

-- INSERT INTO follows VALUES (2, 2);
-- ERROR: new row for relation "follows" violates check constraint "no_self_follow"

-- Input: users
-- id | name
-- ---+-----
-- 1  | Ava
-- 2  | Leo
-- 3  | Mia
-- 4  | Noah

-- Input: follows
-- follower_id | followed_id
-- ------------+------------
-- 1           | 2
-- 2           | 1
-- 1           | 3
-- 3           | 4
-- 4           | 3

SELECT u1.name AS user_a, u2.name AS user_b
FROM follows f
JOIN follows back ON back.follower_id = f.followed_id
                 AND back.followed_id = f.follower_id
JOIN users u1 ON u1.id = f.follower_id
JOIN users u2 ON u2.id = f.followed_id
WHERE f.follower_id < f.followed_id
ORDER BY user_a;

-- Output:
-- user_a | user_b
-- -------+-------
-- Ava    | Leo
-- Mia    | Noah
Ava folgt Mia, aber Mia folgt ihr nicht zurück, deshalb taucht dieses Paar nicht auf. Die Bedingung f.follower_id < f.followed_id listet jedes gegenseitige Paar einmal statt zweimal.
Weiterführende Infos zu n:m-Beziehungen
In diesem Blog:
- Leitfaden zu Datenbankbeziehungen: 1:1, 1:n und n:m im direkten Vergleich
- Leitfaden zu 1:n-Beziehungen: ein Fremdschlüssel auf der „n“-Seite, ohne Verknüpfungstabelle
- 1:1-Datenbankbeziehungen: wenn jede Zeile genau einen Partner hat
- Zusammengesetzte Primärschlüssel in SQL: der zweispaltige Schlüssel einer Verknüpfungstabelle
- SQL-JOIN-Diagramme: die Joins, die durch eine Verknüpfungstabelle führen
- SQL-GROUP-BY-Leitfaden: Zählen und Summieren über Verknüpfungen
Offizielle Dokumentation:
- PostgreSQL: Foreign keys
- MySQL: FOREIGN KEY constraints
- SQLite: Foreign key support
- SQL Server: Primary and foreign key constraints
 Beekeeper Studio ist eine kostenlose & quelloffene Datenbank-GUI
Das beste SQL-Abfrage- & Editor-Tool, das ich je benutzt habe. Es bietet alles, was ich zum Verwalten meiner Datenbank brauche. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio ist schnell, intuitiv und einfach zu bedienen. Beekeeper unterstützt jede Menge Datenbanken und läuft hervorragend auf Windows, Mac und Linux.
Was Nutzer über Beekeeper Studio sagen
„Beekeeper Studio hat meinen alten SQL-Workflow komplett ersetzt. Es ist schnell, intuitiv und macht die Arbeit mit Datenbanken wieder zum Vergnügen.“
„Ich habe viele Datenbank-GUIs ausprobiert, aber Beekeeper trifft die perfekte Balance zwischen Features und Einfachheit. Es funktioniert einfach.“