
Una relazione molti a molti collega due tabelle in cui una riga di ciascun lato può corrispondere a molte righe dell'altro: uno studente segue molti corsi e un corso ha molti studenti. La modelli con una tabella di giunzione che memorizza una riga per ogni collegamento. Gli esempi funzionano in PostgreSQL, MySQL, SQLite e SQL Server.
Come modellare una relazione molti a molti
Crea una terza tabella, la tabella di giunzione (detta anche tabella ponte, di associazione o di join), con una chiave esterna verso ciascun lato. Ogni riga è un collegamento: questo studente segue questo corso.
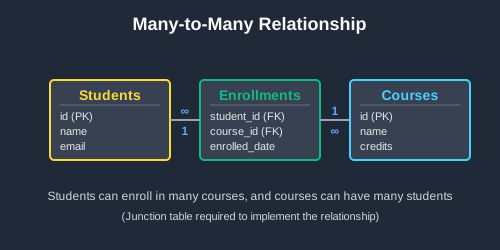
CREATE TABLE students (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
    id INTEGER PRIMARY KEY,
    course_name VARCHAR(100) NOT NULL
);

-- The junction table: one row per student per course
CREATE TABLE enrollments (
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    PRIMARY KEY (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);
Per passare da un lato all'altro, fai un join attraverso la tabella di giunzione:
-- Input: students
-- id | name
-- ---+------
-- 1  | Ana
-- 2  | Ben
-- 3  | Chloe

-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT s.name, c.course_name
FROM students s
JOIN enrollments e ON s.id = e.student_id
JOIN courses c ON e.course_id = c.id
ORDER BY s.name, c.course_name;

-- Output:
-- name  | course_name
-- ------+------------
-- Ana   | Biology
-- Ana   | Chemistry
-- Ben   | Biology
-- Chloe | Biology
Ana segue due corsi e Biologia ha tre studenti, quindi la relazione è “molti” in entrambe le direzioni.
Regole da conoscere
-
Usa la coppia come chiave primaria.
PRIMARY KEY (student_id, course_id)impedisce di memorizzare due volte lo stesso collegamento:
-- Input: the enrollments table above

INSERT INTO enrollments VALUES (1, 1);
-- ERROR: duplicate key value violates unique constraint "enrollments_pkey"
-
Indicizza la seconda colonna. L'indice della chiave primaria inizia con
student_id, quindi trova già rapidamente i corsi di uno studente. Per trovare rapidamente gli studenti di un corso serve un indice che inizi concourse_id(MySQL lo crea per te insieme alla chiave esterna):
CREATE INDEX idx_enrollments_course_id ON enrollments(course_id);
-
Memorizza una riga per collegamento, mai una lista. Una colonna
course_idsche contiene'1,2'non può essere usata in un join, indicizzata o verificata da una chiave esterna. -
SQLite ignora le chiavi esterne finché non le attivi. Esegui
PRAGMA foreign_keys = ON;su ogni connessione, altrimenti SQLite accetterà un'iscrizione per uno studente che non esiste.
Sintassi alternativa
Alcuni framework danno a ogni tabella la propria colonna id, tabelle di giunzione comprese. Va bene, purché tu aggiunga un vincolo UNIQUE sulla coppia, perché l'id da solo non impedisce i collegamenti duplicati. Tra un database e l'altro cambia solo la colonna id:
-- PostgreSQL
CREATE TABLE enrollments (
    id SERIAL PRIMARY KEY,
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    UNIQUE (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);

-- MySQL:      id INT AUTO_INCREMENT PRIMARY KEY
-- SQLite:     id INTEGER PRIMARY KEY
-- SQL Server: id INT IDENTITY PRIMARY KEY
Puoi anche dichiarare una chiave esterna inline: student_id INTEGER NOT NULL REFERENCES students(id). MySQL 8.0 accetta questa forma ma la ignora senza avvisarti, quindi lì mantieni la clausola FOREIGN KEY separata.
Quando usare una relazione molti a molti?
Usala ogni volta che le righe di entrambi i lati possono avere molti partner: studenti e corsi, post e tag, utenti e ruoli, prodotti e categorie. Se ogni riga di un lato ha sempre un solo partner, ti basta una relazione uno a molti. Una volta creata la tabella di giunzione, risolve questi problemi.
Trovare a cosa è collegata una riga
Quali corsi segue uno studente? Quali tag ha un post? Fai un join dalla riga alla tabella di giunzione e poi all'altro lato. La stessa tabella di giunzione risponde alla domanda in entrambe le direzioni.
Contare i collegamenti di ciascun lato
Il corso più affollato, il tag più usato, il membro iscritto a più club: raggruppa per un lato e conta le sue righe nella tabella di giunzione. Usa un LEFT JOIN quando le righe senza collegamenti devono contare 0 invece di sparire.
Memorizzare dettagli su ogni collegamento
Un voto appartiene a uno studente in un corso, non allo studente o al corso da soli, e una quota di diritti d'autore appartiene a un autore per un certo libro. Metti queste colonne nella tabella di giunzione e interrogale come qualsiasi altra colonna.
Collegare righe della stessa tabella
Follower, amici e mentori collegano persone ad altre persone. Entrambe le chiavi esterne della tabella di giunzione puntano alla stessa tabella, quindi fai il join di quella tabella due volte, con un alias diverso ogni volta.
Esempi reali di relazioni molti a molti
Trovare i post che hanno tutti i tag di una lista
Un filtro per tag di solito significa “post con tutti questi tag”. Trova le corrispondenze con uno qualsiasi dei tag, poi tieni i post che li hanno tutti:
-- Input: posts
-- id | title
-- ---+----------------
-- 1  | Indexing basics
-- 2  | Weekend hiking
-- 3  | Joins explained

-- Input: tags
-- id | name
-- ---+---------
-- 1  | sql
-- 2  | outdoors
-- 3  | beginner

-- Input: post_tags
-- post_id | tag_id
-- --------+-------
-- 1       | 1
-- 1       | 3
-- 2       | 2
-- 2       | 3
-- 3       | 1

SELECT p.title
FROM posts p
JOIN post_tags pt ON p.id = pt.post_id
JOIN tags t ON pt.tag_id = t.id
WHERE t.name IN ('sql', 'beginner')
GROUP BY p.id, p.title
HAVING COUNT(*) = 2;

-- Output:
-- title
-- ---------------
-- Indexing basics
“Joins explained” ha solo uno dei due tag, quindi viene escluso dall'HAVING. Cambia il 2 in base al numero di tag nella lista.
Trovare i corsi più popolari
Conta le iscrizioni di ogni corso. Il LEFT JOIN mantiene Fisica, a cui non si è iscritto nessuno:
-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT c.course_name, COUNT(e.student_id) AS student_count
FROM courses c
LEFT JOIN enrollments e ON c.id = e.course_id
GROUP BY c.id, c.course_name
ORDER BY student_count DESC;

-- Output:
-- course_name | student_count
-- ------------+--------------
-- Biology     | 3
-- Chemistry   | 1
-- Physics     | 0
Tenere traccia di chi ha lavorato dove, e quando
Dai a ogni collegamento una data di inizio e di fine e la tabella di giunzione conserverà uno storico. Una persona può tornare in un reparto che aveva lasciato, quindi la coppia non è più univoca e la data di inizio entra nella chiave primaria. Il reparto attuale è la riga senza data di fine:
CREATE TABLE employee_departments (
    employee_id INTEGER NOT NULL,
    department_id INTEGER NOT NULL,
    start_date DATE NOT NULL,
    end_date DATE,  -- NULL while it's their current department
    PRIMARY KEY (employee_id, department_id, start_date),
    FOREIGN KEY (employee_id) REFERENCES employees(id),
    FOREIGN KEY (department_id) REFERENCES departments(id)
);

-- Input: employees
-- id | name
-- ---+------
-- 1  | Grace
-- 2  | Omar
-- 3  | Wei

-- Input: departments
-- id | name
-- ---+------------
-- 1  | Sales
-- 2  | Support
-- 3  | Engineering

-- Input: employee_departments
-- employee_id | department_id | start_date | end_date
-- ------------+---------------+------------+-----------
-- 1           | 1             | 2022-03-01 | 2024-06-30
-- 1           | 3             | 2024-07-01 | NULL
-- 2           | 2             | 2023-01-09 | NULL
-- 3           | 1             | 2021-05-17 | NULL

SELECT e.name, d.name AS department, ed.start_date
FROM employees e
JOIN employee_departments ed ON e.id = ed.employee_id
JOIN departments d ON ed.department_id = d.id
WHERE ed.end_date IS NULL
ORDER BY e.name;

-- Output:
-- name  | department  | start_date
-- ------+-------------+-----------
-- Grace | Engineering | 2024-07-01
-- Omar  | Support     | 2023-01-09
-- Wei   | Sales       | 2021-05-17
Per evitare che qualcuno abbia due reparti attuali, aggiungi un indice univoco parziale: CREATE UNIQUE INDEX idx_current_dept ON employee_departments(employee_id) WHERE end_date IS NULL;. MySQL non supporta gli indici parziali, quindi lì questo non funziona.
Trovare gli utenti che si seguono a vicenda
Una tabella follows collega utenti ad altri utenti. Un vincolo CHECK impedisce a chiunque di seguire se stesso, e il join della tabella con se stessa trova le coppie che si seguono a vicenda:
CREATE TABLE follows (
    follower_id INTEGER NOT NULL,
    followed_id INTEGER NOT NULL,
    PRIMARY KEY (follower_id, followed_id),
    FOREIGN KEY (follower_id) REFERENCES users(id),
    FOREIGN KEY (followed_id) REFERENCES users(id),
    CONSTRAINT no_self_follow CHECK (follower_id <> followed_id)
);

-- INSERT INTO follows VALUES (2, 2);
-- ERROR: new row for relation "follows" violates check constraint "no_self_follow"

-- Input: users
-- id | name
-- ---+-----
-- 1  | Ava
-- 2  | Leo
-- 3  | Mia
-- 4  | Noah

-- Input: follows
-- follower_id | followed_id
-- ------------+------------
-- 1           | 2
-- 2           | 1
-- 1           | 3
-- 3           | 4
-- 4           | 3

SELECT u1.name AS user_a, u2.name AS user_b
FROM follows f
JOIN follows back ON back.follower_id = f.followed_id
                 AND back.followed_id = f.follower_id
JOIN users u1 ON u1.id = f.follower_id
JOIN users u2 ON u2.id = f.followed_id
WHERE f.follower_id < f.followed_id
ORDER BY user_a;

-- Output:
-- user_a | user_b
-- -------+-------
-- Ava    | Leo
-- Mia    | Noah
Ava segue Mia, ma Mia non la segue, quindi quella coppia non compare. La condizione f.follower_id < f.followed_id elenca ogni coppia reciproca una sola volta invece di due.
Approfondimenti sulle relazioni molti a molti
Su questo blog:
- Guida alle relazioni nei database: uno a uno, uno a molti e molti a molti a confronto
- Guida alle relazioni uno a molti: una chiave esterna sul lato “molti”, senza tabella di giunzione
- Relazioni uno a uno nei database: quando ogni riga ha esattamente un partner
- Chiavi primarie composte in SQL: la chiave a due colonne usata da una tabella di giunzione
- Guida ai JOIN SQL con diagrammi: i join che attraversano una tabella di giunzione
- Guida a SQL GROUP BY: contare e sommare tra i collegamenti
Documentazione ufficiale:
- PostgreSQL: chiavi esterne
- MySQL: vincoli FOREIGN KEY
- SQLite: supporto alle chiavi esterne
- SQL Server: vincoli di chiave primaria ed esterna
 Beekeeper Studio è una GUI per database gratuita & open source
Il miglior strumento per query & editor SQL che abbia mai usato. Offre tutto ciò che mi serve per gestire il mio database. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio è veloce, intuitivo e facile da usare. Beekeeper supporta tantissimi database e funziona alla grande su Windows, Mac e Linux.
Cosa dicono gli utenti di Beekeeper Studio
"Beekeeper Studio ha sostituito completamente il mio vecchio flusso di lavoro SQL. È veloce, intuitivo e rende di nuovo piacevole lavorare con i database."
"Ho provato molte GUI per database, ma Beekeeper trova il perfetto equilibrio tra funzionalità e semplicità. Funziona e basta."