
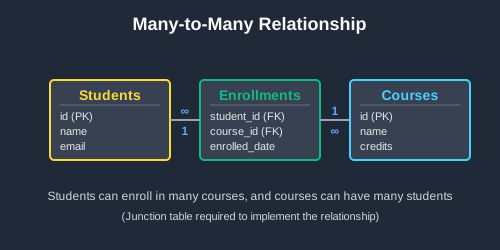
多対多リレーションシップは、どちら側の行も相手側の複数の行と対応できるように 2 つのテーブルを結び付けます。たとえば、1 人の学生は複数の講座を受講し、1 つの講座には複数の学生がいます。これは、リンクごとに 1 行を保存する中間テーブルでモデル化します。サンプルは PostgreSQL、MySQL、SQLite、SQL Server で動作します。
多対多リレーションシップのモデル化方法
3 つ目のテーブルとして中間テーブル(ブリッジテーブル、関連テーブル、結合テーブルとも呼ばれます)を作成し、両側への外部キーを持たせます。各行が 1 つのリンクを表します。つまり「この学生がこの講座を受講している」ということです。
CREATE TABLE students (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
    id INTEGER PRIMARY KEY,
    course_name VARCHAR(100) NOT NULL
);

-- The junction table: one row per student per course
CREATE TABLE enrollments (
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    PRIMARY KEY (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);
一方の側からもう一方へたどるには、中間テーブルを経由して結合します。
-- Input: students
-- id | name
-- ---+------
-- 1  | Ana
-- 2  | Ben
-- 3  | Chloe

-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT s.name, c.course_name
FROM students s
JOIN enrollments e ON s.id = e.student_id
JOIN courses c ON e.course_id = c.id
ORDER BY s.name, c.course_name;

-- Output:
-- name  | course_name
-- ------+------------
-- Ana   | Biology
-- Ana   | Chemistry
-- Ben   | Biology
-- Chloe | Biology
Ana は 2 つの講座を受講し、Biology には 3 人の学生がいるため、リレーションシップは両方向で「多」になります。
押さえておきたいルール
-
ペアを主キーにします。
PRIMARY KEY (student_id, course_id)により、同じリンクが二重に保存されるのを防げます。
-- Input: the enrollments table above

INSERT INTO enrollments VALUES (1, 1);
-- ERROR: duplicate key value violates unique constraint "enrollments_pkey"
-
2 番目の列にインデックスを作成します。 主キーのインデックスは
student_idから始まるため、学生の講座はすでに高速に検索できます。講座の学生を高速に検索するには、course_idから始まるインデックスが必要です(MySQL では外部キーと一緒に自動で作成されます)。
CREATE INDEX idx_enrollments_course_id ON enrollments(course_id);
-
リストではなく、リンクごとに 1 行を保存します。
'1,2'を格納したcourse_ids列は、結合もインデックス作成も外部キーによるチェックもできません。 -
SQLite は有効にするまで外部キーを無視します。 接続ごとに
PRAGMA foreign_keys = ON;を実行してください。そうしないと、SQLite は存在しない学生の受講登録も受け付けてしまいます。
別の書き方
フレームワークによっては、中間テーブルも含めてすべてのテーブルに独自の id 列を持たせます。id だけでは重複リンクを防げないため、ペアに UNIQUE 制約を追加すれば問題ありません。データベース間で異なるのは id 列だけです。
-- PostgreSQL
CREATE TABLE enrollments (
    id SERIAL PRIMARY KEY,
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    UNIQUE (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);

-- MySQL:      id INT AUTO_INCREMENT PRIMARY KEY
-- SQLite:     id INTEGER PRIMARY KEY
-- SQL Server: id INT IDENTITY PRIMARY KEY
外部キーはインラインでも宣言できます: student_id INTEGER NOT NULL REFERENCES students(id)。MySQL 8.0 はこの書き方を受け付けますが黙って無視するため、MySQL では別途 FOREIGN KEY 句を記述してください。
多対多リレーションシップはいつ使うべきか?
両側の行がそれぞれ複数の相手を持てる場合に使います。学生と講座、投稿とタグ、ユーザーとロール、商品とカテゴリなどです。一方の側の各行が常に相手を 1 つしか持たないなら、一対多リレーションシップで十分です。中間テーブルを用意すれば、次のような課題を解決できます。
行のリンク先を調べる
学生はどの講座を受講しているか?投稿にはどのタグが付いているか?行から中間テーブルへ、さらに反対側へと結合します。同じ中間テーブルで両方向の問いに答えられます。
各側のリンク数を数える
最も受講者の多い講座、最もよく使われるタグ、最も多くのクラブに所属するメンバー。一方の側でグループ化し、中間テーブル内の行数を数えます。リンクのない行を消さずに 0 として数えたい場合は LEFT JOIN を使います。
各リンクの詳細を保存する
成績は学生単独や講座単独ではなく「ある講座における学生」に属し、印税の配分は特定の書籍における著者に属します。こうした列を中間テーブルに置けば、他の列と同じようにクエリできます。
同じテーブル内の行を結び付ける
フォロワー、友人、メンターは人と人をつなぎます。中間テーブルの外部キーはどちらも同じテーブルを指すため、そのテーブルを毎回異なるエイリアスで 2 回結合します。
多対多リレーションシップの実例
リスト内のすべてのタグを持つ投稿を探す
タグフィルターは通常「これらのタグをすべて持つ投稿」を意味します。いずれかのタグに一致させてから、すべてに一致した投稿だけを残します。
-- Input: posts
-- id | title
-- ---+----------------
-- 1  | Indexing basics
-- 2  | Weekend hiking
-- 3  | Joins explained

-- Input: tags
-- id | name
-- ---+---------
-- 1  | sql
-- 2  | outdoors
-- 3  | beginner

-- Input: post_tags
-- post_id | tag_id
-- --------+-------
-- 1       | 1
-- 1       | 3
-- 2       | 2
-- 2       | 3
-- 3       | 1

SELECT p.title
FROM posts p
JOIN post_tags pt ON p.id = pt.post_id
JOIN tags t ON pt.tag_id = t.id
WHERE t.name IN ('sql', 'beginner')
GROUP BY p.id, p.title
HAVING COUNT(*) = 2;

-- Output:
-- title
-- ---------------
-- Indexing basics
「Joins explained」は 2 つのタグのうち 1 つしか持たないため、HAVING で除外されます。2 はリスト内のタグ数に合わせて変更してください。
人気の講座を探す
各講座の受講登録数を数えます。LEFT JOIN により、誰も登録していない Physics も残ります。
-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT c.course_name, COUNT(e.student_id) AS student_count
FROM courses c
LEFT JOIN enrollments e ON c.id = e.course_id
GROUP BY c.id, c.course_name
ORDER BY student_count DESC;

-- Output:
-- course_name | student_count
-- ------------+--------------
-- Biology     | 3
-- Chemistry   | 1
-- Physics     | 0
誰がどこでいつ働いたかを記録する
各リンクに開始日と終了日を持たせると、中間テーブルが履歴を保持します。一度離れた部署に戻ることもあるため、ペアは一意ではなくなり、開始日も主キーに加えます。現在の部署は終了日のない行です。
CREATE TABLE employee_departments (
    employee_id INTEGER NOT NULL,
    department_id INTEGER NOT NULL,
    start_date DATE NOT NULL,
    end_date DATE,  -- NULL while it's their current department
    PRIMARY KEY (employee_id, department_id, start_date),
    FOREIGN KEY (employee_id) REFERENCES employees(id),
    FOREIGN KEY (department_id) REFERENCES departments(id)
);

-- Input: employees
-- id | name
-- ---+------
-- 1  | Grace
-- 2  | Omar
-- 3  | Wei

-- Input: departments
-- id | name
-- ---+------------
-- 1  | Sales
-- 2  | Support
-- 3  | Engineering

-- Input: employee_departments
-- employee_id | department_id | start_date | end_date
-- ------------+---------------+------------+-----------
-- 1           | 1             | 2022-03-01 | 2024-06-30
-- 1           | 3             | 2024-07-01 | NULL
-- 2           | 2             | 2023-01-09 | NULL
-- 3           | 1             | 2021-05-17 | NULL

SELECT e.name, d.name AS department, ed.start_date
FROM employees e
JOIN employee_departments ed ON e.id = ed.employee_id
JOIN departments d ON ed.department_id = d.id
WHERE ed.end_date IS NULL
ORDER BY e.name;

-- Output:
-- name  | department  | start_date
-- ------+-------------+-----------
-- Grace | Engineering | 2024-07-01
-- Omar  | Support     | 2023-01-09
-- Wei   | Sales       | 2021-05-17
現在の部署が 2 つにならないようにするには、部分ユニークインデックスを追加します: CREATE UNIQUE INDEX idx_current_dept ON employee_departments(employee_id) WHERE end_date IS NULL;。MySQL には部分インデックスがないため、MySQL ではこれは使えません。
相互フォローしているユーザーを探す
follows テーブルはユーザー同士を結び付けます。CHECK 制約で自分自身のフォローを防ぎ、テーブルを自己結合することで相互フォローのペアを見つけます。
CREATE TABLE follows (
    follower_id INTEGER NOT NULL,
    followed_id INTEGER NOT NULL,
    PRIMARY KEY (follower_id, followed_id),
    FOREIGN KEY (follower_id) REFERENCES users(id),
    FOREIGN KEY (followed_id) REFERENCES users(id),
    CONSTRAINT no_self_follow CHECK (follower_id <> followed_id)
);

-- INSERT INTO follows VALUES (2, 2);
-- ERROR: new row for relation "follows" violates check constraint "no_self_follow"

-- Input: users
-- id | name
-- ---+-----
-- 1  | Ava
-- 2  | Leo
-- 3  | Mia
-- 4  | Noah

-- Input: follows
-- follower_id | followed_id
-- ------------+------------
-- 1           | 2
-- 2           | 1
-- 1           | 3
-- 3           | 4
-- 4           | 3

SELECT u1.name AS user_a, u2.name AS user_b
FROM follows f
JOIN follows back ON back.follower_id = f.followed_id
                 AND back.followed_id = f.follower_id
JOIN users u1 ON u1.id = f.follower_id
JOIN users u2 ON u2.id = f.followed_id
WHERE f.follower_id < f.followed_id
ORDER BY user_a;

-- Output:
-- user_a | user_b
-- -------+-------
-- Ava    | Leo
-- Mia    | Noah
Ava は Mia をフォローしていますが、Mia はフォローし返していないため、このペアは表示されません。f.follower_id < f.followed_id の条件により、相互ペアを 2 回ではなく 1 回だけ表示します。
多対多リレーションシップについてさらに学ぶ
このブログの記事:
- データベースリレーションシップガイド: 一対一、一対多、多対多を比較
- 一対多リレーションシップガイド: 中間テーブルなしで「多」側に外部キーを置く方法
- 一対一のデータベースリレーションシップ: 各行の相手がちょうど 1 つの場合
- SQL の複合主キー: 中間テーブルで使う 2 列のキー
- SQL JOIN 図解ガイド: 中間テーブルをたどる結合
- SQL GROUP BY ガイド: リンクをまたいだ件数や合計の集計
公式ドキュメント:
 Beekeeper Studioは無料のオープンソースのデータベースGUIです
これまで使った中で最高のSQLクエリ&エディタツールです。データベースの管理に必要なものがすべて揃っています。 - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studioは高速で直感的、そして使いやすいツールです。多数のデータベースに対応し、Windows、Mac、Linuxで快適に動作します。
Beekeeper Studio 利用者の声
「Beekeeper Studio は以前の SQL ワークフローを完全に置き換えました。高速で直感的で、データベース作業がまた楽しくなりました。」
「多くのデータベース GUI を試してきましたが、Beekeeper は機能とシンプルさのバランスが完璧です。とにかくちゃんと動きます。」