
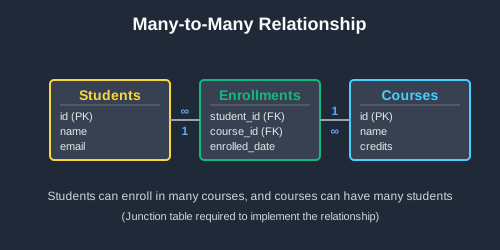
Una relación muchos a muchos une dos tablas en las que una fila de cualquier lado puede coincidir con muchas filas del otro: un estudiante toma muchos cursos y un curso tiene muchos estudiantes. La modelas con una tabla de unión que guarda una fila por cada vínculo. Los ejemplos funcionan en PostgreSQL, MySQL, SQLite y SQL Server.
Cómo modelar una relación muchos a muchos
Crea una tercera tabla, la tabla de unión (también llamada tabla puente, de asociación o intermedia), con una llave foránea hacia cada lado. Cada fila es un vínculo: este estudiante toma este curso.
CREATE TABLE students (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
    id INTEGER PRIMARY KEY,
    course_name VARCHAR(100) NOT NULL
);

-- The junction table: one row per student per course
CREATE TABLE enrollments (
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    PRIMARY KEY (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);
Para ir de un lado al otro, haz el join a través de la tabla de unión:
-- Input: students
-- id | name
-- ---+------
-- 1  | Ana
-- 2  | Ben
-- 3  | Chloe

-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT s.name, c.course_name
FROM students s
JOIN enrollments e ON s.id = e.student_id
JOIN courses c ON e.course_id = c.id
ORDER BY s.name, c.course_name;

-- Output:
-- name  | course_name
-- ------+------------
-- Ana   | Biology
-- Ana   | Chemistry
-- Ben   | Biology
-- Chloe | Biology
Ana toma dos cursos y Biología tiene tres estudiantes, así que la relación es de “muchos” en ambas direcciones.
Reglas que debes conocer
-
Haz que el par sea la llave primaria.
PRIMARY KEY (student_id, course_id)evita que el mismo vínculo se guarde dos veces:
-- Input: the enrollments table above

INSERT INTO enrollments VALUES (1, 1);
-- ERROR: duplicate key value violates unique constraint "enrollments_pkey"
-
Indexa la segunda columna. El índice de la llave primaria empieza con
student_id, así que ya encuentra rápido los cursos de un estudiante. Para encontrar rápido los estudiantes de un curso necesitas un índice que empiece concourse_id(MySQL lo crea por ti junto con la llave foránea):
CREATE INDEX idx_enrollments_course_id ON enrollments(course_id);
-
Guarda una fila por vínculo, nunca una lista. Una columna
course_idsque contiene'1,2'no se puede usar en joins, indexar ni validar con una llave foránea. -
SQLite ignora las llaves foráneas hasta que las activas. Ejecuta
PRAGMA foreign_keys = ON;en cada conexión, o SQLite aceptará una inscripción de un estudiante que no existe.
Sintaxis alternativa
Algunos frameworks le dan a cada tabla su propia columna id, incluidas las tablas de unión. Eso funciona siempre que agregues una restricción UNIQUE sobre el par, porque el id por sí solo no evita vínculos duplicados. Solo la columna id cambia entre bases de datos:
-- PostgreSQL
CREATE TABLE enrollments (
    id SERIAL PRIMARY KEY,
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    UNIQUE (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);

-- MySQL:      id INT AUTO_INCREMENT PRIMARY KEY
-- SQLite:     id INTEGER PRIMARY KEY
-- SQL Server: id INT IDENTITY PRIMARY KEY
También puedes declarar una llave foránea en línea: student_id INTEGER NOT NULL REFERENCES students(id). MySQL 8.0 acepta esa forma pero la ignora sin avisar, así que ahí conserva la cláusula FOREIGN KEY por separado.
¿Cuándo deberías usar una relación muchos a muchos?
Úsala siempre que las filas de ambos lados puedan tener muchas parejas: estudiantes y cursos, posts y etiquetas, usuarios y roles, productos y categorías. Si cada fila de un lado solo tiene una pareja, te basta con una relación uno a muchos. Una vez que tienes la tabla de unión, resuelve estos problemas.
Consulta con qué está vinculada una fila
¿Qué cursos toma un estudiante? ¿Qué etiquetas tiene un post? Haz join desde la fila hacia la tabla de unión y de ahí al otro lado. La misma tabla de unión responde la pregunta en ambas direcciones.
Cuenta los vínculos de cada lado
El curso más lleno, la etiqueta más usada, el miembro con más clubes: agrupa por un lado y cuenta sus filas en la tabla de unión. Usa un LEFT JOIN cuando las filas sin vínculos deban contar como 0 en lugar de desaparecer.
Guarda detalles de cada vínculo
Una calificación pertenece a un estudiante en un curso, no solo al estudiante o al curso, y un porcentaje de regalías pertenece a un autor en un libro específico. Pon estas columnas en la tabla de unión y consúltalas como cualquier otra columna.
Vincula filas de la misma tabla
Seguidores, amigos y mentores conectan personas con otras personas. Las dos llaves foráneas de la tabla de unión apuntan a la misma tabla, así que haces join con esa tabla dos veces, con un alias distinto cada vez.
Ejemplos reales de relaciones muchos a muchos
Encuentra posts que tengan todas las etiquetas de una lista
Un filtro de etiquetas normalmente significa “posts con todas estas etiquetas”. Busca coincidencias con cualquiera de las etiquetas y luego quédate con los posts que coincidieron con todas:
-- Input: posts
-- id | title
-- ---+----------------
-- 1  | Indexing basics
-- 2  | Weekend hiking
-- 3  | Joins explained

-- Input: tags
-- id | name
-- ---+---------
-- 1  | sql
-- 2  | outdoors
-- 3  | beginner

-- Input: post_tags
-- post_id | tag_id
-- --------+-------
-- 1       | 1
-- 1       | 3
-- 2       | 2
-- 2       | 3
-- 3       | 1

SELECT p.title
FROM posts p
JOIN post_tags pt ON p.id = pt.post_id
JOIN tags t ON pt.tag_id = t.id
WHERE t.name IN ('sql', 'beginner')
GROUP BY p.id, p.title
HAVING COUNT(*) = 2;

-- Output:
-- title
-- ---------------
-- Indexing basics
“Joins explained” solo tiene una de las dos etiquetas, así que queda fuera en el HAVING. Cambia el 2 por el número de etiquetas de la lista.
Encuentra los cursos más populares
Cuenta las inscripciones de cada curso. El LEFT JOIN conserva Física, en la que nadie se ha inscrito:
-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT c.course_name, COUNT(e.student_id) AS student_count
FROM courses c
LEFT JOIN enrollments e ON c.id = e.course_id
GROUP BY c.id, c.course_name
ORDER BY student_count DESC;

-- Output:
-- course_name | student_count
-- ------------+--------------
-- Biology     | 3
-- Chemistry   | 1
-- Physics     | 0
Registra quién trabajó dónde y cuándo
Dale a cada vínculo una fecha de inicio y de fin, y la tabla de unión guardará un historial. Alguien puede regresar a un departamento que dejó, así que el par ya no es único y la fecha de inicio pasa a formar parte de la llave primaria. El departamento actual es la fila sin fecha de fin:
CREATE TABLE employee_departments (
    employee_id INTEGER NOT NULL,
    department_id INTEGER NOT NULL,
    start_date DATE NOT NULL,
    end_date DATE,  -- NULL while it's their current department
    PRIMARY KEY (employee_id, department_id, start_date),
    FOREIGN KEY (employee_id) REFERENCES employees(id),
    FOREIGN KEY (department_id) REFERENCES departments(id)
);

-- Input: employees
-- id | name
-- ---+------
-- 1  | Grace
-- 2  | Omar
-- 3  | Wei

-- Input: departments
-- id | name
-- ---+------------
-- 1  | Sales
-- 2  | Support
-- 3  | Engineering

-- Input: employee_departments
-- employee_id | department_id | start_date | end_date
-- ------------+---------------+------------+-----------
-- 1           | 1             | 2022-03-01 | 2024-06-30
-- 1           | 3             | 2024-07-01 | NULL
-- 2           | 2             | 2023-01-09 | NULL
-- 3           | 1             | 2021-05-17 | NULL

SELECT e.name, d.name AS department, ed.start_date
FROM employees e
JOIN employee_departments ed ON e.id = ed.employee_id
JOIN departments d ON ed.department_id = d.id
WHERE ed.end_date IS NULL
ORDER BY e.name;

-- Output:
-- name  | department  | start_date
-- ------+-------------+-----------
-- Grace | Engineering | 2024-07-01
-- Omar  | Support     | 2023-01-09
-- Wei   | Sales       | 2021-05-17
Para evitar que alguien tenga dos departamentos actuales, agrega un índice único parcial: CREATE UNIQUE INDEX idx_current_dept ON employee_departments(employee_id) WHERE end_date IS NULL;. MySQL no tiene índices parciales, así que este no funciona ahí.
Encuentra usuarios que se siguen mutuamente
Una tabla follows vincula usuarios con usuarios. Una restricción CHECK evita que alguien se siga a sí mismo, y hacer join de la tabla consigo misma encuentra los pares que se siguen mutuamente:
CREATE TABLE follows (
    follower_id INTEGER NOT NULL,
    followed_id INTEGER NOT NULL,
    PRIMARY KEY (follower_id, followed_id),
    FOREIGN KEY (follower_id) REFERENCES users(id),
    FOREIGN KEY (followed_id) REFERENCES users(id),
    CONSTRAINT no_self_follow CHECK (follower_id <> followed_id)
);

-- INSERT INTO follows VALUES (2, 2);
-- ERROR: new row for relation "follows" violates check constraint "no_self_follow"

-- Input: users
-- id | name
-- ---+-----
-- 1  | Ava
-- 2  | Leo
-- 3  | Mia
-- 4  | Noah

-- Input: follows
-- follower_id | followed_id
-- ------------+------------
-- 1           | 2
-- 2           | 1
-- 1           | 3
-- 3           | 4
-- 4           | 3

SELECT u1.name AS user_a, u2.name AS user_b
FROM follows f
JOIN follows back ON back.follower_id = f.followed_id
                 AND back.followed_id = f.follower_id
JOIN users u1 ON u1.id = f.follower_id
JOIN users u2 ON u2.id = f.followed_id
WHERE f.follower_id < f.followed_id
ORDER BY user_a;

-- Output:
-- user_a | user_b
-- -------+-------
-- Ava    | Leo
-- Mia    | Noah
Ava sigue a Mia, pero Mia no la sigue de vuelta, así que ese par no aparece. La condición f.follower_id < f.followed_id muestra cada par mutuo una vez en lugar de dos.
Más lecturas sobre relaciones muchos a muchos
En este blog:
- Guía de relaciones de bases de datos: uno a uno, uno a muchos y muchos a muchos lado a lado
- Guía de relaciones uno a muchos: una llave foránea del lado de “muchos”, sin tabla de unión
- Relaciones uno a uno en bases de datos: cuando cada fila tiene exactamente una pareja
- Llaves primarias compuestas en SQL: la llave de dos columnas que usa una tabla de unión
- Guía de diagramas de SQL JOIN: los joins que recorren una tabla de unión
- Guía de SQL GROUP BY: contar y sumar a través de los vínculos
Documentación oficial:
- PostgreSQL: llaves foráneas
- MySQL: restricciones FOREIGN KEY
- SQLite: soporte de llaves foráneas
- SQL Server: restricciones de llave primaria y foránea
 Beekeeper Studio es un cliente de bases de datos gratuito y de código abierto
La mejor herramienta de consultas y edición de SQL que he usado. Tiene todo lo que necesito para administrar mi base de datos. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio es rápido, intuitivo y fácil de usar. Es compatible con muchísimas bases de datos y funciona de maravilla en Windows, Mac y Linux.
Lo que dicen los usuarios de Beekeeper Studio
"Beekeeper Studio reemplazó por completo mi antiguo flujo de trabajo con SQL. Es rápido, intuitivo y hace que trabajar con bases de datos vuelva a ser agradable."
"He probado muchas GUI de bases de datos, pero Beekeeper logra el equilibrio perfecto entre funciones y sencillez. Simplemente funciona."