
Las relaciones uno a uno en bases de datos suelen malinterpretarse y aprovecharse poco. Aunque son el tipo de relación menos común, entender cuándo y cómo implementarlas correctamente puede mejorar mucho el diseño, el rendimiento y la mantenibilidad de tu base de datos.
Esta guía completa cubre todo lo que necesitas saber sobre las relaciones uno a uno, desde los conceptos básicos hasta patrones de implementación avanzados, con ejemplos reales y código SQL práctico.
¿Qué son las relaciones uno a uno?
Una relación uno a uno (1:1) existe cuando cada registro de la Tabla A se relaciona con exactamente un registro de la Tabla B, y viceversa. Esto crea una conexión simétrica en la que la relación funciona en ambas direcciones.
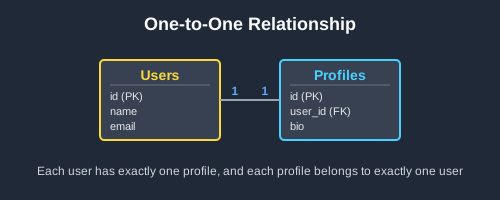
Características clave
- Unicidad bidireccional: cada registro de ambos lados tiene exactamente una coincidencia
- Participación opcional: los registros pueden existir sin una relación
- Integridad referencial: las restricciones de clave foránea mantienen la consistencia de los datos
- Separación lógica: los datos se dividen por razones de organización o rendimiento
Ejemplo conceptual
Piensa en una persona y su pasaporte:
- Cada persona solo puede tener un pasaporte válido
- Cada pasaporte pertenece exactamente a una persona
- Una persona puede no tener pasaporte (opcional)
- Un pasaporte no puede existir sin una persona
Esta relación 1:1 natural la convierte en una candidata ideal para modelarla en la base de datos con tablas separadas.
Cuándo usar relaciones uno a uno
1. Optimización del rendimiento
Divide tablas grandes con muchas columnas para mejorar el rendimiento de las consultas:
-- Frequently queried user data
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    status VARCHAR(20) DEFAULT 'active'
);

-- Rarely accessed profile data
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    bio TEXT,
    preferences JSON,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Beneficios: consultas más rápidas en la tabla principal, menor uso de memoria y mayor eficiencia de los índices.
2. Aislamiento de datos
Separa la información sensible u opcional:
-- Public employee information
CREATE TABLE employees (
    id SERIAL PRIMARY KEY,
    employee_number VARCHAR(20) UNIQUE,
    first_name VARCHAR(50),
    department_id INTEGER
);

-- Restricted HR data
CREATE TABLE employee_hr_details (
    employee_id INTEGER UNIQUE NOT NULL,
    salary DECIMAL(10,2),
    social_security_number VARCHAR(11),
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);
3. Funciones modulares
Activa o desactiva funciones mediante tablas separadas:
-- Base account functionality
CREATE TABLE accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE,
    email VARCHAR(100) UNIQUE
);

-- Premium features (optional)
CREATE TABLE premium_features (
    account_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 100,
    advanced_analytics BOOLEAN DEFAULT true,
    FOREIGN KEY (account_id) REFERENCES accounts(id)
);
Métodos de implementación
Método 1: clave foránea en la tabla dependiente (recomendado)
Coloca la clave foránea en la tabla “extendida” con una restricción única:
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL
);

CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Query with relationship
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
Puntos clave:
- La restricción UNIQUE garantiza la relación 1:1
- LEFT JOIN incluye a los usuarios sin perfil
- El enfoque más flexible para cambios futuros
Método 2: clave primaria compartida
Ambas tablas usan el mismo valor de clave primaria:
CREATE TABLE user_profiles (
    user_id INTEGER PRIMARY KEY,  -- Same as users.id
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Ventajas: rendimiento ligeramente mejor y una relación conceptual más clara.
Desventajas: menos flexible si las reglas de la relación cambian después.
Cómo elegir el método correcto
El Método 1 se recomienda para la mayoría de los casos porque ofrece el mejor equilibrio entre:
- Rendimiento: consultas eficientes con una indexación adecuada
- Flexibilidad: es fácil modificar las reglas de la relación
- Claridad: dependencia clara entre las tablas
El Método 2 funciona bien cuando la relación es realmente parte integral del modelo de negocio y es poco probable que cambie.
Ejemplos reales
Ejemplo 1: sistema de autenticación de usuarios
Separa los datos de autenticación de la información del perfil:
-- Core authentication (frequently accessed)
CREATE TABLE user_accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    password_hash VARCHAR(255) NOT NULL,
    last_login TIMESTAMP
);

-- Extended profile (occasionally accessed)
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    display_name VARCHAR(100),
    bio TEXT,
    avatar_url VARCHAR(255),
    privacy_settings JSON,
    FOREIGN KEY (user_id) REFERENCES user_accounts(id)
);
Beneficios:
- Consultas de inicio de sesión rápidas: la tabla de autenticación se mantiene pequeña y ágil
- Menor uso de memoria: los datos del perfil se cargan solo cuando se necesitan
- Separación clara: autenticación por un lado, presentación por otro
Ejemplo 2: gestión de productos en e-commerce
Separa el catálogo público del inventario interno:
-- Public product catalog
CREATE TABLE products (
    id SERIAL PRIMARY KEY,
    sku VARCHAR(50) UNIQUE NOT NULL,
    name VARCHAR(200) NOT NULL,
    price DECIMAL(10,2) NOT NULL,
    is_active BOOLEAN DEFAULT true
);

-- Internal inventory management
CREATE TABLE product_inventory (
    product_id INTEGER UNIQUE NOT NULL,
    stock_quantity INTEGER DEFAULT 0,
    warehouse_location VARCHAR(100),
    cost_price DECIMAL(10,2),
    reorder_level INTEGER,
    FOREIGN KEY (product_id) REFERENCES products(id)
);
Casos de uso:
- API pública: sirve el catálogo de productos sin exponer el inventario
- Sistemas internos: acceden tanto a los datos de productos como de inventario
- Seguridad: restringe el acceso a la información de costos e inventario
Ejemplo 3: flujo de gestión de contenido
Separa el contenido publicado del flujo editorial:
-- Published articles (public)
CREATE TABLE articles (
    id SERIAL PRIMARY KEY,
    slug VARCHAR(255) UNIQUE NOT NULL,
    title VARCHAR(255) NOT NULL,
    content TEXT NOT NULL,
    published_at TIMESTAMP NOT NULL
);

-- Editorial workflow (internal)
CREATE TABLE article_drafts (
    article_id INTEGER UNIQUE,  -- NULL for unpublished drafts
    title VARCHAR(255),
    content TEXT,
    status VARCHAR(20) DEFAULT 'draft',
    editor_notes TEXT,
    FOREIGN KEY (article_id) REFERENCES articles(id)
);
Beneficios para el flujo de trabajo:
- Interfaz pública limpia: solo se ve el contenido publicado
- Proceso editorial flexible: los borradores pueden existir sin versiones publicadas
- Rendimiento: las consultas públicas no recorren los datos editoriales
Consideraciones de rendimiento
Indexación esencial
Siempre indexa las columnas de clave foránea en las relaciones uno a uno:
-- Basic foreign key indexes
CREATE INDEX idx_user_profiles_user_id ON user_profiles(user_id);
CREATE INDEX idx_product_inventory_product_id ON product_inventory(product_id);

-- Partial indexes for conditional relationships
CREATE INDEX idx_active_premium_features ON premium_features(account_id)
WHERE expires_at > CURRENT_TIMESTAMP;
Buenas prácticas para consultas
Selecciona solo las columnas necesarias: evita SELECT * al unir tablas.
Usa los tipos de JOIN adecuados: LEFT JOIN cuando la relación es opcional, INNER JOIN cuando es obligatoria.
EXISTS vs JOIN: usa EXISTS para comprobar si existe una relación sin recuperar datos.
-- Efficient existence check
SELECT u.username
FROM users u
WHERE EXISTS (
    SELECT 1 FROM user_profiles p
    WHERE p.user_id = u.id
);
Optimización del almacenamiento
Elige tipos de datos adecuados: usa tipos específicos (DATE, BOOLEAN) en lugar de campos de texto genéricos.
Considera la longitud de los campos: limita el tamaño de VARCHAR según los requisitos reales.
JSON para datos complejos: guarda los datos complejos y poco usados como JSON en lugar de usar varias columnas.
Errores comunes y soluciones
Error 1: falta la restricción UNIQUE
Problema: olvidar la restricción UNIQUE permite varios registros relacionados (creando una relación 1:muchos en vez de 1:1).
Solución: siempre incluye UNIQUE en la clave foránea:
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Error 2: tipo de JOIN incorrecto
Problema: usar INNER JOIN excluye los registros sin relación.
Solución: usa los tipos de JOIN adecuados:
-- Include all users (even without profiles)
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
Error 3: reglas de cascada incorrectas
Problema: un comportamiento de cascada incorrecto impide operaciones legítimas.
Solución: elige las reglas de cascada según la lógica de negocio:
- CASCADE: elimina el registro relacionado cuando se elimina el padre
- SET NULL: conserva el registro relacionado y elimina la referencia
- RESTRICT: impide la eliminación si existe un registro relacionado
Error 4: normalizar de más
Problema: crear divisiones 1:1 innecesarias para datos muy relacionados.
Solución: divide tablas solo cuando haya beneficios claros:
- Mejora de rendimiento al dividir la tabla
- Requisitos de seguridad para aislar datos
- Patrones de acceso distintos entre conjuntos de datos
-- Good: Keep frequently accessed data together
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50),
    email VARCHAR(100),
    first_name VARCHAR(50),  -- Keep basic info together
    last_name VARCHAR(50)
);

-- Good: Split large or sensitive data
CREATE TABLE user_extended_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    detailed_bio TEXT,        -- Large field
    salary_expectations DECIMAL -- Sensitive data
);
Patrones avanzados
Relaciones uno a uno condicionales
A veces las relaciones solo aplican bajo ciertas condiciones:
-- Premium settings only for premium users
CREATE TABLE premium_settings (
    user_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 50,
    advanced_features BOOLEAN DEFAULT true,
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Enforce business rule
CREATE UNIQUE INDEX idx_premium_settings
ON premium_settings(user_id)
WHERE EXISTS (
    SELECT 1 FROM users
    WHERE users.id = premium_settings.user_id
    AND account_type = 'premium'
);
Casos de uso: feature flags, niveles de suscripción y datos basados en roles.
Relaciones uno a uno polimórficas
Cuando una tabla se relaciona con varios tipos de entidad distintos:
-- Generic address system
CREATE TABLE addresses (
    addressable_type VARCHAR(50) NOT NULL,  -- 'customer', 'supplier'
    addressable_id INTEGER NOT NULL,
    street_address VARCHAR(255),
    city VARCHAR(100),
    UNIQUE(addressable_type, addressable_id)
);
Beneficios: un solo sistema de direcciones funciona para varios tipos de entidad, con una gestión de direcciones consistente.
Relaciones uno a uno temporales
Registra cómo cambian las relaciones con el tiempo:
-- Employee position history
CREATE TABLE employee_positions (
    employee_id INTEGER NOT NULL,
    title VARCHAR(100),
    effective_date DATE NOT NULL,
    end_date DATE,  -- NULL for current
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);

-- Only one current position per employee
CREATE UNIQUE INDEX idx_current_position
ON employee_positions(employee_id)
WHERE end_date IS NULL;
Aplicaciones: cambios de puesto, historial de suscripciones y transiciones de estado.
Integración con el código de la aplicación
Soporte en ORMs
La mayoría de los ORMs modernos incluyen soporte integrado para relaciones uno a uno:
Ejemplo en Django:
class User(models.Model):
    username = models.CharField(max_length=50, unique=True)
    email = models.EmailField(unique=True)

class UserProfile(models.Model):
    user = models.OneToOneField(User, on_delete=models.CASCADE)
    bio = models.TextField(blank=True)
Ejemplo en Rails:
class User < ApplicationRecord
  has_one :user_profile, dependent: :destroy
end

class UserProfile < ApplicationRecord
  belongs_to :user
end
Patrones de diseño de APIs
Considera estos enfoques para exponer relaciones 1:1 en APIs:
Datos embebidos: incluye los datos relacionados directamente en la respuesta por comodidad.
Endpoints separados: ofrece endpoints dedicados para los datos relacionados y así reducir el tamaño del payload.
Expansión opcional: permite que los clientes soliciten datos relacionados mediante parámetros de consulta (?expand=profile).
Elige según:
- El tamaño de los datos y la frecuencia de acceso
- Los requisitos de rendimiento
- Las necesidades de flexibilidad del cliente
Conclusión
Las relaciones uno a uno son una herramienta poderosa para organizar datos de forma eficiente y segura. Aunque son menos comunes que otros tipos de relación, ofrecen beneficios cruciales para optimizar el rendimiento, reforzar la seguridad mediante el aislamiento de datos y lograr una separación limpia de responsabilidades.
Puntos clave:
- Usa siempre restricciones UNIQUE en las claves foráneas para garantizar la relación 1:1
- Elige reglas de cascada adecuadas según tu lógica de negocio
- Indexa las columnas de clave foránea para un rendimiento óptimo en las consultas
- Usa LEFT JOIN al consultar para incluir registros sin relación
- No normalices de más: divide tablas solo cuando haya un beneficio claro
- Considera los patrones de acceso al decidir si dividir tablas
Cuándo usar relaciones 1:1:
- Tablas grandes que necesitan optimizar su rendimiento
- Datos sensibles que requieren control de acceso
- Datos opcionales que se consultan poco
- Funciones modulares que se pueden activar o desactivar
Lecturas relacionadas:
- Entendiendo las relaciones en bases de datos: guía completa para principiantes
- Relaciones uno a muchos en bases de datos: guía completa
- Relaciones muchos a muchos en bases de datos: guía completa
- SQL JOINs para principiantes con diagramas
Practica estos patrones con Beekeeper Studio, donde puedes visualizar las relaciones entre tus tablas y probar tus consultas con datos reales.
 Beekeeper Studio es un cliente de bases de datos gratuito y de código abierto
La mejor herramienta de consultas y edición de SQL que he usado. Tiene todo lo que necesito para administrar mi base de datos. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio es rápido, intuitivo y fácil de usar. Es compatible con muchísimas bases de datos y funciona de maravilla en Windows, Mac y Linux.
Lo que dicen los usuarios de Beekeeper Studio
"Beekeeper Studio reemplazó por completo mi antiguo flujo de trabajo con SQL. Es rápido, intuitivo y hace que trabajar con bases de datos vuelva a ser agradable."
"He probado muchas GUIs de bases de datos, pero Beekeeper logra el equilibrio perfecto entre funciones y simplicidad. Simplemente funciona."