
Le relazioni uno a uno nei database sono spesso fraintese e poco sfruttate. Anche se sono il tipo di relazione meno comune, capire quando e come implementarle correttamente può migliorare in modo significativo il design, le prestazioni e la manutenibilità del tuo database.
Questa guida completa copre tutto ciò che devi sapere sulle relazioni uno a uno, dai concetti di base ai pattern di implementazione avanzati, con esempi reali e codice SQL pratico.
Cosa sono le relazioni uno a uno?
Una relazione uno a uno (1:1) esiste quando ogni record della tabella A è collegato esattamente a un record della tabella B, e viceversa. Si crea così un collegamento simmetrico in cui la relazione funziona in entrambe le direzioni.
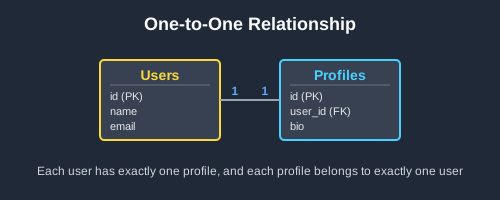
Caratteristiche principali
- Unicità bidirezionale: ogni record su entrambi i lati ha esattamente una corrispondenza
- Partecipazione facoltativa: i record possono esistere anche senza relazione
- Integrità referenziale: i vincoli di foreign key mantengono i dati coerenti
- Separazione logica: i dati vengono suddivisi per motivi organizzativi o di prestazioni
Esempio concettuale
Pensa a una persona e al suo passaporto:
- Ogni persona può avere un solo passaporto valido
- Ogni passaporto appartiene esattamente a una persona
- Una persona può non avere un passaporto (facoltativo)
- Un passaporto non può esistere senza una persona
Questa relazione 1:1 naturale la rende un candidato ideale per la modellazione del database con tabelle separate.
Quando usare le relazioni uno a uno
1. Ottimizzazione delle prestazioni
Suddividi le tabelle grandi con molte colonne per migliorare le prestazioni delle query:
-- Frequently queried user data
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    status VARCHAR(20) DEFAULT 'active'
);

-- Rarely accessed profile data
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    bio TEXT,
    preferences JSON,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Vantaggi: query più veloci sulla tabella principale, minore uso di memoria, indici più efficienti.
2. Isolamento dei dati
Separa le informazioni sensibili o facoltative:
-- Public employee information
CREATE TABLE employees (
    id SERIAL PRIMARY KEY,
    employee_number VARCHAR(20) UNIQUE,
    first_name VARCHAR(50),
    department_id INTEGER
);

-- Restricted HR data
CREATE TABLE employee_hr_details (
    employee_id INTEGER UNIQUE NOT NULL,
    salary DECIMAL(10,2),
    social_security_number VARCHAR(11),
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);
3. Funzionalità modulari
Attiva/disattiva funzionalità tramite tabelle separate:
-- Base account functionality
CREATE TABLE accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE,
    email VARCHAR(100) UNIQUE
);

-- Premium features (optional)
CREATE TABLE premium_features (
    account_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 100,
    advanced_analytics BOOLEAN DEFAULT true,
    FOREIGN KEY (account_id) REFERENCES accounts(id)
);
Metodi di implementazione
Metodo 1: foreign key nella tabella dipendente (consigliato)
Inserisci la foreign key nella tabella “di estensione” con un vincolo di unicità:
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL
);

CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Query with relationship
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
Punti chiave:
- Il vincolo UNIQUE impone la relazione 1:1
- LEFT JOIN include gli utenti senza profilo
- L'approccio più flessibile per modifiche future
Metodo 2: primary key condivisa
Entrambe le tabelle usano lo stesso valore di primary key:
CREATE TABLE user_profiles (
    user_id INTEGER PRIMARY KEY,  -- Same as users.id
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Vantaggi: prestazioni leggermente migliori, relazione concettualmente più chiara.
Svantaggi: meno flessibile se le regole della relazione cambiano in seguito.
Scegliere il metodo giusto
Il Metodo 1 è consigliato nella maggior parte dei casi perché offre il miglior equilibrio tra:
- Prestazioni - query efficienti con indici adeguati
- Flessibilità - regole della relazione facili da modificare
- Chiarezza - dipendenza chiara tra le tabelle
Il Metodo 2 funziona bene quando la relazione è davvero parte integrante del modello di business ed è improbabile che cambi.
Esempi reali
Esempio 1: sistema di autenticazione utenti
Separa i dati di autenticazione dalle informazioni del profilo:
-- Core authentication (frequently accessed)
CREATE TABLE user_accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    password_hash VARCHAR(255) NOT NULL,
    last_login TIMESTAMP
);

-- Extended profile (occasionally accessed)
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    display_name VARCHAR(100),
    bio TEXT,
    avatar_url VARCHAR(255),
    privacy_settings JSON,
    FOREIGN KEY (user_id) REFERENCES user_accounts(id)
);
Vantaggi:
- Query di login veloci - la tabella di autenticazione resta piccola e rapida
- Minore uso di memoria - i dati del profilo vengono caricati solo quando servono
- Separazione chiara - autenticazione distinta dalla presentazione
Esempio 2: gestione prodotti e-commerce
Separa il catalogo pubblico dall'inventario interno:
-- Public product catalog
CREATE TABLE products (
    id SERIAL PRIMARY KEY,
    sku VARCHAR(50) UNIQUE NOT NULL,
    name VARCHAR(200) NOT NULL,
    price DECIMAL(10,2) NOT NULL,
    is_active BOOLEAN DEFAULT true
);

-- Internal inventory management
CREATE TABLE product_inventory (
    product_id INTEGER UNIQUE NOT NULL,
    stock_quantity INTEGER DEFAULT 0,
    warehouse_location VARCHAR(100),
    cost_price DECIMAL(10,2),
    reorder_level INTEGER,
    FOREIGN KEY (product_id) REFERENCES products(id)
);
Casi d'uso:
- API pubblica - fornisce il catalogo prodotti senza esporre l'inventario
- Sistemi interni - accedono sia ai dati dei prodotti sia all'inventario
- Sicurezza - limita l'accesso alle informazioni su costi/inventario
Esempio 3: workflow di gestione dei contenuti
Separa i contenuti pubblicati dal workflow editoriale:
-- Published articles (public)
CREATE TABLE articles (
    id SERIAL PRIMARY KEY,
    slug VARCHAR(255) UNIQUE NOT NULL,
    title VARCHAR(255) NOT NULL,
    content TEXT NOT NULL,
    published_at TIMESTAMP NOT NULL
);

-- Editorial workflow (internal)
CREATE TABLE article_drafts (
    article_id INTEGER UNIQUE,  -- NULL for unpublished drafts
    title VARCHAR(255),
    content TEXT,
    status VARCHAR(20) DEFAULT 'draft',
    editor_notes TEXT,
    FOREIGN KEY (article_id) REFERENCES articles(id)
);
Vantaggi per il workflow:
- Interfaccia pubblica pulita - sono visibili solo i contenuti pubblicati
- Processo editoriale flessibile - le bozze possono esistere senza versioni pubblicate
- Prestazioni - le query pubbliche non scansionano i dati editoriali
Considerazioni sulle prestazioni
Indici essenziali
Indicizza sempre le colonne foreign key nelle relazioni uno a uno:
-- Basic foreign key indexes
CREATE INDEX idx_user_profiles_user_id ON user_profiles(user_id);
CREATE INDEX idx_product_inventory_product_id ON product_inventory(product_id);

-- Partial indexes for conditional relationships
CREATE INDEX idx_active_premium_features ON premium_features(account_id)
WHERE expires_at > CURRENT_TIMESTAMP;
Best practice per le query
Seleziona solo le colonne necessarie: evita SELECT * quando unisci le tabelle.
Usa i tipi di JOIN appropriati: LEFT JOIN quando la relazione è facoltativa, INNER JOIN quando è obbligatoria.
EXISTS vs JOIN: usa EXISTS per verificare l'esistenza di una relazione senza recuperare i dati.
-- Efficient existence check
SELECT u.username
FROM users u
WHERE EXISTS (
    SELECT 1 FROM user_profiles p
    WHERE p.user_id = u.id
);
Ottimizzazione dello storage
Scegli tipi di dati appropriati: usa tipi specifici (DATE, BOOLEAN) invece di campi di testo generici.
Valuta la lunghezza dei campi: limita le dimensioni dei VARCHAR in base alle esigenze reali.
JSON per dati complessi: salva i dati complessi e usati di rado come JSON invece che in più colonne.
Errori comuni e soluzioni
Errore 1: vincolo UNIQUE mancante
Problema: dimenticare il vincolo UNIQUE permette più record collegati (creando una relazione 1:molti invece di 1:1).
Soluzione: includi sempre UNIQUE sulla foreign key:
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Errore 2: tipo di JOIN sbagliato
Problema: usare INNER JOIN esclude i record senza relazione.
Soluzione: usa i tipi di JOIN appropriati:
-- Include all users (even without profiles)
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
Errore 3: regole di cascade errate
Problema: un comportamento di cascade sbagliato impedisce operazioni legittime.
Soluzione: scegli le regole di cascade in base alla logica di business:
- CASCADE: elimina il record collegato quando viene eliminato il parent
- SET NULL: mantiene il record collegato, rimuove il riferimento
- RESTRICT: impedisce l'eliminazione se esiste un record collegato
Errore 4: normalizzazione eccessiva
Problema: creare suddivisioni 1:1 inutili per dati strettamente correlati.
Soluzione: suddividi le tabelle solo quando ci sono vantaggi chiari:
- Miglioramento delle prestazioni grazie alla suddivisione
- Requisiti di sicurezza per l'isolamento dei dati
- Pattern di accesso diversi tra gruppi di dati
-- Good: Keep frequently accessed data together
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50),
    email VARCHAR(100),
    first_name VARCHAR(50),  -- Keep basic info together
    last_name VARCHAR(50)
);

-- Good: Split large or sensitive data
CREATE TABLE user_extended_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    detailed_bio TEXT,        -- Large field
    salary_expectations DECIMAL -- Sensitive data
);
Pattern avanzati
Relazioni uno a uno condizionali
A volte le relazioni valgono solo in determinate condizioni:
-- Premium settings only for premium users
CREATE TABLE premium_settings (
    user_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 50,
    advanced_features BOOLEAN DEFAULT true,
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Enforce business rule
CREATE UNIQUE INDEX idx_premium_settings
ON premium_settings(user_id)
WHERE EXISTS (
    SELECT 1 FROM users
    WHERE users.id = premium_settings.user_id
    AND account_type = 'premium'
);
Casi d'uso: feature flag, livelli di abbonamento, dati basati sui ruoli.
Relazioni uno a uno polimorfiche
Quando una tabella è collegata a più tipi di entità diversi:
-- Generic address system
CREATE TABLE addresses (
    addressable_type VARCHAR(50) NOT NULL,  -- 'customer', 'supplier'
    addressable_id INTEGER NOT NULL,
    street_address VARCHAR(255),
    city VARCHAR(100),
    UNIQUE(addressable_type, addressable_id)
);
Vantaggi: un unico sistema di indirizzi funziona per più tipi di entità, con una gestione degli indirizzi coerente.
Relazioni uno a uno temporali
Traccia come cambiano le relazioni nel tempo:
-- Employee position history
CREATE TABLE employee_positions (
    employee_id INTEGER NOT NULL,
    title VARCHAR(100),
    effective_date DATE NOT NULL,
    end_date DATE,  -- NULL for current
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);

-- Only one current position per employee
CREATE UNIQUE INDEX idx_current_position
ON employee_positions(employee_id)
WHERE end_date IS NULL;
Applicazioni: cambi di ruolo, storico degli abbonamenti, transizioni di stato.
Integrazione con il codice applicativo
Supporto ORM
La maggior parte degli ORM moderni offre supporto nativo per le relazioni uno a uno:
Esempio Django:
class User(models.Model):
    username = models.CharField(max_length=50, unique=True)
    email = models.EmailField(unique=True)

class UserProfile(models.Model):
    user = models.OneToOneField(User, on_delete=models.CASCADE)
    bio = models.TextField(blank=True)
Esempio Rails:
class User < ApplicationRecord
  has_one :user_profile, dependent: :destroy
end

class UserProfile < ApplicationRecord
  belongs_to :user
end
Pattern di design delle API
Valuta questi approcci per esporre le relazioni 1:1 nelle API:
Dati incorporati: includi i dati collegati direttamente nella risposta per comodità.
Endpoint separati: fornisci endpoint dedicati per i dati collegati per ridurre la dimensione del payload.
Espansione facoltativa: consenti ai client di richiedere i dati collegati tramite parametri di query (?expand=profile).
Scegli in base a:
- Dimensione dei dati e frequenza di accesso
- Requisiti di prestazioni
- Esigenze di flessibilità dei client
Conclusione
Le relazioni uno a uno nei database sono uno strumento potente per organizzare i dati in modo efficiente e sicuro. Anche se meno comuni di altri tipi di relazione, offrono vantaggi cruciali per l'ottimizzazione delle prestazioni, la sicurezza tramite isolamento dei dati e una netta separazione delle responsabilità.
Punti chiave:
- Usa sempre vincoli UNIQUE sulle foreign key per imporre la relazione 1:1
- Scegli regole di cascade appropriate in base alla tua logica di business
- Indicizza le colonne foreign key per prestazioni ottimali delle query
- Usa LEFT JOIN nelle query per includere i record senza relazione
- Non normalizzare troppo - suddividi le tabelle solo quando c'è un vantaggio chiaro
- Considera i pattern di accesso quando decidi se suddividere le tabelle
Quando usare le relazioni 1:1:
- Tabelle grandi che richiedono ottimizzazione delle prestazioni
- Dati sensibili che richiedono controllo degli accessi
- Dati facoltativi usati di rado
- Funzionalità modulari che si possono attivare/disattivare
Letture correlate:
- Capire le relazioni nei database: guida completa per principianti
- Relazioni uno a molti nei database: guida completa
- Relazioni molti a molti nei database: guida completa
- JOIN SQL per principianti con diagrammi
Esercitati a implementare questi pattern con Beekeeper Studio, dove puoi visualizzare le relazioni tra le tabelle e testare le tue query con dati reali.
 Beekeeper Studio è una GUI per database gratuita & open source
Il miglior strumento per query & editor SQL che abbia mai usato. Offre tutto ciò che mi serve per gestire il mio database. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio è veloce, intuitivo e facile da usare. Beekeeper supporta tantissimi database e funziona alla grande su Windows, Mac e Linux.
Cosa dicono gli utenti di Beekeeper Studio
"Beekeeper Studio ha sostituito completamente il mio vecchio workflow SQL. È veloce, intuitivo e rende di nuovo piacevole lavorare con i database."
"Ho provato molte GUI per database, ma Beekeeper trova il perfetto equilibrio tra funzionalità e semplicità. Funziona e basta."