
일대일 데이터베이스 관계는 자주 오해받고 잘 활용되지 않아요. 가장 드문 관계 유형이지만, 언제 어떻게 제대로 구현하는지 이해하면 데이터베이스 설계, 성능, 유지보수성을 크게 개선할 수 있어요.
이 가이드에서는 기본 개념부터 고급 구현 패턴까지 일대일 관계에 대해 알아야 할 모든 것을 실제 예제와 실용적인 SQL 코드와 함께 다뤄요.
일대일 관계란 무엇인가요?
일대일(1:1) 관계는 테이블 A의 각 레코드가 테이블 B의 정확히 하나의 레코드와 연결되고, 그 반대도 성립할 때 존재해요. 이렇게 하면 관계가 양방향으로 작동하는 대칭적인 연결이 만들어져요.
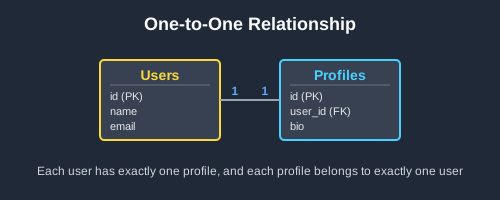
주요 특징
- 양방향 고유성: 양쪽의 각 레코드가 정확히 하나의 짝을 가져요
- 선택적 참여: 관계 없이 존재하는 레코드도 있을 수 있어요
- 참조 무결성: 외래 키 제약 조건이 데이터 일관성을 유지해요
- 논리적 분리: 구조나 성능상의 이유로 데이터를 나눠요
개념 예시
사람과 여권을 생각해 보세요:
- 각 사람은 유효한 여권을 하나만 가질 수 있어요
- 각 여권은 정확히 한 사람에게 속해요
- 여권이 없는 사람도 있을 수 있어요(선택적)
- 사람 없이 여권은 존재할 수 없어요
이런 자연스러운 1:1 관계는 별도 테이블을 사용한 데이터베이스 모델링에 이상적인 대상이에요.
일대일 관계를 사용해야 할 때
1. 성능 최적화
컬럼이 많은 큰 테이블을 분할해 쿼리 성능을 높이세요:
-- Frequently queried user data
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    status VARCHAR(20) DEFAULT 'active'
);

-- Rarely accessed profile data
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    bio TEXT,
    preferences JSON,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
장점: 메인 테이블 쿼리 속도 향상, 메모리 사용량 감소, 인덱스 효율 개선.
2. 데이터 격리
민감하거나 선택적인 정보를 분리하세요:
-- Public employee information
CREATE TABLE employees (
    id SERIAL PRIMARY KEY,
    employee_number VARCHAR(20) UNIQUE,
    first_name VARCHAR(50),
    department_id INTEGER
);

-- Restricted HR data
CREATE TABLE employee_hr_details (
    employee_id INTEGER UNIQUE NOT NULL,
    salary DECIMAL(10,2),
    social_security_number VARCHAR(11),
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);
3. 모듈식 기능
별도 테이블로 기능을 켜고 끌 수 있어요:
-- Base account functionality
CREATE TABLE accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE,
    email VARCHAR(100) UNIQUE
);

-- Premium features (optional)
CREATE TABLE premium_features (
    account_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 100,
    advanced_analytics BOOLEAN DEFAULT true,
    FOREIGN KEY (account_id) REFERENCES accounts(id)
);
구현 방법
방법 1: 종속 테이블에 외래 키 두기(권장)
“확장” 테이블에 고유 제약 조건과 함께 외래 키를 두세요:
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL
);

CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Query with relationship
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
핵심 포인트:
- UNIQUE 제약 조건이 1:1 관계를 강제해요
- LEFT JOIN은 프로필이 없는 사용자도 포함해요
- 향후 변경에 가장 유연한 방식이에요
방법 2: 기본 키 공유
두 테이블이 같은 기본 키 값을 사용해요:
CREATE TABLE user_profiles (
    user_id INTEGER PRIMARY KEY,  -- Same as users.id
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);
장점: 약간 더 나은 성능, 더 명확한 개념적 관계.
단점: 나중에 관계 규칙이 바뀌면 유연성이 떨어져요.
올바른 방법 선택하기
대부분의 경우 방법 1을 권장해요. 다음 요소 사이에서 가장 좋은 균형을 제공하기 때문이에요:
- 성능 - 적절한 인덱싱으로 효율적인 쿼리
- 유연성 - 관계 규칙을 쉽게 수정 가능
- 명확성 - 테이블 간 의존성이 분명함
방법 2는 관계가 비즈니스 모델에 본질적이고 바뀔 가능성이 낮을 때 잘 맞아요.
실제 예제
예제 1: 사용자 인증 시스템
인증 데이터를 프로필 정보와 분리하세요:
-- Core authentication (frequently accessed)
CREATE TABLE user_accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    password_hash VARCHAR(255) NOT NULL,
    last_login TIMESTAMP
);

-- Extended profile (occasionally accessed)
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    display_name VARCHAR(100),
    bio TEXT,
    avatar_url VARCHAR(255),
    privacy_settings JSON,
    FOREIGN KEY (user_id) REFERENCES user_accounts(id)
);
장점:
- 빠른 로그인 쿼리 - 인증 테이블이 작고 빠르게 유지돼요
- 메모리 사용량 감소 - 프로필 데이터는 필요할 때만 불러와요
- 명확한 분리 - 인증과 표시 관심사를 구분해요
예제 2: 이커머스 상품 관리
공개 카탈로그를 내부 재고와 분리하세요:
-- Public product catalog
CREATE TABLE products (
    id SERIAL PRIMARY KEY,
    sku VARCHAR(50) UNIQUE NOT NULL,
    name VARCHAR(200) NOT NULL,
    price DECIMAL(10,2) NOT NULL,
    is_active BOOLEAN DEFAULT true
);

-- Internal inventory management
CREATE TABLE product_inventory (
    product_id INTEGER UNIQUE NOT NULL,
    stock_quantity INTEGER DEFAULT 0,
    warehouse_location VARCHAR(100),
    cost_price DECIMAL(10,2),
    reorder_level INTEGER,
    FOREIGN KEY (product_id) REFERENCES products(id)
);
사용 사례:
- 공개 API - 재고를 노출하지 않고 상품 카탈로그 제공
- 내부 시스템 - 상품과 재고 데이터 모두 접근
- 보안 - 원가/재고 정보 접근 제한
예제 3: 콘텐츠 관리 워크플로
게시된 콘텐츠를 편집 워크플로와 분리하세요:
-- Published articles (public)
CREATE TABLE articles (
    id SERIAL PRIMARY KEY,
    slug VARCHAR(255) UNIQUE NOT NULL,
    title VARCHAR(255) NOT NULL,
    content TEXT NOT NULL,
    published_at TIMESTAMP NOT NULL
);

-- Editorial workflow (internal)
CREATE TABLE article_drafts (
    article_id INTEGER UNIQUE,  -- NULL for unpublished drafts
    title VARCHAR(255),
    content TEXT,
    status VARCHAR(20) DEFAULT 'draft',
    editor_notes TEXT,
    FOREIGN KEY (article_id) REFERENCES articles(id)
);
워크플로 장점:
- 깔끔한 공개 인터페이스 - 게시된 콘텐츠만 표시돼요
- 유연한 편집 프로세스 - 게시 버전 없이도 초안이 존재할 수 있어요
- 성능 - 공개 쿼리가 편집 데이터를 스캔하지 않아요
성능 고려 사항
필수 인덱싱
일대일 관계에서는 항상 외래 키 컬럼에 인덱스를 만드세요:
-- Basic foreign key indexes
CREATE INDEX idx_user_profiles_user_id ON user_profiles(user_id);
CREATE INDEX idx_product_inventory_product_id ON product_inventory(product_id);

-- Partial indexes for conditional relationships
CREATE INDEX idx_active_premium_features ON premium_features(account_id)
WHERE expires_at > CURRENT_TIMESTAMP;
쿼리 모범 사례
필요한 컬럼만 선택하세요: 테이블을 조인할 때 SELECT *는 피하세요.
적절한 JOIN 유형을 사용하세요: 관계가 선택적이면 LEFT JOIN, 필수라면 INNER JOIN을 쓰세요.
EXISTS vs JOIN: 데이터를 가져오지 않고 관계 존재 여부만 확인할 때는 EXISTS를 쓰세요.
-- Efficient existence check
SELECT u.username
FROM users u
WHERE EXISTS (
    SELECT 1 FROM user_profiles p
    WHERE p.user_id = u.id
);
스토리지 최적화
적절한 데이터 타입을 고르세요: 범용 텍스트 필드 대신 구체적인 타입(DATE, BOOLEAN)을 사용하세요.
필드 길이를 고려하세요: 실제 요구 사항에 맞춰 VARCHAR 크기를 제한하세요.
복잡한 데이터에는 JSON: 자주 쓰지 않는 복잡한 데이터는 여러 컬럼 대신 JSON으로 저장하세요.
흔한 실수와 해결책
실수 1: UNIQUE 제약 조건 누락
문제: UNIQUE 제약 조건을 빠뜨리면 여러 관련 레코드가 허용돼요(1:1이 아닌 1:N이 됨).
해결책: 외래 키에 항상 UNIQUE를 지정하세요:
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
실수 2: 잘못된 JOIN 유형
문제: INNER JOIN을 쓰면 관계가 없는 레코드가 제외돼요.
해결책: 적절한 JOIN 유형을 사용하세요:
-- Include all users (even without profiles)
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
실수 3: 잘못된 Cascade 규칙
문제: 잘못된 cascade 동작이 정상적인 작업을 막아요.
해결책: 비즈니스 로직에 따라 cascade 규칙을 고르세요:
- CASCADE: 부모가 삭제되면 관련 레코드도 삭제
- SET NULL: 관련 레코드는 유지하고 참조만 제거
- RESTRICT: 관련 레코드가 있으면 삭제 방지
실수 4: 과도한 정규화
문제: 밀접하게 관련된 데이터를 불필요하게 1:1로 분할해요.
해결책: 분명한 이점이 있을 때만 테이블을 분할하세요:
- 테이블 분할로 인한 성능 향상
- 데이터 격리를 위한 보안 요구 사항
- 데이터 세트 간 서로 다른 접근 패턴
-- Good: Keep frequently accessed data together
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50),
    email VARCHAR(100),
    first_name VARCHAR(50),  -- Keep basic info together
    last_name VARCHAR(50)
);

-- Good: Split large or sensitive data
CREATE TABLE user_extended_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    detailed_bio TEXT,        -- Large field
    salary_expectations DECIMAL -- Sensitive data
);
고급 패턴
조건부 일대일 관계
관계가 특정 조건에서만 적용되는 경우도 있어요:
-- Premium settings only for premium users
CREATE TABLE premium_settings (
    user_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 50,
    advanced_features BOOLEAN DEFAULT true,
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Enforce business rule
CREATE UNIQUE INDEX idx_premium_settings
ON premium_settings(user_id)
WHERE EXISTS (
    SELECT 1 FROM users
    WHERE users.id = premium_settings.user_id
    AND account_type = 'premium'
);
사용 사례: 기능 플래그, 구독 등급, 역할 기반 데이터.
다형성 일대일 관계
하나의 테이블이 여러 다른 엔터티 유형과 연결될 때:
-- Generic address system
CREATE TABLE addresses (
    addressable_type VARCHAR(50) NOT NULL,  -- 'customer', 'supplier'
    addressable_id INTEGER NOT NULL,
    street_address VARCHAR(255),
    city VARCHAR(100),
    UNIQUE(addressable_type, addressable_id)
);
장점: 하나의 주소 시스템을 여러 엔터티 유형에 걸쳐 사용하고, 주소를 일관되게 관리할 수 있어요.
시간 기반 일대일 관계
관계가 시간에 따라 어떻게 바뀌는지 추적하세요:
-- Employee position history
CREATE TABLE employee_positions (
    employee_id INTEGER NOT NULL,
    title VARCHAR(100),
    effective_date DATE NOT NULL,
    end_date DATE,  -- NULL for current
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);

-- Only one current position per employee
CREATE UNIQUE INDEX idx_current_position
ON employee_positions(employee_id)
WHERE end_date IS NULL;
활용 분야: 직책 변경, 구독 이력, 상태 전환.
애플리케이션 코드와의 통합
ORM 지원
대부분의 최신 ORM은 일대일 관계를 기본으로 지원해요:
Django 예제:
class User(models.Model):
    username = models.CharField(max_length=50, unique=True)
    email = models.EmailField(unique=True)

class UserProfile(models.Model):
    user = models.OneToOneField(User, on_delete=models.CASCADE)
    bio = models.TextField(blank=True)
Rails 예제:
class User < ApplicationRecord
  has_one :user_profile, dependent: :destroy
end

class UserProfile < ApplicationRecord
  belongs_to :user
end
API 설계 패턴
API에서 1:1 관계를 노출할 때 다음 방식을 고려해 보세요:
임베디드 데이터: 편의를 위해 관련 데이터를 응답에 바로 포함해요.
별도 엔드포인트: 페이로드 크기를 줄이기 위해 관련 데이터 전용 엔드포인트를 제공해요.
선택적 확장: 클라이언트가 쿼리 파라미터(?expand=profile)로 관련 데이터를 요청할 수 있게 해요.
선택 기준:
- 데이터 크기와 접근 빈도
- 성능 요구 사항
- 클라이언트의 유연성 요구
결론
일대일 데이터베이스 관계는 데이터를 효율적이고 안전하게 구성하는 강력한 도구예요. 다른 관계 유형보다 드물지만, 성능 최적화, 데이터 격리를 통한 보안, 깔끔한 관심사 분리라는 중요한 이점을 제공해요.
핵심 요약:
- 1:1 관계를 강제하려면 외래 키에 항상 UNIQUE 제약 조건을 사용하세요
- 비즈니스 로직에 따라 적절한 cascade 규칙을 고르세요
- 최적의 쿼리 성능을 위해 외래 키 컬럼에 인덱스를 만드세요
- 관계가 없는 레코드도 포함하려면 쿼리할 때 LEFT JOIN을 사용하세요
- 과도하게 정규화하지 마세요 - 분명한 이점이 있을 때만 테이블을 분할하세요
- 테이블 분할 여부를 결정할 때 접근 패턴을 고려하세요
1:1 관계를 사용할 때:
- 성능 최적화가 필요한 큰 테이블
- 접근 제어가 필요한 민감한 데이터
- 거의 접근하지 않는 선택적 데이터
- 켜고 끌 수 있는 모듈식 기능
관련 글:
- 데이터베이스 관계 이해하기: 초보자를 위한 종합 가이드
- 일대다 데이터베이스 관계: 완벽 가이드
- 다대다 데이터베이스 관계: 완벽 가이드
- 다이어그램으로 배우는 초보자용 SQL JOIN
Beekeeper Studio에서 이 패턴들을 직접 구현해 보세요. 테이블 관계를 시각화하고 실제 데이터로 쿼리를 테스트할 수 있어요.
 Beekeeper Studio는 무료 오픈 소스 데이터베이스 GUI예요
지금까지 써 본 SQL 쿼리 & 에디터 도구 중 최고예요. 데이터베이스 관리에 필요한 모든 게 다 있어요. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio는 빠르고 직관적이며 사용하기 쉬워요. 다양한 데이터베이스를 지원하고 Windows, Mac, Linux에서 모두 잘 작동해요.
Beekeeper Studio 사용자 후기
"Beekeeper Studio가 기존 SQL 워크플로를 완전히 대체했어요. 빠르고 직관적이라 데이터베이스 작업이 다시 즐거워졌어요."
"여러 데이터베이스 GUI를 써 봤지만, Beekeeper는 기능과 단순함 사이의 균형이 완벽해요. 그냥 잘 작동해요."