
Relacionamentos um-para-um em bancos de dados costumam ser mal compreendidos e pouco utilizados. Embora sejam o tipo de relacionamento menos comum, entender quando e como implementá-los corretamente pode melhorar significativamente o design, o desempenho e a manutenibilidade do seu banco de dados.
Este guia completo cobre tudo o que você precisa saber sobre relacionamentos um-para-um, de conceitos básicos a padrões avançados de implementação, com exemplos reais e código SQL prático.
O que são relacionamentos um-para-um?
Um relacionamento um-para-um (1:1) existe quando cada registro da Tabela A se relaciona com exatamente um registro da Tabela B, e vice-versa. Isso cria uma conexão simétrica, em que o relacionamento funciona nas duas direções.
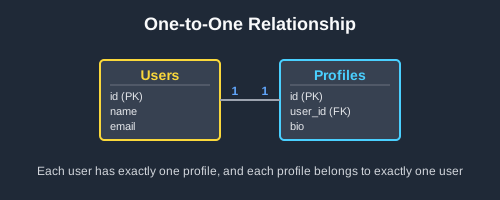
Principais características
- Unicidade bidirecional: cada registro de qualquer lado tem exatamente uma correspondência
- Participação opcional: registros podem existir sem um relacionamento
- Integridade referencial: constraints de chave estrangeira mantêm a consistência dos dados
- Separação lógica: os dados são divididos por motivos de organização ou desempenho
Exemplo conceitual
Pense em uma pessoa e seu passaporte:
- Cada pessoa pode ter apenas um passaporte válido
- Cada passaporte pertence a exatamente uma pessoa
- Uma pessoa pode não ter passaporte (opcional)
- Um passaporte não pode existir sem uma pessoa
Esse relacionamento 1:1 natural o torna um candidato ideal para modelagem de banco de dados com tabelas separadas.
Quando usar relacionamentos um-para-um
1. Otimização de desempenho
Divida tabelas grandes com muitas colunas para melhorar o desempenho das consultas:
-- Frequently queried user data
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    status VARCHAR(20) DEFAULT 'active'
);

-- Rarely accessed profile data
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    bio TEXT,
    preferences JSON,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Benefícios: consultas mais rápidas na tabela principal, menor uso de memória, índices mais eficientes.
2. Isolamento de dados
Separe informações sensíveis ou opcionais:
-- Public employee information
CREATE TABLE employees (
    id SERIAL PRIMARY KEY,
    employee_number VARCHAR(20) UNIQUE,
    first_name VARCHAR(50),
    department_id INTEGER
);

-- Restricted HR data
CREATE TABLE employee_hr_details (
    employee_id INTEGER UNIQUE NOT NULL,
    salary DECIMAL(10,2),
    social_security_number VARCHAR(11),
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);
3. Recursos modulares
Ative/desative recursos por meio de tabelas separadas:
-- Base account functionality
CREATE TABLE accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE,
    email VARCHAR(100) UNIQUE
);

-- Premium features (optional)
CREATE TABLE premium_features (
    account_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 100,
    advanced_analytics BOOLEAN DEFAULT true,
    FOREIGN KEY (account_id) REFERENCES accounts(id)
);
Métodos de implementação
Método 1: chave estrangeira na tabela dependente (recomendado)
Coloque a chave estrangeira na tabela de “extensão” com uma constraint UNIQUE:
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL
);

CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Query with relationship
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
Pontos principais:
- A constraint UNIQUE garante o relacionamento 1:1
- O LEFT JOIN inclui usuários sem perfil
- Abordagem mais flexível para mudanças futuras
Método 2: chave primária compartilhada
Ambas as tabelas usam o mesmo valor de chave primária:
CREATE TABLE user_profiles (
    user_id INTEGER PRIMARY KEY,  -- Same as users.id
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Vantagens: desempenho um pouco melhor, relacionamento conceitual mais claro.
Desvantagens: menos flexível se as regras do relacionamento mudarem depois.
Escolhendo o método certo
O Método 1 é recomendado na maioria dos cenários porque oferece o melhor equilíbrio entre:
- Desempenho - consultas eficientes com indexação adequada
- Flexibilidade - fácil de modificar as regras do relacionamento
- Clareza - dependência clara entre as tabelas
O Método 2 funciona bem quando o relacionamento é realmente parte integral do modelo de negócio e dificilmente vai mudar.
Exemplos reais
Exemplo 1: sistema de autenticação de usuários
Separe os dados de autenticação das informações de perfil:
-- Core authentication (frequently accessed)
CREATE TABLE user_accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    password_hash VARCHAR(255) NOT NULL,
    last_login TIMESTAMP
);

-- Extended profile (occasionally accessed)
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    display_name VARCHAR(100),
    bio TEXT,
    avatar_url VARCHAR(255),
    privacy_settings JSON,
    FOREIGN KEY (user_id) REFERENCES user_accounts(id)
);
Benefícios:
- Consultas de login rápidas - a tabela de autenticação continua pequena e rápida
- Menor uso de memória - dados de perfil carregados só quando necessário
- Separação clara - autenticação vs. apresentação
Exemplo 2: gestão de produtos em e-commerce
Separe o catálogo público do estoque interno:
-- Public product catalog
CREATE TABLE products (
    id SERIAL PRIMARY KEY,
    sku VARCHAR(50) UNIQUE NOT NULL,
    name VARCHAR(200) NOT NULL,
    price DECIMAL(10,2) NOT NULL,
    is_active BOOLEAN DEFAULT true
);

-- Internal inventory management
CREATE TABLE product_inventory (
    product_id INTEGER UNIQUE NOT NULL,
    stock_quantity INTEGER DEFAULT 0,
    warehouse_location VARCHAR(100),
    cost_price DECIMAL(10,2),
    reorder_level INTEGER,
    FOREIGN KEY (product_id) REFERENCES products(id)
);
Casos de uso:
- API pública - serve o catálogo de produtos sem expor o estoque
- Sistemas internos - acessam dados de produto e de estoque
- Segurança - restringe o acesso a informações de custo/estoque
Exemplo 3: fluxo de gestão de conteúdo
Separe o conteúdo publicado do fluxo editorial:
-- Published articles (public)
CREATE TABLE articles (
    id SERIAL PRIMARY KEY,
    slug VARCHAR(255) UNIQUE NOT NULL,
    title VARCHAR(255) NOT NULL,
    content TEXT NOT NULL,
    published_at TIMESTAMP NOT NULL
);

-- Editorial workflow (internal)
CREATE TABLE article_drafts (
    article_id INTEGER UNIQUE,  -- NULL for unpublished drafts
    title VARCHAR(255),
    content TEXT,
    status VARCHAR(20) DEFAULT 'draft',
    editor_notes TEXT,
    FOREIGN KEY (article_id) REFERENCES articles(id)
);
Benefícios para o fluxo:
- Interface pública limpa - apenas conteúdo publicado fica visível
- Processo editorial flexível - rascunhos podem existir sem versões publicadas
- Desempenho - consultas públicas não varrem dados editoriais
Considerações de desempenho
Indexação essencial
Sempre indexe as colunas de chave estrangeira em relacionamentos um-para-um:
-- Basic foreign key indexes
CREATE INDEX idx_user_profiles_user_id ON user_profiles(user_id);
CREATE INDEX idx_product_inventory_product_id ON product_inventory(product_id);

-- Partial indexes for conditional relationships
CREATE INDEX idx_active_premium_features ON premium_features(account_id)
WHERE expires_at > CURRENT_TIMESTAMP;
Boas práticas de consulta
Selecione apenas as colunas necessárias: evite SELECT * ao fazer join de tabelas.
Use os tipos de JOIN adequados: LEFT JOIN quando o relacionamento for opcional, INNER JOIN quando for obrigatório.
EXISTS vs JOIN: use EXISTS para verificar se o relacionamento existe sem recuperar dados.
-- Efficient existence check
SELECT u.username
FROM users u
WHERE EXISTS (
    SELECT 1 FROM user_profiles p
    WHERE p.user_id = u.id
);
Otimização de armazenamento
Escolha tipos de dados adequados: use tipos específicos (DATE, BOOLEAN) em vez de campos de texto genéricos.
Considere o tamanho dos campos: limite os tamanhos de VARCHAR conforme as necessidades reais.
JSON para dados complexos: armazene dados complexos e pouco acessados como JSON em vez de várias colunas.
Armadilhas comuns e soluções
Armadilha 1: falta da constraint UNIQUE
Problema: esquecer a constraint UNIQUE permite vários registros relacionados (criando um 1:N em vez de 1:1).
Solução: sempre inclua UNIQUE na chave estrangeira:
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Armadilha 2: tipo de JOIN errado
Problema: usar INNER JOIN exclui registros sem relacionamento.
Solução: use os tipos de JOIN adequados:
-- Include all users (even without profiles)
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
Armadilha 3: regras de cascata incorretas
Problema: um comportamento de cascata errado impede operações legítimas.
Solução: escolha as regras de cascata com base na lógica de negócio:
- CASCADE: exclui o registro relacionado quando o pai é excluído
- SET NULL: mantém o registro relacionado e remove a referência
- RESTRICT: impede a exclusão se houver um registro relacionado
Armadilha 4: normalização excessiva
Problema: criar divisões 1:1 desnecessárias para dados intimamente relacionados.
Solução: só divida tabelas quando houver benefícios claros:
- Ganho de desempenho com a divisão da tabela
- Requisitos de segurança para isolamento de dados
- Padrões de acesso diferentes entre os conjuntos de dados
-- Good: Keep frequently accessed data together
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50),
    email VARCHAR(100),
    first_name VARCHAR(50),  -- Keep basic info together
    last_name VARCHAR(50)
);

-- Good: Split large or sensitive data
CREATE TABLE user_extended_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    detailed_bio TEXT,        -- Large field
    salary_expectations DECIMAL -- Sensitive data
);
Padrões avançados
Relacionamentos um-para-um condicionais
Às vezes, os relacionamentos só se aplicam sob certas condições:
-- Premium settings only for premium users
CREATE TABLE premium_settings (
    user_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 50,
    advanced_features BOOLEAN DEFAULT true,
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Enforce business rule
CREATE UNIQUE INDEX idx_premium_settings
ON premium_settings(user_id)
WHERE EXISTS (
    SELECT 1 FROM users
    WHERE users.id = premium_settings.user_id
    AND account_type = 'premium'
);
Casos de uso: feature flags, níveis de assinatura, dados baseados em papéis.
Relacionamentos um-para-um polimórficos
Quando uma tabela se relaciona com vários tipos de entidade diferentes:
-- Generic address system
CREATE TABLE addresses (
    addressable_type VARCHAR(50) NOT NULL,  -- 'customer', 'supplier'
    addressable_id INTEGER NOT NULL,
    street_address VARCHAR(255),
    city VARCHAR(100),
    UNIQUE(addressable_type, addressable_id)
);
Benefícios: um único sistema de endereços funciona para vários tipos de entidade, com gestão de endereços consistente.
Relacionamentos um-para-um temporais
Acompanhe como os relacionamentos mudam ao longo do tempo:
-- Employee position history
CREATE TABLE employee_positions (
    employee_id INTEGER NOT NULL,
    title VARCHAR(100),
    effective_date DATE NOT NULL,
    end_date DATE,  -- NULL for current
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);

-- Only one current position per employee
CREATE UNIQUE INDEX idx_current_position
ON employee_positions(employee_id)
WHERE end_date IS NULL;
Aplicações: mudanças de cargo, histórico de assinaturas, transições de status.
Integração com o código da aplicação
Suporte em ORMs
A maioria dos ORMs modernos oferece suporte nativo a relacionamentos um-para-um:
Exemplo em Django:
class User(models.Model):
    username = models.CharField(max_length=50, unique=True)
    email = models.EmailField(unique=True)

class UserProfile(models.Model):
    user = models.OneToOneField(User, on_delete=models.CASCADE)
    bio = models.TextField(blank=True)
Exemplo em Rails:
class User < ApplicationRecord
  has_one :user_profile, dependent: :destroy
end

class UserProfile < ApplicationRecord
  belongs_to :user
end
Padrões de design de API
Considere estas abordagens para expor relacionamentos 1:1 em APIs:
Dados embutidos: inclua os dados relacionados diretamente na resposta, por conveniência.
Endpoints separados: ofereça endpoints dedicados para os dados relacionados, reduzindo o tamanho do payload.
Expansão opcional: permita que os clientes solicitem dados relacionados via parâmetros de query (?expand=profile).
Escolha com base em:
- Tamanho dos dados e frequência de acesso
- Requisitos de desempenho
- Necessidade de flexibilidade dos clientes
Conclusão
Relacionamentos um-para-um são uma ferramenta poderosa para organizar dados de forma eficiente e segura. Embora menos comuns que outros tipos de relacionamento, eles trazem benefícios cruciais para otimização de desempenho, segurança por meio do isolamento de dados e separação clara de responsabilidades.
Principais lições:
- Sempre use constraints UNIQUE nas chaves estrangeiras para garantir o relacionamento 1:1
- Escolha regras de cascata adequadas com base na sua lógica de negócio
- Indexe as colunas de chave estrangeira para um desempenho ideal nas consultas
- Use LEFT JOINs nas consultas para incluir registros sem relacionamento
- Não normalize demais - só divida tabelas quando houver benefício claro
- Considere os padrões de acesso ao decidir se vai dividir tabelas
Quando usar relacionamentos 1:1:
- Tabelas grandes que precisam de otimização de desempenho
- Dados sensíveis que exigem controle de acesso
- Dados opcionais raramente acessados
- Recursos modulares que podem ser ativados/desativados
Leitura relacionada:
- Entendendo relacionamentos em bancos de dados: um guia completo para iniciantes
- Relacionamentos um-para-muitos em bancos de dados: guia completo
- Relacionamentos muitos-para-muitos em bancos de dados: guia completo
- SQL JOINs para iniciantes com diagramas
Pratique a implementação desses padrões com o Beekeeper Studio, onde você pode visualizar os relacionamentos das suas tabelas e testar suas consultas com dados reais.
 Beekeeper Studio é um cliente de banco de dados gratuito e open source
A melhor ferramenta de consultas e edição de SQL que já usei. Tem tudo o que preciso para gerenciar meu banco de dados. - ⭐⭐⭐⭐⭐ Mit
O Beekeeper Studio é rápido, intuitivo e fácil de usar. Ele suporta vários bancos de dados e funciona muito bem no Windows, Mac e Linux.
O que os usuários dizem sobre o Beekeeper Studio
"O Beekeeper Studio substituiu completamente meu antigo fluxo de trabalho com SQL. É rápido, intuitivo e torna o trabalho com bancos de dados agradável de novo."
"Já testei muitas GUIs de banco de dados, mas o Beekeeper encontra o equilíbrio perfeito entre recursos e simplicidade. Simplesmente funciona."