
データベースの1対1リレーションシップは、誤解されやすく、十分に活用されていないことがよくあります。最も使われることの少ないリレーションシップの種類ですが、いつどのように正しく実装すべきかを理解すれば、データベース設計、パフォーマンス、保守性を大きく向上させることができます。
この包括的なガイドでは、基本的な概念から高度な実装パターンまで、1対1リレーションシップについて知っておくべきことを、実際の例と実践的な SQL コードとともに解説します。
1対1リレーションシップとは?
1対1(1:1)リレーションシップは、テーブル A の各レコードがテーブル B のちょうど1つのレコードに対応し、その逆も成り立つ場合に存在します。これにより、双方向に機能する対称的な関係が生まれます。
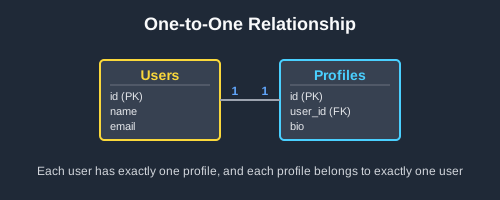
主な特徴
- 双方向の一意性:どちら側のレコードにも、対応するレコードがちょうど1つ存在します
- 任意の参加:リレーションシップを持たないレコードも存在できます
- 参照整合性:外部キー制約によってデータの一貫性が保たれます
- 論理的な分離:整理やパフォーマンス上の理由でデータを分割します
概念的な例
人とパスポートの関係を考えてみましょう:
- 1人が持てる有効なパスポートは1つだけです
- 各パスポートはちょうど1人に属します
- パスポートを持たない人もいます(任意)
- パスポートは人なしでは存在できません
この自然な1:1の関係は、別々のテーブルを使ったデータベースモデリングに最適な題材です。
1対1リレーションシップを使うべき場面
1. パフォーマンスの最適化
列の多い大きなテーブルを分割して、クエリのパフォーマンスを向上させます:
-- Frequently queried user data
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    status VARCHAR(20) DEFAULT 'active'
);

-- Rarely accessed profile data
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    bio TEXT,
    preferences JSON,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
メリット:メインテーブルへのクエリの高速化、メモリ使用量の削減、インデックス効率の向上。
2. データの分離
機密情報や任意の情報を分離します:
-- Public employee information
CREATE TABLE employees (
    id SERIAL PRIMARY KEY,
    employee_number VARCHAR(20) UNIQUE,
    first_name VARCHAR(50),
    department_id INTEGER
);

-- Restricted HR data
CREATE TABLE employee_hr_details (
    employee_id INTEGER UNIQUE NOT NULL,
    salary DECIMAL(10,2),
    social_security_number VARCHAR(11),
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);
3. モジュール型の機能
別テーブルを使って機能の有効化・無効化を行います:
-- Base account functionality
CREATE TABLE accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE,
    email VARCHAR(100) UNIQUE
);

-- Premium features (optional)
CREATE TABLE premium_features (
    account_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 100,
    advanced_analytics BOOLEAN DEFAULT true,
    FOREIGN KEY (account_id) REFERENCES accounts(id)
);
実装方法
方法1:従属テーブルに外部キーを置く(推奨)
「拡張」側のテーブルに、一意制約付きの外部キーを置きます:
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL
);

CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Query with relationship
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
ポイント:
- UNIQUE 制約で1:1の関係を強制します
- LEFT JOIN でプロフィールのないユーザーも含めます
- 将来の変更に最も柔軟に対応できる方法です
方法2:主キーの共有
両方のテーブルで同じ主キーの値を使います:
CREATE TABLE user_profiles (
    user_id INTEGER PRIMARY KEY,  -- Same as users.id
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);
メリット:パフォーマンスがわずかに良く、概念的な関係がより明確です。
デメリット:後でリレーションシップのルールが変わった場合の柔軟性が低くなります。
適切な方法の選び方
ほとんどのケースでは方法1をおすすめします。次の要素のバランスが最も優れているためです:
- パフォーマンス - 適切なインデックスによる効率的なクエリ
- 柔軟性 - リレーションシップのルールを変更しやすい
- 明確さ - テーブル間の依存関係がわかりやすい
方法2は、リレーションシップがビジネスモデルに本質的に組み込まれていて、変更される可能性が低い場合に適しています。
実際の例
例1:ユーザー認証システム
認証データをプロフィール情報から分離します:
-- Core authentication (frequently accessed)
CREATE TABLE user_accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    password_hash VARCHAR(255) NOT NULL,
    last_login TIMESTAMP
);

-- Extended profile (occasionally accessed)
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    display_name VARCHAR(100),
    bio TEXT,
    avatar_url VARCHAR(255),
    privacy_settings JSON,
    FOREIGN KEY (user_id) REFERENCES user_accounts(id)
);
メリット:
- 高速なログインクエリ - 認証テーブルが小さく高速なまま保たれます
- メモリ使用量の削減 - プロフィールデータは必要なときだけ読み込まれます
- 明確な分離 - 認証と表示の関心事を分けられます
例2:EC サイトの商品管理
公開カタログと社内在庫を分離します:
-- Public product catalog
CREATE TABLE products (
    id SERIAL PRIMARY KEY,
    sku VARCHAR(50) UNIQUE NOT NULL,
    name VARCHAR(200) NOT NULL,
    price DECIMAL(10,2) NOT NULL,
    is_active BOOLEAN DEFAULT true
);

-- Internal inventory management
CREATE TABLE product_inventory (
    product_id INTEGER UNIQUE NOT NULL,
    stock_quantity INTEGER DEFAULT 0,
    warehouse_location VARCHAR(100),
    cost_price DECIMAL(10,2),
    reorder_level INTEGER,
    FOREIGN KEY (product_id) REFERENCES products(id)
);
ユースケース:
- 公開 API - 在庫を公開せずに商品カタログを提供します
- 社内システム - 商品データと在庫データの両方にアクセスします
- セキュリティ - 原価や在庫情報へのアクセスを制限します
例3:コンテンツ管理ワークフロー
公開済みコンテンツと編集ワークフローを分離します:
-- Published articles (public)
CREATE TABLE articles (
    id SERIAL PRIMARY KEY,
    slug VARCHAR(255) UNIQUE NOT NULL,
    title VARCHAR(255) NOT NULL,
    content TEXT NOT NULL,
    published_at TIMESTAMP NOT NULL
);

-- Editorial workflow (internal)
CREATE TABLE article_drafts (
    article_id INTEGER UNIQUE,  -- NULL for unpublished drafts
    title VARCHAR(255),
    content TEXT,
    status VARCHAR(20) DEFAULT 'draft',
    editor_notes TEXT,
    FOREIGN KEY (article_id) REFERENCES articles(id)
);
ワークフロー上のメリット:
- すっきりした公開インターフェース - 公開済みのコンテンツのみが表示されます
- 柔軟な編集プロセス - 公開版がなくても下書きを作成できます
- パフォーマンス - 公開側のクエリが編集データをスキャンしません
パフォーマンスに関する考慮事項
必須のインデックス
1対1リレーションシップでは、外部キー列に必ずインデックスを作成しましょう:
-- Basic foreign key indexes
CREATE INDEX idx_user_profiles_user_id ON user_profiles(user_id);
CREATE INDEX idx_product_inventory_product_id ON product_inventory(product_id);

-- Partial indexes for conditional relationships
CREATE INDEX idx_active_premium_features ON premium_features(account_id)
WHERE expires_at > CURRENT_TIMESTAMP;
クエリのベストプラクティス
必要な列だけを選択する:テーブルを結合するときは SELECT * を避けましょう。
適切な JOIN の種類を使う:リレーションシップが任意なら LEFT JOIN、必須なら INNER JOIN を使います。
EXISTS と JOIN:データを取得せずにリレーションシップの有無だけを確認する場合は EXISTS を使います。
-- Efficient existence check
SELECT u.username
FROM users u
WHERE EXISTS (
    SELECT 1 FROM user_profiles p
    WHERE p.user_id = u.id
);
ストレージの最適化
適切なデータ型を選ぶ:汎用的なテキスト型ではなく、具体的な型(DATE、BOOLEAN)を使いましょう。
フィールド長を考慮する:実際の要件に基づいて VARCHAR のサイズを制限しましょう。
複雑なデータには JSON:アクセス頻度が低く複雑なデータは、複数の列ではなく JSON として保存しましょう。
よくある落とし穴と解決策
落とし穴1:UNIQUE 制約の付け忘れ
問題:UNIQUE 制約を付け忘れると、関連レコードが複数作成できてしまいます(1:1ではなく1:多になります)。
解決策:外部キーには必ず UNIQUE を付けましょう:
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
落とし穴2:誤った JOIN の種類
問題:INNER JOIN を使うと、リレーションシップのないレコードが除外されます。
解決策:適切な JOIN の種類を使いましょう:
-- Include all users (even without profiles)
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
落とし穴3:不適切なカスケードルール
問題:誤ったカスケード動作により、正当な操作ができなくなります。
解決策:ビジネスロジックに基づいてカスケードルールを選びましょう:
- CASCADE:親が削除されたら関連レコードも削除します
- SET NULL:関連レコードは残し、参照を削除します
- RESTRICT:関連レコードが存在する場合は削除を禁止します
落とし穴4:過度な正規化
問題:密接に関連するデータを不必要に1:1で分割してしまいます。
解決策:明確なメリットがある場合にのみテーブルを分割しましょう:
- テーブル分割によるパフォーマンス向上
- データ分離に関するセキュリティ要件
- データセット間でアクセスパターンが異なる場合
-- Good: Keep frequently accessed data together
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50),
    email VARCHAR(100),
    first_name VARCHAR(50),  -- Keep basic info together
    last_name VARCHAR(50)
);

-- Good: Split large or sensitive data
CREATE TABLE user_extended_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    detailed_bio TEXT,        -- Large field
    salary_expectations DECIMAL -- Sensitive data
);
高度なパターン
条件付きの1対1リレーションシップ
特定の条件下でのみリレーションシップが適用される場合があります:
-- Premium settings only for premium users
CREATE TABLE premium_settings (
    user_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 50,
    advanced_features BOOLEAN DEFAULT true,
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Enforce business rule
CREATE UNIQUE INDEX idx_premium_settings
ON premium_settings(user_id)
WHERE EXISTS (
    SELECT 1 FROM users
    WHERE users.id = premium_settings.user_id
    AND account_type = 'premium'
);
ユースケース:フィーチャーフラグ、サブスクリプションのプラン、ロールベースのデータ。
ポリモーフィックな1対1リレーションシップ
1つのテーブルが複数の異なるエンティティ型に関連する場合:
-- Generic address system
CREATE TABLE addresses (
    addressable_type VARCHAR(50) NOT NULL,  -- 'customer', 'supplier'
    addressable_id INTEGER NOT NULL,
    street_address VARCHAR(255),
    city VARCHAR(100),
    UNIQUE(addressable_type, addressable_id)
);
メリット:1つの住所システムを複数のエンティティ型で使え、住所を一貫して管理できます。
時系列の1対1リレーションシップ
リレーションシップの経時的な変化を追跡します:
-- Employee position history
CREATE TABLE employee_positions (
    employee_id INTEGER NOT NULL,
    title VARCHAR(100),
    effective_date DATE NOT NULL,
    end_date DATE,  -- NULL for current
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);

-- Only one current position per employee
CREATE UNIQUE INDEX idx_current_position
ON employee_positions(employee_id)
WHERE end_date IS NULL;
用途:役職の変更、サブスクリプション履歴、ステータスの遷移。
アプリケーションコードとの統合
ORM のサポート
最近のほとんどの ORM は、1対1リレーションシップを標準でサポートしています:
Django の例:
class User(models.Model):
    username = models.CharField(max_length=50, unique=True)
    email = models.EmailField(unique=True)

class UserProfile(models.Model):
    user = models.OneToOneField(User, on_delete=models.CASCADE)
    bio = models.TextField(blank=True)
Rails の例:
class User < ApplicationRecord
  has_one :user_profile, dependent: :destroy
end

class UserProfile < ApplicationRecord
  belongs_to :user
end
API 設計パターン
API で1:1リレーションシップを公開する際は、次の方法を検討しましょう:
埋め込みデータ:利便性のため、関連データをレスポンスに直接含めます。
個別のエンドポイント:ペイロードサイズを抑えるため、関連データ専用のエンドポイントを用意します。
任意の展開:クライアントがクエリパラメータ(?expand=profile)で関連データを要求できるようにします。
選択の基準:
- データサイズとアクセス頻度
- パフォーマンス要件
- クライアントに必要な柔軟性
まとめ
データベースの1対1リレーションシップは、データを効率的かつ安全に整理するための強力なツールです。他のリレーションシップの種類ほど一般的ではありませんが、パフォーマンスの最適化、データ分離によるセキュリティ、関心事の明確な分離といった重要なメリットをもたらします。
重要なポイント:
- 1:1の関係を強制するため、外部キーには必ず UNIQUE 制約を使う
- ビジネスロジックに基づいて適切なカスケードルールを選ぶ
- クエリのパフォーマンスを最適化するため外部キー列にインデックスを作成する
- リレーションシップのないレコードも含めるため、クエリではLEFT JOIN を使う
- 過度に正規化しない - 明確なメリットがある場合にのみテーブルを分割する
- テーブルを分割するかどうかはアクセスパターンを考慮して判断する
1:1リレーションシップを使うべき場面:
- パフォーマンスの最適化が必要な大きなテーブル
- アクセス制御が必要な機密データ
- めったにアクセスされない任意のデータ
- 有効化・無効化できるモジュール型の機能
関連記事:
- データベースのリレーションシップを理解する:初心者向け総合ガイド
- データベースの1対多リレーションシップ:完全ガイド
- データベースの多対多リレーションシップ:完全ガイド
- 初心者向け 図解 SQL JOIN
Beekeeper Studio でこれらのパターンの実装を練習しましょう。テーブルのリレーションシップを可視化し、実データでクエリをテストできます。
 Beekeeper Studioは無料のオープンソースのデータベースGUIです
これまで使った中で最高のSQLクエリ&エディタツールです。データベースの管理に必要なものがすべて揃っています。 - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studioは高速で直感的、そして使いやすいツールです。多数のデータベースに対応し、Windows、Mac、Linuxで快適に動作します。
Beekeeper Studio 利用者の声
「Beekeeper Studio は、これまでの SQL ワークフローを完全に置き換えてくれました。高速で直感的で、データベース作業がまた楽しくなりました。」
「多くのデータベース GUI を試してきましたが、Beekeeper は機能とシンプルさのバランスが完璧です。とにかくちゃんと動きます。」