
Les relations un-à-un en base de données sont souvent mal comprises et sous-utilisées. Même si c’est le type de relation le moins courant, savoir quand et comment les mettre en place correctement peut nettement améliorer la conception, les performances et la maintenabilité de ta base de données.
Ce guide complet couvre tout ce que tu dois savoir sur les relations un-à-un, des concepts de base aux modèles d’implémentation avancés, avec des exemples concrets et du code SQL pratique.
Qu’est-ce qu’une relation un-à-un ?
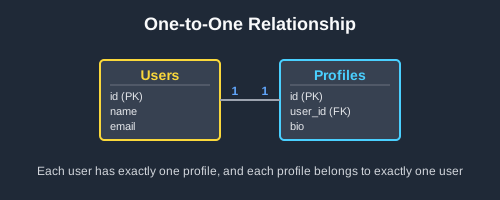
Une relation un-à-un (1:1) existe quand chaque enregistrement de la table A correspond à exactement un enregistrement de la table B, et inversement. Cela crée un lien symétrique où la relation fonctionne dans les deux sens.
Caractéristiques clés
- Unicité bidirectionnelle : chaque enregistrement, d’un côté comme de l’autre, a exactement une correspondance
- Participation facultative : des enregistrements peuvent exister sans relation
- Intégrité référentielle : les contraintes de clé étrangère garantissent la cohérence des données
- Séparation logique : les données sont réparties pour des raisons d’organisation ou de performance
Exemple conceptuel
Pense à une personne et à son passeport :
- Chaque personne ne peut avoir qu’un seul passeport valide
- Chaque passeport appartient à exactement une personne
- Une personne peut ne pas avoir de passeport (facultatif)
- Un passeport ne peut pas exister sans personne
Cette relation 1:1 naturelle en fait un candidat idéal pour une modélisation en tables séparées.
Quand utiliser les relations un-à-un
1. Optimisation des performances
Découpe les grandes tables comportant beaucoup de colonnes pour améliorer les performances des requêtes :
-- Frequently queried user data
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    status VARCHAR(20) DEFAULT 'active'
);

-- Rarely accessed profile data
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    bio TEXT,
    preferences JSON,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Avantages : requêtes plus rapides sur la table principale, moins de mémoire utilisée, index plus efficaces.
2. Isolation des données
Sépare les informations sensibles ou facultatives :
-- Public employee information
CREATE TABLE employees (
    id SERIAL PRIMARY KEY,
    employee_number VARCHAR(20) UNIQUE,
    first_name VARCHAR(50),
    department_id INTEGER
);

-- Restricted HR data
CREATE TABLE employee_hr_details (
    employee_id INTEGER UNIQUE NOT NULL,
    salary DECIMAL(10,2),
    social_security_number VARCHAR(11),
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);
3. Fonctionnalités modulaires
Active ou désactive des fonctionnalités grâce à des tables séparées :
-- Base account functionality
CREATE TABLE accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE,
    email VARCHAR(100) UNIQUE
);

-- Premium features (optional)
CREATE TABLE premium_features (
    account_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 100,
    advanced_analytics BOOLEAN DEFAULT true,
    FOREIGN KEY (account_id) REFERENCES accounts(id)
);
Méthodes d’implémentation
Méthode 1 : clé étrangère dans la table dépendante (recommandée)
Place la clé étrangère dans la table « d’extension » avec une contrainte d’unicité :
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL
);

CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Query with relationship
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
Points clés :
- La contrainte UNIQUE impose la relation 1:1
- Le LEFT JOIN inclut les utilisateurs sans profil
- L’approche la plus flexible pour les évolutions futures
Méthode 2 : clé primaire partagée
Les deux tables utilisent la même valeur de clé primaire :
CREATE TABLE user_profiles (
    user_id INTEGER PRIMARY KEY,  -- Same as users.id
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Avantages : performances légèrement meilleures, relation conceptuelle plus claire.
Inconvénients : moins flexible si les règles de la relation changent plus tard.
Choisir la bonne méthode
La méthode 1 est recommandée dans la plupart des cas, car elle offre le meilleur équilibre entre :
- Performance - requêtes efficaces avec une indexation adaptée
- Flexibilité - règles de relation faciles à modifier
- Clarté - dépendance claire entre les tables
La méthode 2 convient bien quand la relation fait vraiment partie intégrante du modèle métier et a peu de chances de changer.
Exemples concrets
Exemple 1 : système d’authentification des utilisateurs
Sépare les données d’authentification des informations de profil :
-- Core authentication (frequently accessed)
CREATE TABLE user_accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    password_hash VARCHAR(255) NOT NULL,
    last_login TIMESTAMP
);

-- Extended profile (occasionally accessed)
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    display_name VARCHAR(100),
    bio TEXT,
    avatar_url VARCHAR(255),
    privacy_settings JSON,
    FOREIGN KEY (user_id) REFERENCES user_accounts(id)
);
Avantages :
- Connexions rapides - la table d’authentification reste petite et rapide
- Moins de mémoire utilisée - les données de profil ne sont chargées qu’en cas de besoin
- Séparation claire - authentification d’un côté, présentation de l’autre
Exemple 2 : gestion des produits en e-commerce
Sépare le catalogue public de l’inventaire interne :
-- Public product catalog
CREATE TABLE products (
    id SERIAL PRIMARY KEY,
    sku VARCHAR(50) UNIQUE NOT NULL,
    name VARCHAR(200) NOT NULL,
    price DECIMAL(10,2) NOT NULL,
    is_active BOOLEAN DEFAULT true
);

-- Internal inventory management
CREATE TABLE product_inventory (
    product_id INTEGER UNIQUE NOT NULL,
    stock_quantity INTEGER DEFAULT 0,
    warehouse_location VARCHAR(100),
    cost_price DECIMAL(10,2),
    reorder_level INTEGER,
    FOREIGN KEY (product_id) REFERENCES products(id)
);
Cas d’usage :
- API publique - sert le catalogue produits sans exposer l’inventaire
- Systèmes internes - accèdent aux données produits et inventaire
- Sécurité - restreint l’accès aux informations de coût et d’inventaire
Exemple 3 : workflow de gestion de contenu
Sépare le contenu publié du workflow éditorial :
-- Published articles (public)
CREATE TABLE articles (
    id SERIAL PRIMARY KEY,
    slug VARCHAR(255) UNIQUE NOT NULL,
    title VARCHAR(255) NOT NULL,
    content TEXT NOT NULL,
    published_at TIMESTAMP NOT NULL
);

-- Editorial workflow (internal)
CREATE TABLE article_drafts (
    article_id INTEGER UNIQUE,  -- NULL for unpublished drafts
    title VARCHAR(255),
    content TEXT,
    status VARCHAR(20) DEFAULT 'draft',
    editor_notes TEXT,
    FOREIGN KEY (article_id) REFERENCES articles(id)
);
Avantages pour le workflow :
- Interface publique propre - seul le contenu publié est visible
- Processus éditorial flexible - des brouillons peuvent exister sans version publiée
- Performance - les requêtes publiques ne parcourent pas les données éditoriales
Considérations de performance
Indexation indispensable
Indexe toujours les colonnes de clé étrangère dans les relations un-à-un :
-- Basic foreign key indexes
CREATE INDEX idx_user_profiles_user_id ON user_profiles(user_id);
CREATE INDEX idx_product_inventory_product_id ON product_inventory(product_id);

-- Partial indexes for conditional relationships
CREATE INDEX idx_active_premium_features ON premium_features(account_id)
WHERE expires_at > CURRENT_TIMESTAMP;
Bonnes pratiques pour les requêtes
Sélectionne uniquement les colonnes nécessaires : évite SELECT * quand tu joins des tables.
Utilise les bons types de JOIN : LEFT JOIN quand la relation est facultative, INNER JOIN quand elle est obligatoire.
EXISTS ou JOIN : utilise EXISTS pour vérifier l’existence d’une relation sans récupérer les données.
-- Efficient existence check
SELECT u.username
FROM users u
WHERE EXISTS (
    SELECT 1 FROM user_profiles p
    WHERE p.user_id = u.id
);
Optimisation du stockage
Choisis des types de données adaptés : utilise des types précis (DATE, BOOLEAN) plutôt que des champs texte génériques.
Pense à la longueur des champs : limite la taille des VARCHAR selon les besoins réels.
JSON pour les données complexes : stocke les données complexes et rarement utilisées en JSON plutôt que dans plusieurs colonnes.
Pièges courants et solutions
Piège 1 : contrainte UNIQUE manquante
Problème : oublier la contrainte UNIQUE autorise plusieurs enregistrements liés (ce qui crée une relation 1:N au lieu de 1:1).
Solution : ajoute toujours UNIQUE sur la clé étrangère :
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Piège 2 : mauvais type de JOIN
Problème : utiliser INNER JOIN exclut les enregistrements sans relation.
Solution : utilise les types de JOIN adaptés :
-- Include all users (even without profiles)
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
Piège 3 : règles de cascade incorrectes
Problème : un mauvais comportement de cascade bloque des opérations légitimes.
Solution : choisis les règles de cascade selon ta logique métier :
- CASCADE : supprime l’enregistrement lié quand le parent est supprimé
- SET NULL : conserve l’enregistrement lié, supprime la référence
- RESTRICT : empêche la suppression si un enregistrement lié existe
Piège 4 : sur-normalisation
Problème : créer des découpages 1:1 inutiles pour des données étroitement liées.
Solution : ne découpe les tables que si les avantages sont clairs :
- Gain de performance grâce au découpage de la table
- Exigences de sécurité pour isoler les données
- Modes d’accès différents entre les jeux de données
-- Good: Keep frequently accessed data together
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50),
    email VARCHAR(100),
    first_name VARCHAR(50),  -- Keep basic info together
    last_name VARCHAR(50)
);

-- Good: Split large or sensitive data
CREATE TABLE user_extended_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    detailed_bio TEXT,        -- Large field
    salary_expectations DECIMAL -- Sensitive data
);
Modèles avancés
Relations un-à-un conditionnelles
Parfois, les relations ne s’appliquent que sous certaines conditions :
-- Premium settings only for premium users
CREATE TABLE premium_settings (
    user_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 50,
    advanced_features BOOLEAN DEFAULT true,
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Enforce business rule
CREATE UNIQUE INDEX idx_premium_settings
ON premium_settings(user_id)
WHERE EXISTS (
    SELECT 1 FROM users
    WHERE users.id = premium_settings.user_id
    AND account_type = 'premium'
);
Cas d’usage : feature flags, niveaux d’abonnement, données selon les rôles.
Relations un-à-un polymorphes
Quand une table est liée à plusieurs types d’entités différents :
-- Generic address system
CREATE TABLE addresses (
    addressable_type VARCHAR(50) NOT NULL,  -- 'customer', 'supplier'
    addressable_id INTEGER NOT NULL,
    street_address VARCHAR(255),
    city VARCHAR(100),
    UNIQUE(addressable_type, addressable_id)
);
Avantages : un seul système d’adresses pour plusieurs types d’entités, une gestion des adresses cohérente.
Relations un-à-un temporelles
Suis l’évolution des relations dans le temps :
-- Employee position history
CREATE TABLE employee_positions (
    employee_id INTEGER NOT NULL,
    title VARCHAR(100),
    effective_date DATE NOT NULL,
    end_date DATE,  -- NULL for current
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);

-- Only one current position per employee
CREATE UNIQUE INDEX idx_current_position
ON employee_positions(employee_id)
WHERE end_date IS NULL;
Applications : changements de poste, historique d’abonnement, transitions de statut.
Intégration avec le code applicatif
Support des ORM
La plupart des ORM modernes prennent en charge nativement les relations un-à-un :
Exemple Django :
class User(models.Model):
    username = models.CharField(max_length=50, unique=True)
    email = models.EmailField(unique=True)

class UserProfile(models.Model):
    user = models.OneToOneField(User, on_delete=models.CASCADE)
    bio = models.TextField(blank=True)
Exemple Rails :
class User < ApplicationRecord
  has_one :user_profile, dependent: :destroy
end

class UserProfile < ApplicationRecord
  belongs_to :user
end
Modèles de conception d’API
Voici quelques approches pour exposer des relations 1:1 dans tes API :
Données imbriquées : inclus directement les données liées dans la réponse, pour plus de praticité.
Endpoints séparés : fournis des endpoints dédiés aux données liées pour alléger les réponses.
Expansion facultative : permets aux clients de demander les données liées via des paramètres de requête (?expand=profile).
Choisis en fonction de :
- La taille des données et la fréquence d’accès
- Les exigences de performance
- Le besoin de flexibilité des clients
Conclusion
Les relations un-à-un sont un outil puissant pour organiser les données de façon efficace et sécurisée. Moins courantes que les autres types de relations, elles apportent des avantages essentiels pour l’optimisation des performances, la sécurité via l’isolation des données et une séparation claire des responsabilités.
À retenir :
- Utilise toujours des contraintes UNIQUE sur les clés étrangères pour imposer la relation 1:1
- Choisis des règles de cascade adaptées à ta logique métier
- Indexe les colonnes de clé étrangère pour des requêtes performantes
- Utilise des LEFT JOIN dans tes requêtes pour inclure les enregistrements sans relation
- Ne sur-normalise pas - ne découpe les tables que si l’avantage est clair
- Tiens compte des modes d’accès avant de découper des tables
Quand utiliser des relations 1:1 :
- Grandes tables à optimiser
- Données sensibles nécessitant un contrôle d’accès
- Données facultatives rarement consultées
- Fonctionnalités modulaires activables/désactivables
À lire aussi :
- Comprendre les relations en base de données : guide complet pour débutants
- Relations un-à-plusieurs en base de données : guide complet
- Relations plusieurs-à-plusieurs en base de données : guide complet
- Les JOIN SQL pour débutants, avec schémas
Entraîne-toi à mettre en place ces modèles avec Beekeeper Studio, où tu peux visualiser les relations entre tes tables et tester tes requêtes sur de vraies données.
 Beekeeper Studio est une interface de base de données gratuite & open source
Le meilleur outil de requêtes & éditeur SQL que j’aie jamais utilisé. Il m’offre tout ce dont j’ai besoin pour gérer ma base de données. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio est rapide, intuitif et facile à utiliser. Beekeeper prend en charge plein de bases de données et fonctionne parfaitement sous Windows, Mac et Linux.
Ce que les utilisateurs disent de Beekeeper Studio
« Beekeeper Studio a complètement remplacé mon ancien workflow SQL. C’est rapide, intuitif, et ça rend le travail sur les bases de données à nouveau agréable. »
« J’ai essayé beaucoup d’interfaces de base de données, mais Beekeeper trouve l’équilibre parfait entre fonctionnalités et simplicité. Ça marche, tout simplement. »