
One-to-One-Beziehungen in Datenbanken werden oft missverstanden und zu selten genutzt. Sie sind zwar der seltenste Beziehungstyp, aber wenn du weißt, wann und wie du sie richtig umsetzt, kannst du Datenbankdesign, Performance und Wartbarkeit deutlich verbessern.
Dieser umfassende Leitfaden deckt alles ab, was du über One-to-One-Beziehungen wissen musst – von den Grundlagen bis zu fortgeschrittenen Implementierungsmustern, mit Praxisbeispielen und konkretem SQL-Code.
Was sind One-to-One-Beziehungen?
Eine One-to-One-Beziehung (1:1) liegt vor, wenn jeder Datensatz in Tabelle A genau einem Datensatz in Tabelle B zugeordnet ist und umgekehrt. So entsteht eine symmetrische Verbindung, die in beide Richtungen funktioniert.
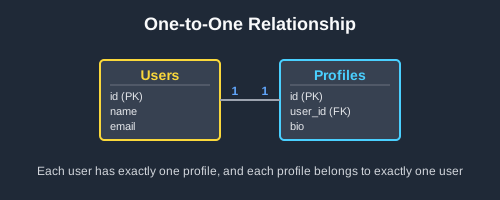
Wichtige Merkmale
- Beidseitige Eindeutigkeit: Jeder Datensatz auf beiden Seiten hat genau eine Entsprechung
- Optionale Teilnahme: Datensätze können auch ohne Beziehung existieren
- Referenzielle Integrität: Foreign-Key-Constraints sorgen für konsistente Daten
- Logische Trennung: Daten werden aus organisatorischen oder Performance-Gründen aufgeteilt
Anschauliches Beispiel
Denk an eine Person und ihren Reisepass:
- Jede Person kann nur einen gültigen Reisepass haben
- Jeder Reisepass gehört genau einer Person
- Eine Person hat eventuell keinen Reisepass (optional)
- Ein Reisepass kann nicht ohne Person existieren
Diese natürliche 1:1-Beziehung eignet sich ideal für die Modellierung mit getrennten Tabellen.
Wann du One-to-One-Beziehungen nutzen solltest
1. Performance-Optimierung
Teile große Tabellen mit vielen Spalten auf, um die Abfrage-Performance zu verbessern:
-- Frequently queried user data
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    status VARCHAR(20) DEFAULT 'active'
);

-- Rarely accessed profile data
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    bio TEXT,
    preferences JSON,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Vorteile: Schnellere Abfragen auf der Haupttabelle, weniger Speicherverbrauch, effizientere Indizes.
2. Datenisolation
Trenne sensible oder optionale Informationen ab:
-- Public employee information
CREATE TABLE employees (
    id SERIAL PRIMARY KEY,
    employee_number VARCHAR(20) UNIQUE,
    first_name VARCHAR(50),
    department_id INTEGER
);

-- Restricted HR data
CREATE TABLE employee_hr_details (
    employee_id INTEGER UNIQUE NOT NULL,
    salary DECIMAL(10,2),
    social_security_number VARCHAR(11),
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);
3. Modulare Features
Aktiviere/deaktiviere Features über separate Tabellen:
-- Base account functionality
CREATE TABLE accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE,
    email VARCHAR(100) UNIQUE
);

-- Premium features (optional)
CREATE TABLE premium_features (
    account_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 100,
    advanced_analytics BOOLEAN DEFAULT true,
    FOREIGN KEY (account_id) REFERENCES accounts(id)
);
Implementierungsmethoden
Methode 1: Foreign Key in der abhängigen Tabelle (empfohlen)
Lege den Foreign Key mit einem Unique-Constraint in die „erweiternde“ Tabelle:
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL
);

CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Query with relationship
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
Wichtige Punkte:
- Der UNIQUE-Constraint erzwingt die 1:1-Beziehung
- LEFT JOIN schließt auch Benutzer ohne Profil ein
- Der flexibelste Ansatz für spätere Änderungen
Methode 2: Gemeinsamer Primärschlüssel
Beide Tabellen verwenden denselben Primärschlüsselwert:
CREATE TABLE user_profiles (
    user_id INTEGER PRIMARY KEY,  -- Same as users.id
    bio TEXT,
    website VARCHAR(255),
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Vorteile: Etwas bessere Performance, klarere konzeptionelle Beziehung.
Nachteile: Weniger flexibel, wenn sich die Beziehungsregeln später ändern.
Die richtige Methode wählen
Methode 1 empfiehlt sich für die meisten Szenarien, weil sie die beste Balance bietet aus:
- Performance – effiziente Abfragen mit passender Indizierung
- Flexibilität – Beziehungsregeln lassen sich leicht ändern
- Klarheit – eindeutige Abhängigkeit zwischen den Tabellen
Methode 2 eignet sich gut, wenn die Beziehung fester Bestandteil des Geschäftsmodells ist und sich wahrscheinlich nicht ändert.
Praxisbeispiele
Beispiel 1: Benutzer-Authentifizierungssystem
Trenne Authentifizierungsdaten von Profilinformationen:
-- Core authentication (frequently accessed)
CREATE TABLE user_accounts (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    password_hash VARCHAR(255) NOT NULL,
    last_login TIMESTAMP
);

-- Extended profile (occasionally accessed)
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    display_name VARCHAR(100),
    bio TEXT,
    avatar_url VARCHAR(255),
    privacy_settings JSON,
    FOREIGN KEY (user_id) REFERENCES user_accounts(id)
);
Vorteile:
- Schnelle Login-Abfragen – die Authentifizierungstabelle bleibt klein und schnell
- Weniger Speicherverbrauch – Profildaten werden nur bei Bedarf geladen
- Klare Trennung – Authentifizierung und Darstellung bleiben getrennt
Beispiel 2: Produktverwaltung im E-Commerce
Trenne den öffentlichen Katalog vom internen Lagerbestand:
-- Public product catalog
CREATE TABLE products (
    id SERIAL PRIMARY KEY,
    sku VARCHAR(50) UNIQUE NOT NULL,
    name VARCHAR(200) NOT NULL,
    price DECIMAL(10,2) NOT NULL,
    is_active BOOLEAN DEFAULT true
);

-- Internal inventory management
CREATE TABLE product_inventory (
    product_id INTEGER UNIQUE NOT NULL,
    stock_quantity INTEGER DEFAULT 0,
    warehouse_location VARCHAR(100),
    cost_price DECIMAL(10,2),
    reorder_level INTEGER,
    FOREIGN KEY (product_id) REFERENCES products(id)
);
Anwendungsfälle:
- Öffentliche API – liefert den Produktkatalog, ohne den Lagerbestand preiszugeben
- Interne Systeme – greifen auf Produkt- und Lagerdaten zu
- Sicherheit – Zugriff auf Kosten- und Lagerinformationen einschränken
Beispiel 3: Content-Management-Workflow
Trenne veröffentlichte Inhalte vom redaktionellen Workflow:
-- Published articles (public)
CREATE TABLE articles (
    id SERIAL PRIMARY KEY,
    slug VARCHAR(255) UNIQUE NOT NULL,
    title VARCHAR(255) NOT NULL,
    content TEXT NOT NULL,
    published_at TIMESTAMP NOT NULL
);

-- Editorial workflow (internal)
CREATE TABLE article_drafts (
    article_id INTEGER UNIQUE,  -- NULL for unpublished drafts
    title VARCHAR(255),
    content TEXT,
    status VARCHAR(20) DEFAULT 'draft',
    editor_notes TEXT,
    FOREIGN KEY (article_id) REFERENCES articles(id)
);
Vorteile für den Workflow:
- Saubere öffentliche Schnittstelle – nur veröffentlichte Inhalte sind sichtbar
- Flexibler Redaktionsprozess – Entwürfe können ohne veröffentlichte Version existieren
- Performance – öffentliche Abfragen durchsuchen keine redaktionellen Daten
Performance-Aspekte
Unverzichtbare Indizierung
Indiziere Foreign-Key-Spalten in One-to-One-Beziehungen immer:
-- Basic foreign key indexes
CREATE INDEX idx_user_profiles_user_id ON user_profiles(user_id);
CREATE INDEX idx_product_inventory_product_id ON product_inventory(product_id);

-- Partial indexes for conditional relationships
CREATE INDEX idx_active_premium_features ON premium_features(account_id)
WHERE expires_at > CURRENT_TIMESTAMP;
Best Practices für Abfragen
Nur benötigte Spalten auswählen: Vermeide SELECT * beim Joinen von Tabellen.
Passende JOIN-Typen verwenden: LEFT JOIN, wenn die Beziehung optional ist, INNER JOIN, wenn sie erforderlich ist.
EXISTS vs. JOIN: Nutze EXISTS, um zu prüfen, ob eine Beziehung existiert, ohne Daten abzurufen.
-- Efficient existence check
SELECT u.username
FROM users u
WHERE EXISTS (
    SELECT 1 FROM user_profiles p
    WHERE p.user_id = u.id
);
Speicheroptimierung
Passende Datentypen wählen: Verwende spezifische Typen (DATE, BOOLEAN) statt generischer Textfelder.
Feldlängen bedenken: Begrenze VARCHAR-Größen auf den tatsächlichen Bedarf.
JSON für komplexe Daten: Speichere selten genutzte, komplexe Daten als JSON statt in vielen Spalten.
Häufige Fallstricke und Lösungen
Fallstrick 1: Fehlender UNIQUE-Constraint
Problem: Ohne UNIQUE-Constraint sind mehrere verknüpfte Datensätze möglich (es entsteht 1:n statt 1:1).
Lösung: Setze immer UNIQUE auf den Foreign Key:
CREATE TABLE user_profiles (
    user_id INTEGER UNIQUE NOT NULL,  -- UNIQUE enforces 1:1
    bio TEXT,
    FOREIGN KEY (user_id) REFERENCES users(id)
);
Fallstrick 2: Falscher JOIN-Typ
Problem: INNER JOIN schließt Datensätze ohne Beziehung aus.
Lösung: Verwende passende JOIN-Typen:
-- Include all users (even without profiles)
SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;
Fallstrick 3: Falsche Cascade-Regeln
Problem: Falsches Cascade-Verhalten verhindert legitime Operationen.
Lösung: Wähle Cascade-Regeln anhand der Geschäftslogik:
- CASCADE: Verknüpften Datensatz löschen, wenn der übergeordnete gelöscht wird
- SET NULL: Verknüpften Datensatz behalten, Referenz entfernen
- RESTRICT: Löschen verhindern, wenn ein verknüpfter Datensatz existiert
Fallstrick 4: Übernormalisierung
Problem: Unnötige 1:1-Aufteilungen für eng zusammengehörige Daten.
Lösung: Teile Tabellen nur auf, wenn es klare Vorteile gibt:
- Performance-Gewinn durch die Aufteilung
- Sicherheitsanforderungen für Datenisolation
- Unterschiedliche Zugriffsmuster der Datenbestände
-- Good: Keep frequently accessed data together
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50),
    email VARCHAR(100),
    first_name VARCHAR(50),  -- Keep basic info together
    last_name VARCHAR(50)
);

-- Good: Split large or sensitive data
CREATE TABLE user_extended_profiles (
    user_id INTEGER UNIQUE NOT NULL,
    detailed_bio TEXT,        -- Large field
    salary_expectations DECIMAL -- Sensitive data
);
Fortgeschrittene Muster
Bedingte One-to-One-Beziehungen
Manchmal gelten Beziehungen nur unter bestimmten Bedingungen:
-- Premium settings only for premium users
CREATE TABLE premium_settings (
    user_id INTEGER UNIQUE NOT NULL,
    max_projects INTEGER DEFAULT 50,
    advanced_features BOOLEAN DEFAULT true,
    FOREIGN KEY (user_id) REFERENCES users(id)
);

-- Enforce business rule
CREATE UNIQUE INDEX idx_premium_settings
ON premium_settings(user_id)
WHERE EXISTS (
    SELECT 1 FROM users
    WHERE users.id = premium_settings.user_id
    AND account_type = 'premium'
);
Anwendungsfälle: Feature-Flags, Abo-Stufen, rollenbasierte Daten.
Polymorphe One-to-One-Beziehungen
Wenn eine Tabelle mit mehreren verschiedenen Entitätstypen verknüpft ist:
-- Generic address system
CREATE TABLE addresses (
    addressable_type VARCHAR(50) NOT NULL,  -- 'customer', 'supplier'
    addressable_id INTEGER NOT NULL,
    street_address VARCHAR(255),
    city VARCHAR(100),
    UNIQUE(addressable_type, addressable_id)
);
Vorteile: Ein einziges Adresssystem für mehrere Entitätstypen, einheitliche Adressverwaltung.
Zeitbezogene One-to-One-Beziehungen
Verfolge, wie sich Beziehungen im Lauf der Zeit ändern:
-- Employee position history
CREATE TABLE employee_positions (
    employee_id INTEGER NOT NULL,
    title VARCHAR(100),
    effective_date DATE NOT NULL,
    end_date DATE,  -- NULL for current
    FOREIGN KEY (employee_id) REFERENCES employees(id)
);

-- Only one current position per employee
CREATE UNIQUE INDEX idx_current_position
ON employee_positions(employee_id)
WHERE end_date IS NULL;
Anwendungen: Positionswechsel, Abo-Historie, Statusübergänge.
Integration in den Anwendungscode
ORM-Unterstützung
Die meisten modernen ORMs unterstützen One-to-One-Beziehungen von Haus aus:
Django-Beispiel:
class User(models.Model):
    username = models.CharField(max_length=50, unique=True)
    email = models.EmailField(unique=True)

class UserProfile(models.Model):
    user = models.OneToOneField(User, on_delete=models.CASCADE)
    bio = models.TextField(blank=True)
Rails-Beispiel:
class User < ApplicationRecord
  has_one :user_profile, dependent: :destroy
end

class UserProfile < ApplicationRecord
  belongs_to :user
end
API-Designmuster
Diese Ansätze bieten sich an, um 1:1-Beziehungen in APIs bereitzustellen:
Eingebettete Daten: Verknüpfte Daten der Einfachheit halber direkt in die Antwort aufnehmen.
Separate Endpunkte: Eigene Endpunkte für verknüpfte Daten anbieten, um die Payload klein zu halten.
Optionale Erweiterung: Clients verknüpfte Daten per Query-Parameter anfordern lassen (?expand=profile).
Entscheide anhand von:
- Datenmenge und Zugriffshäufigkeit
- Performance-Anforderungen
- Flexibilitätsbedarf der Clients
Fazit
One-to-One-Beziehungen sind ein starkes Werkzeug, um Daten effizient und sicher zu organisieren. Sie sind zwar seltener als andere Beziehungstypen, bieten aber entscheidende Vorteile für Performance-Optimierung, Sicherheit durch Datenisolation und eine saubere Trennung der Zuständigkeiten.
Das Wichtigste in Kürze:
- Verwende immer UNIQUE-Constraints auf Foreign Keys, um die 1:1-Beziehung zu erzwingen
- Wähle passende Cascade-Regeln anhand deiner Geschäftslogik
- Indiziere Foreign-Key-Spalten für optimale Abfrage-Performance
- Nutze LEFT JOINs in Abfragen, um Datensätze ohne Beziehung einzuschließen
- Normalisiere nicht zu stark – teile Tabellen nur bei klarem Nutzen auf
- Berücksichtige Zugriffsmuster, wenn du über eine Aufteilung entscheidest
Wann sich 1:1-Beziehungen lohnen:
- Große Tabellen, die Performance-Optimierung brauchen
- Sensible Daten, die Zugriffskontrolle erfordern
- Optionale Daten, auf die selten zugegriffen wird
- Modulare Features, die sich aktivieren/deaktivieren lassen
Weiterführende Artikel:
- Datenbankbeziehungen verstehen: Ein umfassender Leitfaden für Einsteiger
- One-to-Many-Beziehungen in Datenbanken: Der komplette Leitfaden
- Many-to-Many-Beziehungen in Datenbanken: Der komplette Leitfaden
- SQL JOINs für Einsteiger mit Diagrammen
Übe diese Muster mit Beekeeper Studio – dort kannst du deine Tabellenbeziehungen visualisieren und deine Abfragen mit echten Daten testen.
 Beekeeper Studio ist eine kostenlose & quelloffene Datenbank-GUI
Das beste SQL-Abfrage- & Editor-Tool, das ich je benutzt habe. Es bietet alles, was ich zum Verwalten meiner Datenbank brauche. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio ist schnell, intuitiv und einfach zu bedienen. Beekeeper unterstützt jede Menge Datenbanken und läuft hervorragend auf Windows, Mac und Linux.
Was Nutzer über Beekeeper Studio sagen
„Beekeeper Studio hat meinen alten SQL-Workflow komplett ersetzt. Es ist schnell, intuitiv und macht die Arbeit mit Datenbanken wieder zum Vergnügen.“
„Ich habe viele Datenbank-GUIs ausprobiert, aber Beekeeper trifft die perfekte Balance zwischen Funktionsumfang und Einfachheit. Es funktioniert einfach.“