
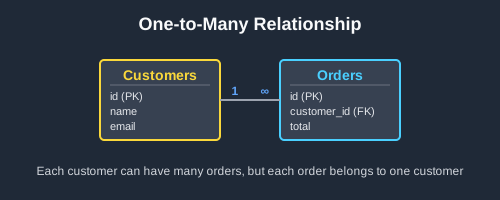
Una relación uno a muchos vincula una fila de una tabla padre con cualquier cantidad de filas de una tabla hija, como un cliente y sus pedidos. La construyes con una columna de llave foránea en la tabla hija que apunta al padre. Los ejemplos funcionan en PostgreSQL, MySQL, SQLite y SQL Server.
Cómo modelar una relación uno a muchos
Agrega a la tabla hija, el lado “muchos”, una columna que guarde la llave primaria de su padre y declárala como llave foránea. Cada pedido guarda el id del cliente que lo hizo, y la tabla de clientes no cambia para nada.
CREATE TABLE customers (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL
);

-- Each order stores the id of the customer who placed it
CREATE TABLE orders (
    id INTEGER PRIMARY KEY,
    customer_id INTEGER NOT NULL,
    order_date DATE NOT NULL,
    total DECIMAL(10,2) NOT NULL,
    FOREIGN KEY (customer_id) REFERENCES customers(id)
);
Une las dos tablas por la llave foránea para ver a cada cliente con sus pedidos:
-- Input: customers
-- id | name
-- ---+------
-- 1  | Alice
-- 2  | Bob
-- 3  | Carol

-- Input: orders
-- id | customer_id | order_date | total
-- ---+-------------+------------+-------
-- 1  | 2           | 2026-03-02 | 42.50
-- 2  | 1           | 2026-03-05 | 18.00
-- 3  | 2           | 2026-04-11 | 120.00
-- 4  | 2           | 2026-05-20 | 64.99

SELECT c.name, o.order_date, o.total
FROM customers c
JOIN orders o ON c.id = o.customer_id
ORDER BY c.name, o.order_date;

-- Output:
-- name  | order_date | total
-- ------+------------+-------
-- Alice | 2026-03-05 | 18.00
-- Bob   | 2026-03-02 | 42.50
-- Bob   | 2026-04-11 | 120.00
-- Bob   | 2026-05-20 | 64.99
Bob tiene tres pedidos y cada pedido tiene un solo cliente.
Reglas que debes conocer
-
La llave foránea va en la tabla hija. Cada pedido registra a su cliente. Nunca le pongas a
customersuna columna con una lista de IDs de pedidos. - Un JOIN simple descarta a los padres sin hijos. Carol no aparece en el resultado de arriba. Usa un LEFT JOIN cuando todos los padres deban aparecer, como en los ejemplos más abajo.
-
Indexa la llave foránea. Los joins y las búsquedas por cliente necesitan un índice en
orders.customer_id(MySQL lo crea por ti junto con la llave foránea):
CREATE INDEX idx_orders_customer_id ON orders(customer_id);
-
La llave foránea protege ambas tablas. Rechaza un pedido para un cliente que no existe y, por defecto, se niega a borrar un cliente que todavía tiene pedidos. Agrega
ON DELETE CASCADEpara borrar sus pedidos junto con él, oON DELETE SET NULLpara conservar los pedidos sin cliente (en ese caso la columna debe permitir NULL):
-- Input: the customers and orders tables above

INSERT INTO orders VALUES (5, 99, '2026-06-01', 10.00);
-- ERROR: insert or update on table "orders" violates foreign key constraint "orders_customer_id_fkey"

DELETE FROM customers WHERE id = 1;
-- ERROR: update or delete on table "customers" violates foreign key constraint "orders_customer_id_fkey" on table "orders"

-- With FOREIGN KEY (customer_id) REFERENCES customers(id) ON DELETE CASCADE
DELETE FROM customers WHERE id = 1;

-- Output (orders after the DELETE):
-- id | customer_id | order_date | total
-- ---+-------------+------------+-------
-- 1  | 2           | 2026-03-02 | 42.50
-- 3  | 2           | 2026-04-11 | 120.00
-- 4  | 2           | 2026-05-20 | 64.99
-
SQLite ignora las llaves foráneas hasta que las activas. Ejecuta
PRAGMA foreign_keys = ON;en cada conexión, o SQLite aceptará pedidos de clientes que no existen.
Sintaxis alternativa
Hay otras tres formas de declarar la misma llave:
-- Inline on the column (MySQL 8.0 accepts this but silently ignores it)
customer_id INTEGER NOT NULL REFERENCES customers(id)

-- Named, so errors and later changes can refer to it
CONSTRAINT fk_orders_customer FOREIGN KEY (customer_id) REFERENCES customers(id)

-- Added to an existing table (SQLite can't add a foreign key this way)
ALTER TABLE orders ADD CONSTRAINT fk_orders_customer
    FOREIGN KEY (customer_id) REFERENCES customers(id);
Para ids que la base de datos llena por ti, declara la llave del padre como SERIAL PRIMARY KEY en PostgreSQL, INT AUTO_INCREMENT PRIMARY KEY en MySQL, INTEGER PRIMARY KEY en SQLite o INT IDENTITY PRIMARY KEY en SQL Server. La columna de llave foránea sigue siendo un entero simple.
¿Cuándo deberías usar una relación uno a muchos?
Úsala siempre que cada hijo pertenezca a exactamente un padre: clientes y pedidos, posts y comentarios, departamentos y empleados, categorías y productos. Si un hijo puede tener varios padres, como un estudiante que toma varios cursos, necesitas una relación muchos a muchos. Estos son los problemas que una relación uno a muchos te permite resolver.
Mostrar cada padre con sus hijos
Una factura con sus partidas, un post con sus comentarios: une la tabla hija con la padre por la llave foránea. Las columnas del padre se repiten en cada fila hija.
Contar los hijos de cada padre
Cuántos pedidos ha hecho cada cliente, cuántos artículos ha escrito cada autor: haz un LEFT JOIN, agrupa por el padre y cuenta una columna del hijo. Contar una columna del hijo en lugar de * hace que los padres sin hijos salgan con 0.
Encontrar padres sin hijos
Clientes que nunca hicieron un pedido, departamentos sin proyectos, productos que nadie ha reseñado. Un LEFT JOIN llena las columnas del hijo con NULL cuando no hay coincidencia, así que quédate con las filas donde el id del hijo es NULL.
Sumar los valores de los hijos
Ingresos por cliente, valor del inventario por categoría, horas registradas por proyecto: SUM, AVG, MIN o MAX sobre las filas hijas, agrupadas por el padre. Un padre sin hijos obtiene NULL, que COALESCE convierte en 0.
Guardar una jerarquía en una sola tabla
Empleados y sus gerentes, carpetas y subcarpetas, categorías y subcategorías: la llave foránea apunta a la misma tabla, y un NULL en ella marca la cima del árbol. Une la tabla consigo misma para poner cada fila junto a su padre.
Ejemplos reales de relaciones uno a muchos
Mostrar el pedido más reciente de cada cliente
ROW_NUMBER() numera los pedidos de cada cliente del más nuevo al más antiguo. Quédate con el número 1:
-- Input: customers
-- id | name
-- ---+------
-- 1  | Alice
-- 2  | Bob
-- 3  | Carol

-- Input: orders
-- id | customer_id | order_date | total
-- ---+-------------+------------+-------
-- 1  | 2           | 2026-03-02 | 42.50
-- 2  | 1           | 2026-03-05 | 18.00
-- 3  | 2           | 2026-04-11 | 120.00
-- 4  | 2           | 2026-05-20 | 64.99

SELECT name, order_date, total
FROM (
    SELECT c.name, o.order_date, o.total,
           ROW_NUMBER() OVER (PARTITION BY c.id ORDER BY o.order_date DESC) AS rn
    FROM customers c
    JOIN orders o ON c.id = o.customer_id
) latest
WHERE rn = 1
ORDER BY name;

-- Output:
-- name  | order_date | total
-- ------+------------+------
-- Alice | 2026-03-05 | 18.00
-- Bob   | 2026-05-20 | 64.99
Clasificar clientes por número de pedidos
-- Input: the customers and orders tables above

SELECT c.name, COUNT(o.id) AS order_count
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
GROUP BY c.id, c.name
ORDER BY order_count DESC;

-- Output:
-- name  | order_count
-- ------+------------
-- Bob   | 3
-- Alice | 1
-- Carol | 0
Encontrar clientes que nunca han hecho un pedido
-- Input: the customers and orders tables above

SELECT c.name
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
WHERE o.id IS NULL;

-- Output:
-- name
-- -----
-- Carol
NOT EXISTS hace lo mismo y se lee más parecido a la pregunta:
-- Input: the customers and orders tables above

SELECT c.name
FROM customers c
WHERE NOT EXISTS (
    SELECT 1 FROM orders o WHERE o.customer_id = c.id
);

-- Output:
-- name
-- -----
-- Carol
Encontrar a quienes más gastan
SUM sobre cero filas da NULL, así que COALESCE convierte el total de Carol en 0:
-- Input: the customers and orders tables above

SELECT c.name, COALESCE(SUM(o.total), 0) AS total_spent
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
GROUP BY c.id, c.name
ORDER BY total_spent DESC;

-- Output:
-- name  | total_spent
-- ------+------------
-- Bob   | 227.49
-- Alice | 18.00
-- Carol | 0
Recorrer un organigrama de arriba hacia abajo
El manager_id de cada empleado apunta a otro empleado. Una consulta recursiva empieza por la persona sin gerente y agrega un nivel de subordinados a la vez:
CREATE TABLE employees (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL,
    manager_id INTEGER,  -- NULL for the person at the top
    FOREIGN KEY (manager_id) REFERENCES employees(id)
);

-- Input: employees
-- id | name  | manager_id
-- ---+-------+-----------
-- 1  | Maya  | NULL
-- 2  | Raj   | 1
-- 3  | Lena  | 1
-- 4  | Tom   | 2
-- 5  | Sofia | 2

-- In SQL Server, write WITH instead of WITH RECURSIVE
WITH RECURSIVE org_chart AS (
    -- Start at the top: the employee with no manager
    SELECT id, name, 0 AS level
    FROM employees
    WHERE manager_id IS NULL

    UNION ALL

    -- Then add each employee's direct reports, one level at a time
    SELECT e.id, e.name, oc.level + 1
    FROM employees e
    JOIN org_chart oc ON e.manager_id = oc.id
)
SELECT name, level
FROM org_chart
ORDER BY level, name;

-- Output:
-- name  | level
-- ------+------
-- Maya  | 0
-- Lena  | 1
-- Raj   | 1
-- Sofia | 2
-- Tom   | 2
Lecturas adicionales sobre relaciones uno a muchos
En este blog:
- Guía de relaciones de bases de datos: uno a uno, uno a muchos y muchos a muchos lado a lado
- Guía de relaciones muchos a muchos: cuando ambos lados pueden tener muchos, usando una tabla intermedia
- Relaciones uno a uno en bases de datos: cuando cada fila tiene exactamente una pareja
- Cómo usar llaves foráneas en PostgreSQL: crear llaves foráneas y elegir qué pasa cuando cambia un padre
- Guía de diagramas de SQL JOIN: joins INNER y LEFT entre tablas padre e hija
- Guía de SQL GROUP BY: contar y sumar filas hijas por padre
- Guía de SQL CTE vs. subconsulta: CTEs, incluidas las recursivas
Documentación oficial:
- PostgreSQL: Llaves foráneas
- MySQL: Restricciones FOREIGN KEY
- SQLite: Soporte de llaves foráneas
- SQL Server: Restricciones de llave primaria y foránea
 Beekeeper Studio es un cliente de bases de datos gratuito y de código abierto
La mejor herramienta de consultas y edición de SQL que he usado. Tiene todo lo que necesito para administrar mi base de datos. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio es rápido, intuitivo y fácil de usar. Es compatible con muchísimas bases de datos y funciona de maravilla en Windows, Mac y Linux.
Lo que dicen los usuarios de Beekeeper Studio
"Beekeeper Studio reemplazó por completo mi antiguo flujo de trabajo con SQL. Es rápido, intuitivo y hace que trabajar con bases de datos vuelva a ser divertido."
"He probado muchas GUIs de bases de datos, pero Beekeeper logra el equilibrio perfecto entre funciones y simplicidad. Simplemente funciona."