
Une relation plusieurs-à-plusieurs relie deux tables où une ligne de chaque côté peut correspondre à plusieurs lignes de l’autre : un étudiant suit plusieurs cours, et un cours a plusieurs étudiants. On la modélise avec une table de jonction qui stocke une ligne par lien. Les exemples fonctionnent avec PostgreSQL, MySQL, SQLite et SQL Server.
Comment modéliser une relation plusieurs-à-plusieurs
Crée une troisième table, la table de jonction (aussi appelée table pont, d’association ou de liaison), avec une clé étrangère vers chaque côté. Chaque ligne est un lien : cet étudiant suit ce cours.
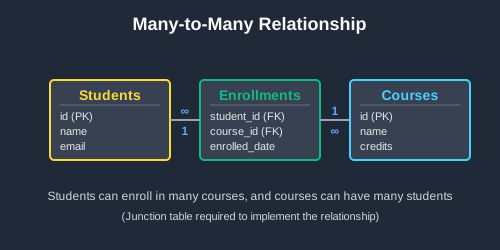
CREATE TABLE students (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
    id INTEGER PRIMARY KEY,
    course_name VARCHAR(100) NOT NULL
);

-- The junction table: one row per student per course
CREATE TABLE enrollments (
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    PRIMARY KEY (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);
Pour passer d’un côté à l’autre, fais une jointure via la table de jonction :
-- Input: students
-- id | name
-- ---+------
-- 1  | Ana
-- 2  | Ben
-- 3  | Chloe

-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT s.name, c.course_name
FROM students s
JOIN enrollments e ON s.id = e.student_id
JOIN courses c ON e.course_id = c.id
ORDER BY s.name, c.course_name;

-- Output:
-- name  | course_name
-- ------+------------
-- Ana   | Biology
-- Ana   | Chemistry
-- Ben   | Biology
-- Chloe | Biology
Ana suit deux cours et Biology a trois étudiants, donc la relation est « plusieurs » dans les deux sens.
Les règles à connaître
-
Fais de la paire la clé primaire.
PRIMARY KEY (student_id, course_id)empêche de stocker deux fois le même lien :
-- Input: the enrollments table above

INSERT INTO enrollments VALUES (1, 1);
-- ERROR: duplicate key value violates unique constraint "enrollments_pkey"
-
Indexe la deuxième colonne. L’index de la clé primaire commence par
student_id, il trouve donc déjà rapidement les cours d’un étudiant. Pour trouver rapidement les étudiants d’un cours, il faut un index qui commence parcourse_id(MySQL en crée un pour toi avec la clé étrangère) :
CREATE INDEX idx_enrollments_course_id ON enrollments(course_id);
-
Stocke une ligne par lien, jamais une liste. Une colonne
course_idscontenant'1,2'ne peut être ni jointe, ni indexée, ni vérifiée par une clé étrangère. -
SQLite ignore les clés étrangères tant que tu ne les actives pas. Lance
PRAGMA foreign_keys = ON;sur chaque connexion, sinon SQLite acceptera une inscription pour un étudiant qui n’existe pas.
Syntaxe alternative
Certains frameworks donnent à chaque table sa propre colonne id, tables de jonction comprises. Ça marche à condition d’ajouter une contrainte UNIQUE sur la paire, car l’id seul n’empêche pas les liens en double. Seule la colonne id change d’une base de données à l’autre :
-- PostgreSQL
CREATE TABLE enrollments (
    id SERIAL PRIMARY KEY,
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    UNIQUE (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);

-- MySQL:      id INT AUTO_INCREMENT PRIMARY KEY
-- SQLite:     id INTEGER PRIMARY KEY
-- SQL Server: id INT IDENTITY PRIMARY KEY
Tu peux aussi déclarer une clé étrangère en ligne : student_id INTEGER NOT NULL REFERENCES students(id). MySQL 8.0 accepte cette forme mais l’ignore sans rien dire, alors garde la clause FOREIGN KEY séparée dans ce cas.
Quand utiliser une relation plusieurs-à-plusieurs ?
Utilise-la dès que les lignes des deux côtés peuvent avoir plusieurs partenaires : étudiants et cours, articles et tags, utilisateurs et rôles, produits et catégories. Si chaque ligne d’un côté n’a jamais qu’un seul partenaire, une relation un-à-plusieurs suffit. Une fois la table de jonction en place, elle résout les problèmes suivants.
Retrouver ce à quoi une ligne est liée
Quels cours suit un étudiant ? Quels tags sont sur un article ? Fais une jointure de la ligne vers la table de jonction, puis vers l’autre côté. La même table de jonction répond à la question dans les deux sens.
Compter les liens de chaque côté
Le cours le plus rempli, le tag le plus utilisé, le membre inscrit dans le plus de clubs : regroupe par un côté et compte ses lignes dans la table de jonction. Utilise un LEFT JOIN quand les lignes sans lien doivent compter pour 0 au lieu de disparaître.
Stocker des détails sur chaque lien
Une note appartient à un étudiant dans un cours, pas à l’étudiant ou au cours seul, et une part de droits d’auteur appartient à un auteur pour un livre donné. Mets ces colonnes dans la table de jonction et interroge-les comme n’importe quelle autre colonne.
Relier des lignes d’une même table
Abonnés, amis et mentors relient des personnes à d’autres personnes. Les deux clés étrangères de la table de jonction pointent vers la même table, donc tu joins cette table deux fois, avec un alias différent à chaque fois.
Exemples concrets de relations plusieurs-à-plusieurs
Trouver les articles qui ont tous les tags d’une liste
Un filtre par tags signifie généralement « les articles avec tous ces tags ». Récupère ceux qui ont n’importe lequel des tags, puis garde ceux qui les ont tous :
-- Input: posts
-- id | title
-- ---+----------------
-- 1  | Indexing basics
-- 2  | Weekend hiking
-- 3  | Joins explained

-- Input: tags
-- id | name
-- ---+---------
-- 1  | sql
-- 2  | outdoors
-- 3  | beginner

-- Input: post_tags
-- post_id | tag_id
-- --------+-------
-- 1       | 1
-- 1       | 3
-- 2       | 2
-- 2       | 3
-- 3       | 1

SELECT p.title
FROM posts p
JOIN post_tags pt ON p.id = pt.post_id
JOIN tags t ON pt.tag_id = t.id
WHERE t.name IN ('sql', 'beginner')
GROUP BY p.id, p.title
HAVING COUNT(*) = 2;

-- Output:
-- title
-- ---------------
-- Indexing basics
« Joins explained » n’a qu’un seul des deux tags, il est donc éliminé au HAVING. Remplace le 2 par le nombre de tags de la liste.
Trouver les cours les plus populaires
Compte les inscriptions de chaque cours. Le LEFT JOIN conserve Physics, où personne ne s’est inscrit :
-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT c.course_name, COUNT(e.student_id) AS student_count
FROM courses c
LEFT JOIN enrollments e ON c.id = e.course_id
GROUP BY c.id, c.course_name
ORDER BY student_count DESC;

-- Output:
-- course_name | student_count
-- ------------+--------------
-- Biology     | 3
-- Chemistry   | 1
-- Physics     | 0
Savoir qui a travaillé où, et quand
Donne à chaque lien une date de début et de fin, et la table de jonction conserve un historique. Quelqu’un peut revenir dans un service qu’il a quitté, donc la paire n’est plus unique et la date de début rejoint la clé primaire. Le service actuel est la ligne sans date de fin :
CREATE TABLE employee_departments (
    employee_id INTEGER NOT NULL,
    department_id INTEGER NOT NULL,
    start_date DATE NOT NULL,
    end_date DATE,  -- NULL while it's their current department
    PRIMARY KEY (employee_id, department_id, start_date),
    FOREIGN KEY (employee_id) REFERENCES employees(id),
    FOREIGN KEY (department_id) REFERENCES departments(id)
);

-- Input: employees
-- id | name
-- ---+------
-- 1  | Grace
-- 2  | Omar
-- 3  | Wei

-- Input: departments
-- id | name
-- ---+------------
-- 1  | Sales
-- 2  | Support
-- 3  | Engineering

-- Input: employee_departments
-- employee_id | department_id | start_date | end_date
-- ------------+---------------+------------+-----------
-- 1           | 1             | 2022-03-01 | 2024-06-30
-- 1           | 3             | 2024-07-01 | NULL
-- 2           | 2             | 2023-01-09 | NULL
-- 3           | 1             | 2021-05-17 | NULL

SELECT e.name, d.name AS department, ed.start_date
FROM employees e
JOIN employee_departments ed ON e.id = ed.employee_id
JOIN departments d ON ed.department_id = d.id
WHERE ed.end_date IS NULL
ORDER BY e.name;

-- Output:
-- name  | department  | start_date
-- ------+-------------+-----------
-- Grace | Engineering | 2024-07-01
-- Omar  | Support     | 2023-01-09
-- Wei   | Sales       | 2021-05-17
Pour empêcher quelqu’un d’avoir deux services actuels, ajoute un index unique partiel : CREATE UNIQUE INDEX idx_current_dept ON employee_departments(employee_id) WHERE end_date IS NULL;. MySQL n’a pas d’index partiels, donc celui-ci n’y fonctionne pas.
Trouver les utilisateurs qui se suivent mutuellement
Une table follows relie des utilisateurs à des utilisateurs. Une contrainte CHECK empêche de se suivre soi-même, et joindre la table à elle-même trouve les paires qui se suivent mutuellement :
CREATE TABLE follows (
    follower_id INTEGER NOT NULL,
    followed_id INTEGER NOT NULL,
    PRIMARY KEY (follower_id, followed_id),
    FOREIGN KEY (follower_id) REFERENCES users(id),
    FOREIGN KEY (followed_id) REFERENCES users(id),
    CONSTRAINT no_self_follow CHECK (follower_id <> followed_id)
);

-- INSERT INTO follows VALUES (2, 2);
-- ERROR: new row for relation "follows" violates check constraint "no_self_follow"

-- Input: users
-- id | name
-- ---+-----
-- 1  | Ava
-- 2  | Leo
-- 3  | Mia
-- 4  | Noah

-- Input: follows
-- follower_id | followed_id
-- ------------+------------
-- 1           | 2
-- 2           | 1
-- 1           | 3
-- 3           | 4
-- 4           | 3

SELECT u1.name AS user_a, u2.name AS user_b
FROM follows f
JOIN follows back ON back.follower_id = f.followed_id
                 AND back.followed_id = f.follower_id
JOIN users u1 ON u1.id = f.follower_id
JOIN users u2 ON u2.id = f.followed_id
WHERE f.follower_id < f.followed_id
ORDER BY user_a;

-- Output:
-- user_a | user_b
-- -------+-------
-- Ava    | Leo
-- Mia    | Noah
Ava suit Mia, mais Mia ne la suit pas en retour, donc cette paire n’apparaît pas. La condition f.follower_id < f.followed_id liste chaque paire mutuelle une seule fois au lieu de deux.
Pour aller plus loin sur les relations plusieurs-à-plusieurs
Sur ce blog :
- Guide des relations en base de données : un-à-un, un-à-plusieurs et plusieurs-à-plusieurs côte à côte
- Guide des relations un-à-plusieurs : une clé étrangère côté « plusieurs », sans table de jonction
- Relations un-à-un en base de données : quand chaque ligne a exactement un partenaire
- Clés primaires composites en SQL : la clé à deux colonnes qu’utilise une table de jonction
- Guide illustré des JOIN SQL : les jointures qui traversent une table de jonction
- Guide du GROUP BY SQL : compter et additionner à travers les liens
Documentation officielle :
- PostgreSQL : clés étrangères
- MySQL : contraintes FOREIGN KEY
- SQLite : prise en charge des clés étrangères
- SQL Server : contraintes de clé primaire et étrangère
 Beekeeper Studio est une interface de base de données gratuite & open source
Le meilleur outil de requêtes & éditeur SQL que j’aie jamais utilisé. Il m’offre tout ce dont j’ai besoin pour gérer ma base de données. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio est rapide, intuitif et facile à utiliser. Beekeeper prend en charge plein de bases de données et fonctionne parfaitement sous Windows, Mac et Linux.
Ce que les utilisateurs disent de Beekeeper Studio
« Beekeeper Studio a complètement remplacé mon ancien workflow SQL. C’est rapide, intuitif, et ça rend le travail sur les bases de données à nouveau agréable. »
« J’ai essayé beaucoup d’interfaces de base de données, mais Beekeeper trouve l’équilibre parfait entre fonctionnalités et simplicité. Ça marche, tout simplement. »