
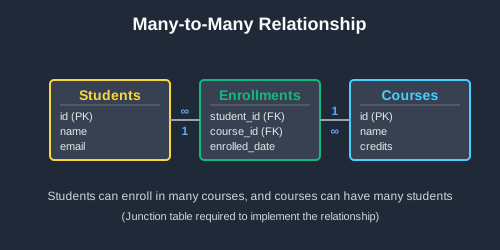
Um relacionamento muitos-para-muitos liga duas tabelas em que uma linha de qualquer lado pode corresponder a muitas linhas do outro: um aluno faz vários cursos, e um curso tem vários alunos. Você o modela com uma tabela de junção que guarda uma linha por vínculo. Os exemplos funcionam no PostgreSQL, MySQL, SQLite e SQL Server.
Como modelar um relacionamento muitos-para-muitos
Crie uma terceira tabela, a tabela de junção (também chamada de tabela ponte, de associação ou join table), com uma chave estrangeira para cada lado. Cada linha é um vínculo: este aluno faz este curso.
CREATE TABLE students (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
    id INTEGER PRIMARY KEY,
    course_name VARCHAR(100) NOT NULL
);

-- The junction table: one row per student per course
CREATE TABLE enrollments (
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    PRIMARY KEY (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);
Para ir de um lado ao outro, faça o join passando pela tabela de junção:
-- Input: students
-- id | name
-- ---+------
-- 1  | Ana
-- 2  | Ben
-- 3  | Chloe

-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT s.name, c.course_name
FROM students s
JOIN enrollments e ON s.id = e.student_id
JOIN courses c ON e.course_id = c.id
ORDER BY s.name, c.course_name;

-- Output:
-- name  | course_name
-- ------+------------
-- Ana   | Biology
-- Ana   | Chemistry
-- Ben   | Biology
-- Chloe | Biology
Ana faz dois cursos e Biologia tem três alunos, então o relacionamento é “muitos” nas duas direções.
Regras importantes
-
Use o par como chave primária.
PRIMARY KEY (student_id, course_id)impede que o mesmo vínculo seja gravado duas vezes:
-- Input: the enrollments table above

INSERT INTO enrollments VALUES (1, 1);
-- ERROR: duplicate key value violates unique constraint "enrollments_pkey"
-
Indexe a segunda coluna. O índice da chave primária começa com
student_id, então já encontra rapidamente os cursos de um aluno. Para encontrar rapidamente os alunos de um curso, é preciso um índice que comece comcourse_id(o MySQL cria um para você junto com a chave estrangeira):
CREATE INDEX idx_enrollments_course_id ON enrollments(course_id);
-
Guarde uma linha por vínculo, nunca uma lista. Uma coluna
course_idscontendo'1,2'não pode ser usada em joins, indexada nem validada por uma chave estrangeira. -
O SQLite ignora chaves estrangeiras até você ativá-las. Execute
PRAGMA foreign_keys = ON;em cada conexão, ou o SQLite vai aceitar uma matrícula de um aluno que não existe.
Sintaxe alternativa
Alguns frameworks dão a toda tabela sua própria coluna id, incluindo as tabelas de junção. Isso funciona desde que você adicione uma restrição UNIQUE no par, porque o id sozinho não impede vínculos duplicados. Só a coluna id muda entre os bancos de dados:
-- PostgreSQL
CREATE TABLE enrollments (
    id SERIAL PRIMARY KEY,
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    UNIQUE (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);

-- MySQL:      id INT AUTO_INCREMENT PRIMARY KEY
-- SQLite:     id INTEGER PRIMARY KEY
-- SQL Server: id INT IDENTITY PRIMARY KEY
Você também pode declarar uma chave estrangeira inline: student_id INTEGER NOT NULL REFERENCES students(id). O MySQL 8.0 aceita essa forma, mas a ignora silenciosamente, então mantenha a cláusula FOREIGN KEY separada nele.
Quando usar um relacionamento muitos-para-muitos?
Use sempre que as linhas dos dois lados puderem ter vários parceiros: alunos e cursos, posts e tags, usuários e papéis, produtos e categorias. Se cada linha de um lado tiver sempre um único parceiro, um relacionamento um-para-muitos é suficiente. Com a tabela de junção pronta, ela resolve estes problemas.
Consultar a que uma linha está vinculada
Quais cursos um aluno faz? Quais tags estão em um post? Faça o join da linha para a tabela de junção e dela para o outro lado. A mesma tabela de junção responde à pergunta nas duas direções.
Contar os vínculos de cada lado
O curso mais cheio, a tag mais usada, o membro com mais clubes: agrupe por um lado e conte suas linhas na tabela de junção. Use um LEFT JOIN quando linhas sem vínculos devem contar como 0 em vez de sumir.
Guardar detalhes de cada vínculo
Uma nota pertence a um aluno em um curso, não só ao aluno ou só ao curso, e uma participação nos royalties pertence a um autor em um livro específico. Coloque essas colunas na tabela de junção e consulte-as como qualquer outra coluna.
Vincular linhas da mesma tabela
Seguidores, amigos e mentores ligam pessoas a outras pessoas. As duas chaves estrangeiras da tabela de junção apontam para a mesma tabela, então você faz o join dessa tabela duas vezes, com um alias diferente em cada uma.
Exemplos reais de relacionamentos muitos-para-muitos
Encontrar posts que têm todas as tags de uma lista
Um filtro de tags geralmente significa “posts com todas estas tags”. Busque qualquer uma das tags e depois mantenha os posts que corresponderam a todas:
-- Input: posts
-- id | title
-- ---+----------------
-- 1  | Indexing basics
-- 2  | Weekend hiking
-- 3  | Joins explained

-- Input: tags
-- id | name
-- ---+---------
-- 1  | sql
-- 2  | outdoors
-- 3  | beginner

-- Input: post_tags
-- post_id | tag_id
-- --------+-------
-- 1       | 1
-- 1       | 3
-- 2       | 2
-- 2       | 3
-- 3       | 1

SELECT p.title
FROM posts p
JOIN post_tags pt ON p.id = pt.post_id
JOIN tags t ON pt.tag_id = t.id
WHERE t.name IN ('sql', 'beginner')
GROUP BY p.id, p.title
HAVING COUNT(*) = 2;

-- Output:
-- title
-- ---------------
-- Indexing basics
“Joins explained” tem só uma das duas tags, então é descartado no HAVING. Troque o 2 pelo número de tags da lista.
Encontrar os cursos mais populares
Conte as matrículas de cada curso. O LEFT JOIN mantém Física, em que ninguém se inscreveu:
-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT c.course_name, COUNT(e.student_id) AS student_count
FROM courses c
LEFT JOIN enrollments e ON c.id = e.course_id
GROUP BY c.id, c.course_name
ORDER BY student_count DESC;

-- Output:
-- course_name | student_count
-- ------------+--------------
-- Biology     | 3
-- Chemistry   | 1
-- Physics     | 0
Registrar quem trabalhou onde e quando
Dê a cada vínculo uma data de início e de fim, e a tabela de junção passa a guardar um histórico. Alguém pode voltar a um departamento que deixou, então o par deixa de ser único e a data de início entra na chave primária. O departamento atual é a linha sem data de fim:
CREATE TABLE employee_departments (
    employee_id INTEGER NOT NULL,
    department_id INTEGER NOT NULL,
    start_date DATE NOT NULL,
    end_date DATE,  -- NULL while it's their current department
    PRIMARY KEY (employee_id, department_id, start_date),
    FOREIGN KEY (employee_id) REFERENCES employees(id),
    FOREIGN KEY (department_id) REFERENCES departments(id)
);

-- Input: employees
-- id | name
-- ---+------
-- 1  | Grace
-- 2  | Omar
-- 3  | Wei

-- Input: departments
-- id | name
-- ---+------------
-- 1  | Sales
-- 2  | Support
-- 3  | Engineering

-- Input: employee_departments
-- employee_id | department_id | start_date | end_date
-- ------------+---------------+------------+-----------
-- 1           | 1             | 2022-03-01 | 2024-06-30
-- 1           | 3             | 2024-07-01 | NULL
-- 2           | 2             | 2023-01-09 | NULL
-- 3           | 1             | 2021-05-17 | NULL

SELECT e.name, d.name AS department, ed.start_date
FROM employees e
JOIN employee_departments ed ON e.id = ed.employee_id
JOIN departments d ON ed.department_id = d.id
WHERE ed.end_date IS NULL
ORDER BY e.name;

-- Output:
-- name  | department  | start_date
-- ------+-------------+-----------
-- Grace | Engineering | 2024-07-01
-- Omar  | Support     | 2023-01-09
-- Wei   | Sales       | 2021-05-17
Para impedir que alguém tenha dois departamentos atuais, adicione um índice único parcial: CREATE UNIQUE INDEX idx_current_dept ON employee_departments(employee_id) WHERE end_date IS NULL;. O MySQL não tem índices parciais, então isso não funciona nele.
Encontrar usuários que se seguem mutuamente
Uma tabela follows liga usuários a usuários. Uma restrição CHECK impede que alguém siga a si mesmo, e o join da tabela com ela mesma encontra os pares que se seguem mutuamente:
CREATE TABLE follows (
    follower_id INTEGER NOT NULL,
    followed_id INTEGER NOT NULL,
    PRIMARY KEY (follower_id, followed_id),
    FOREIGN KEY (follower_id) REFERENCES users(id),
    FOREIGN KEY (followed_id) REFERENCES users(id),
    CONSTRAINT no_self_follow CHECK (follower_id <> followed_id)
);

-- INSERT INTO follows VALUES (2, 2);
-- ERROR: new row for relation "follows" violates check constraint "no_self_follow"

-- Input: users
-- id | name
-- ---+-----
-- 1  | Ava
-- 2  | Leo
-- 3  | Mia
-- 4  | Noah

-- Input: follows
-- follower_id | followed_id
-- ------------+------------
-- 1           | 2
-- 2           | 1
-- 1           | 3
-- 3           | 4
-- 4           | 3

SELECT u1.name AS user_a, u2.name AS user_b
FROM follows f
JOIN follows back ON back.follower_id = f.followed_id
                 AND back.followed_id = f.follower_id
JOIN users u1 ON u1.id = f.follower_id
JOIN users u2 ON u2.id = f.followed_id
WHERE f.follower_id < f.followed_id
ORDER BY user_a;

-- Output:
-- user_a | user_b
-- -------+-------
-- Ava    | Leo
-- Mia    | Noah
Ava segue Mia, mas Mia não a segue de volta, então esse par não aparece. A condição f.follower_id < f.followed_id lista cada par mútuo uma vez em vez de duas.
Leituras adicionais sobre relacionamentos muitos-para-muitos
Neste blog:
- Guia de relacionamentos de banco de dados: um-para-um, um-para-muitos e muitos-para-muitos lado a lado
- Guia de relacionamento um-para-muitos: uma chave estrangeira no lado “muitos”, sem tabela de junção
- Relacionamentos um-para-um em bancos de dados: quando cada linha tem exatamente um parceiro
- Chaves primárias compostas em SQL: a chave de duas colunas usada pela tabela de junção
- Guia de diagramas de SQL JOIN: os joins que passam por uma tabela de junção
- Guia de SQL GROUP BY: contando e somando entre vínculos
Documentação oficial:
- PostgreSQL: Chaves estrangeiras
- MySQL: Restrições FOREIGN KEY
- SQLite: Suporte a chaves estrangeiras
- SQL Server: Restrições de chave primária e estrangeira
 Beekeeper Studio é um cliente de banco de dados gratuito e open source
A melhor ferramenta de consultas e edição de SQL que já usei. Tem tudo o que preciso para gerenciar meu banco de dados. - ⭐⭐⭐⭐⭐ Mit
O Beekeeper Studio é rápido, intuitivo e fácil de usar. Ele suporta vários bancos de dados e funciona muito bem no Windows, Mac e Linux.
O que os usuários dizem sobre o Beekeeper Studio
"O Beekeeper Studio substituiu completamente meu antigo fluxo de trabalho com SQL. É rápido, intuitivo e torna o trabalho com banco de dados prazeroso de novo."
"Já testei muitas GUIs de banco de dados, mas o Beekeeper encontra o equilíbrio perfeito entre recursos e simplicidade. Simplesmente funciona."