
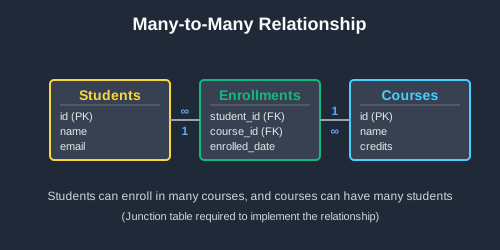
다대다 관계는 양쪽의 한 행이 상대편의 여러 행과 연결될 수 있는 두 테이블을 잇는 관계예요. 학생 한 명은 여러 과목을 수강하고, 한 과목에는 여러 학생이 있죠. 연결 하나당 행 하나를 저장하는 정션 테이블로 모델링해요. 예제는 PostgreSQL, MySQL, SQLite, SQL Server에서 동작해요.
다대다 관계를 모델링하는 방법
양쪽 테이블을 각각 가리키는 외래 키를 가진 세 번째 테이블, 즉 정션 테이블(브리지, 연관, 조인 테이블이라고도 해요)을 만드세요. 각 행이 연결 하나를 나타내요. 이 학생이 이 과목을 수강한다는 뜻이죠.
CREATE TABLE students (
    id INTEGER PRIMARY KEY,
    name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
    id INTEGER PRIMARY KEY,
    course_name VARCHAR(100) NOT NULL
);

-- The junction table: one row per student per course
CREATE TABLE enrollments (
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    PRIMARY KEY (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);
한쪽에서 다른 쪽으로 가려면 정션 테이블을 거쳐 조인하세요:
-- Input: students
-- id | name
-- ---+------
-- 1  | Ana
-- 2  | Ben
-- 3  | Chloe

-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT s.name, c.course_name
FROM students s
JOIN enrollments e ON s.id = e.student_id
JOIN courses c ON e.course_id = c.id
ORDER BY s.name, c.course_name;

-- Output:
-- name  | course_name
-- ------+------------
-- Ana   | Biology
-- Ana   | Chemistry
-- Ben   | Biology
-- Chloe | Biology
Ana는 두 과목을 수강하고 Biology에는 학생이 세 명 있으니, 관계가 양방향 모두 “다(多)”예요.
알아 둘 규칙
-
두 컬럼 쌍을 기본 키로 만드세요.
PRIMARY KEY (student_id, course_id)는 같은 연결이 두 번 저장되는 것을 막아 줘요:
-- Input: the enrollments table above

INSERT INTO enrollments VALUES (1, 1);
-- ERROR: duplicate key value violates unique constraint "enrollments_pkey"
-
두 번째 컬럼에 인덱스를 거세요. 기본 키 인덱스는
student_id로 시작하므로 학생의 수강 과목은 이미 빠르게 찾아요. 과목의 수강생을 빠르게 찾으려면course_id로 시작하는 인덱스가 필요해요(MySQL은 외래 키와 함께 자동으로 만들어 줘요):
CREATE INDEX idx_enrollments_course_id ON enrollments(course_id);
-
목록이 아니라 연결 하나당 행 하나를 저장하세요.
'1,2'를 담은course_ids컬럼은 조인도, 인덱싱도, 외래 키 검사도 할 수 없어요. -
SQLite는 외래 키를 켜기 전까지 무시해요. 연결할 때마다
PRAGMA foreign_keys = ON;을 실행하세요. 그러지 않으면 SQLite는 존재하지 않는 학생의 수강 신청도 받아들여요.
다른 문법
일부 프레임워크는 정션 테이블을 포함한 모든 테이블에 자체 id 컬럼을 둬요. 쌍에 UNIQUE 제약 조건을 추가하면 괜찮아요. id만으로는 중복 연결을 막지 못하거든요. 데이터베이스마다 달라지는 건 id 컬럼뿐이에요:
-- PostgreSQL
CREATE TABLE enrollments (
    id SERIAL PRIMARY KEY,
    student_id INTEGER NOT NULL,
    course_id INTEGER NOT NULL,
    UNIQUE (student_id, course_id),
    FOREIGN KEY (student_id) REFERENCES students(id),
    FOREIGN KEY (course_id) REFERENCES courses(id)
);

-- MySQL:      id INT AUTO_INCREMENT PRIMARY KEY
-- SQLite:     id INTEGER PRIMARY KEY
-- SQL Server: id INT IDENTITY PRIMARY KEY
외래 키를 인라인으로 선언할 수도 있어요: student_id INTEGER NOT NULL REFERENCES students(id). MySQL 8.0은 이 형식을 받아들이지만 조용히 무시하므로, MySQL에서는 별도의 FOREIGN KEY 절을 유지하세요.
다대다 관계는 언제 사용해야 할까요?
양쪽 행 모두 여러 상대를 가질 수 있을 때 사용하세요. 학생과 과목, 게시물과 태그, 사용자와 역할, 상품과 카테고리 같은 경우예요. 한쪽의 각 행이 항상 상대 하나만 가진다면 일대다 관계로 충분해요. 정션 테이블을 만들어 두면 다음 문제들을 해결할 수 있어요.
행이 무엇과 연결되어 있는지 조회하기
학생이 어떤 과목을 수강할까요? 게시물에 어떤 태그가 달렸을까요? 해당 행에서 정션 테이블을 거쳐 반대편으로 조인하세요. 같은 정션 테이블로 양방향 질문에 모두 답할 수 있어요.
양쪽의 연결 수 세기
수강생이 가장 많은 과목, 가장 많이 쓰인 태그, 가장 많은 동아리에 가입한 회원: 한쪽 기준으로 그룹화하고 정션 테이블의 행 수를 세세요. 연결이 없는 행을 사라지게 하지 않고 0으로 세려면 LEFT JOIN을 사용하세요.
각 연결에 대한 세부 정보 저장하기
성적은 학생이나 과목 하나가 아니라 특정 과목을 듣는 학생에게 속하고, 인세 비율은 특정 책의 저자에게 속해요. 이런 컬럼은 정션 테이블에 두고 다른 컬럼처럼 쿼리하세요.
같은 테이블의 행끼리 연결하기
팔로워, 친구, 멘토는 사람과 다른 사람을 연결해요. 정션 테이블의 두 외래 키가 모두 같은 테이블을 가리키므로, 그 테이블을 매번 다른 별칭으로 두 번 조인해요.
다대다 관계의 실제 예제
목록의 모든 태그를 가진 게시물 찾기
태그 필터는 보통 “이 태그를 모두 가진 게시물”을 뜻해요. 태그 중 하나라도 일치하는 행을 찾은 다음, 모두 일치한 게시물만 남기세요:
-- Input: posts
-- id | title
-- ---+----------------
-- 1  | Indexing basics
-- 2  | Weekend hiking
-- 3  | Joins explained

-- Input: tags
-- id | name
-- ---+---------
-- 1  | sql
-- 2  | outdoors
-- 3  | beginner

-- Input: post_tags
-- post_id | tag_id
-- --------+-------
-- 1       | 1
-- 1       | 3
-- 2       | 2
-- 2       | 3
-- 3       | 1

SELECT p.title
FROM posts p
JOIN post_tags pt ON p.id = pt.post_id
JOIN tags t ON pt.tag_id = t.id
WHERE t.name IN ('sql', 'beginner')
GROUP BY p.id, p.title
HAVING COUNT(*) = 2;

-- Output:
-- title
-- ---------------
-- Indexing basics
“Joins explained”는 두 태그 중 하나만 가지고 있어서 HAVING에서 걸러져요. 2를 목록의 태그 개수에 맞게 바꾸세요.
가장 인기 있는 과목 찾기
과목별 수강 신청 수를 세세요. LEFT JOIN 덕분에 아무도 신청하지 않은 Physics도 남아요:
-- Input: courses
-- id | course_name
-- ---+------------
-- 1  | Biology
-- 2  | Chemistry
-- 3  | Physics

-- Input: enrollments
-- student_id | course_id
-- -----------+----------
-- 1          | 1
-- 1          | 2
-- 2          | 1
-- 3          | 1

SELECT c.course_name, COUNT(e.student_id) AS student_count
FROM courses c
LEFT JOIN enrollments e ON c.id = e.course_id
GROUP BY c.id, c.course_name
ORDER BY student_count DESC;

-- Output:
-- course_name | student_count
-- ------------+--------------
-- Biology     | 3
-- Chemistry   | 1
-- Physics     | 0
누가 언제 어디서 일했는지 추적하기
각 연결에 시작일과 종료일을 주면 정션 테이블이 이력을 보관해요. 떠났던 부서로 다시 돌아갈 수도 있으므로 쌍이 더 이상 고유하지 않고, 시작일도 기본 키에 포함돼요. 현재 부서는 종료일이 없는 행이에요:
CREATE TABLE employee_departments (
    employee_id INTEGER NOT NULL,
    department_id INTEGER NOT NULL,
    start_date DATE NOT NULL,
    end_date DATE,  -- NULL while it's their current department
    PRIMARY KEY (employee_id, department_id, start_date),
    FOREIGN KEY (employee_id) REFERENCES employees(id),
    FOREIGN KEY (department_id) REFERENCES departments(id)
);

-- Input: employees
-- id | name
-- ---+------
-- 1  | Grace
-- 2  | Omar
-- 3  | Wei

-- Input: departments
-- id | name
-- ---+------------
-- 1  | Sales
-- 2  | Support
-- 3  | Engineering

-- Input: employee_departments
-- employee_id | department_id | start_date | end_date
-- ------------+---------------+------------+-----------
-- 1           | 1             | 2022-03-01 | 2024-06-30
-- 1           | 3             | 2024-07-01 | NULL
-- 2           | 2             | 2023-01-09 | NULL
-- 3           | 1             | 2021-05-17 | NULL

SELECT e.name, d.name AS department, ed.start_date
FROM employees e
JOIN employee_departments ed ON e.id = ed.employee_id
JOIN departments d ON ed.department_id = d.id
WHERE ed.end_date IS NULL
ORDER BY e.name;

-- Output:
-- name  | department  | start_date
-- ------+-------------+-----------
-- Grace | Engineering | 2024-07-01
-- Omar  | Support     | 2023-01-09
-- Wei   | Sales       | 2021-05-17
누구든 현재 부서가 두 개가 되지 않도록 부분 고유 인덱스를 추가하세요: CREATE UNIQUE INDEX idx_current_dept ON employee_departments(employee_id) WHERE end_date IS NULL;. MySQL은 부분 인덱스를 지원하지 않아서 이 방법은 쓸 수 없어요.
서로 팔로우하는 사용자 찾기
follows 테이블은 사용자와 사용자를 연결해요. CHECK 제약 조건으로 자기 자신을 팔로우하지 못하게 하고, 테이블을 자기 자신과 조인해 서로 팔로우하는 쌍을 찾아요:
CREATE TABLE follows (
    follower_id INTEGER NOT NULL,
    followed_id INTEGER NOT NULL,
    PRIMARY KEY (follower_id, followed_id),
    FOREIGN KEY (follower_id) REFERENCES users(id),
    FOREIGN KEY (followed_id) REFERENCES users(id),
    CONSTRAINT no_self_follow CHECK (follower_id <> followed_id)
);

-- INSERT INTO follows VALUES (2, 2);
-- ERROR: new row for relation "follows" violates check constraint "no_self_follow"

-- Input: users
-- id | name
-- ---+-----
-- 1  | Ava
-- 2  | Leo
-- 3  | Mia
-- 4  | Noah

-- Input: follows
-- follower_id | followed_id
-- ------------+------------
-- 1           | 2
-- 2           | 1
-- 1           | 3
-- 3           | 4
-- 4           | 3

SELECT u1.name AS user_a, u2.name AS user_b
FROM follows f
JOIN follows back ON back.follower_id = f.followed_id
                 AND back.followed_id = f.follower_id
JOIN users u1 ON u1.id = f.follower_id
JOIN users u2 ON u2.id = f.followed_id
WHERE f.follower_id < f.followed_id
ORDER BY user_a;

-- Output:
-- user_a | user_b
-- -------+-------
-- Ava    | Leo
-- Mia    | Noah
Ava는 Mia를 팔로우하지만 Mia는 맞팔로우하지 않아서 이 쌍은 나오지 않아요. f.follower_id < f.followed_id 조건은 각 상호 팔로우 쌍을 두 번이 아니라 한 번만 표시해요.
다대다 관계에 대해 더 읽어 보기
이 블로그에서:
- 데이터베이스 관계 가이드: 일대일, 일대다, 다대다 관계 비교
- 일대다 관계 가이드: 정션 테이블 없이 “다” 쪽에 외래 키 두기
- 일대일 데이터베이스 관계: 각 행이 정확히 하나의 상대를 가질 때
- SQL 복합 기본 키: 정션 테이블이 사용하는 두 컬럼 키
- SQL JOIN 다이어그램 가이드: 정션 테이블을 거치는 조인
- SQL GROUP BY 가이드: 연결을 기준으로 개수와 합계 구하기
공식 문서:
 Beekeeper Studio는 무료 오픈 소스 데이터베이스 GUI예요
지금까지 써 본 SQL 쿼리 & 에디터 도구 중 최고예요. 데이터베이스 관리에 필요한 모든 게 다 있어요. - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studio는 빠르고 직관적이며 사용하기 쉬워요. 다양한 데이터베이스를 지원하고 Windows, Mac, Linux에서 모두 잘 작동해요.
Beekeeper Studio 사용자 후기
"Beekeeper Studio가 기존 SQL 작업 방식을 완전히 대체했어요. 빠르고 직관적이라 데이터베이스 작업이 다시 즐거워졌어요."
"여러 데이터베이스 GUI를 써 봤지만, Beekeeper는 기능과 단순함 사이의 균형이 완벽해요. 그냥 잘 돌아가요."