
SQL JOIN は、2つのテーブルに共通する列(たとえば本の author_id と著者の id)を照合して、行を結合します。一致しない行をどう扱うかは、JOIN の種類によって決まります。例は PostgreSQL、MySQL、SQLite、SQL Server で動作します。
SQL JOIN の使い方
2つ目のテーブルを JOIN の後に置き、その行が1つ目のテーブルの行とどう一致するかを ON で指定します。
SELECT columns
FROM table_a
JOIN table_b ON table_a.key = table_b.key;
このセクションの例はすべて同じ2つのテーブルを結合します。Butler は本を2冊書いており、Asimov はどの本も書いておらず、Beowulf の著者は不明です。
INNER JOIN
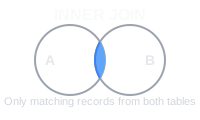
INNER JOIN は、両方のテーブルで一致する行だけを返します。JOIN とだけ書くと INNER JOIN になります。
-- Input: authors
-- id | name
-- ---+--------
-- 1  | Le Guin
-- 2  | Butler
-- 3  | Asimov

-- Input: books
-- title                | author_id
-- ---------------------+----------
-- The Dispossessed     | 1
-- Kindred              | 2
-- Parable of the Sower | 2
-- Beowulf              | NULL

SELECT a.name, b.title
FROM authors a
INNER JOIN books b ON a.id = b.author_id;

-- Output:
-- name    | title
-- --------+---------------------
-- Le Guin | The Dispossessed
-- Butler  | Kindred
-- Butler  | Parable of the Sower
Asimov には本がなく、Beowulf には著者がいないため、どちらも表示されません。
LEFT JOIN
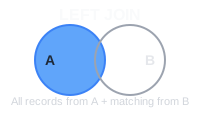
LEFT JOIN(または LEFT OUTER JOIN)は、左側のテーブル(FROM の後のテーブル)のすべての行を返します。右側のテーブルに一致する行がない場合、その列は NULL になります。
-- Input: the authors and books tables above

SELECT a.name, b.title
FROM authors a
LEFT JOIN books b ON a.id = b.author_id;

-- Output:
-- name    | title
-- --------+---------------------
-- Le Guin | The Dispossessed
-- Butler  | Kindred
-- Butler  | Parable of the Sower
-- Asimov  | NULL
RIGHT JOIN
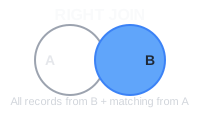
RIGHT JOIN(または RIGHT OUTER JOIN)はその逆です。右側のテーブルのすべての行を返し、左側のテーブルに一致がない部分は NULL になります。
-- Input: the authors and books tables above

SELECT a.name, b.title
FROM authors a
RIGHT JOIN books b ON a.id = b.author_id;

-- Output:
-- name    | title
-- --------+---------------------
-- Le Guin | The Dispossessed
-- Butler  | Kindred
-- Butler  | Parable of the Sower
-- NULL    | Beowulf
FULL OUTER JOIN
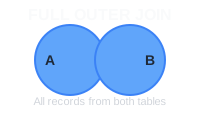
FULL OUTER JOIN は、両方のテーブルのすべての行を返します。一致する行は結合され、一致しない部分は NULL で埋められます。MySQL にはこの構文がないため、下の「代替構文」を参照してください。
-- Input: the authors and books tables above

SELECT a.name, b.title
FROM authors a
FULL OUTER JOIN books b ON a.id = b.author_id;

-- Output:
-- name    | title
-- --------+---------------------
-- Le Guin | The Dispossessed
-- Butler  | Kindred
-- Butler  | Parable of the Sower
-- NULL    | Beowulf
-- Asimov  | NULL
CROSS JOIN
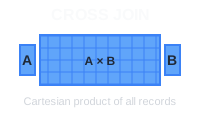
CROSS JOIN は、一方のテーブルのすべての行をもう一方のテーブルのすべての行と組み合わせるため、ON はありません。2つのサイズと2つの色なら4通りの組み合わせですが、1,000行×1,000行なら100万行になるため、小さなテーブルで使いましょう。
-- Input: sizes
-- size
-- ----
-- S
-- M

-- Input: colors
-- color
-- -----
-- Red
-- Blue

SELECT s.size, c.color
FROM sizes s
CROSS JOIN colors c;

-- Output:
-- size | color
-- -----+------
-- S    | Red
-- S    | Blue
-- M    | Red
-- M    | Blue
LEFT ANTI JOIN
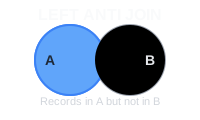
左アンチ結合は、右側のテーブルに一致する行がない左側のテーブルの行を返します。専用のキーワードはないため、LEFT JOIN を実行して右側が NULL になった行だけを残します。
-- Input: the authors and books tables above

SELECT a.name
FROM authors a
LEFT JOIN books b ON a.id = b.author_id
WHERE b.author_id IS NULL;

-- Output:
-- name
-- ------
-- Asimov
RIGHT ANTI JOIN
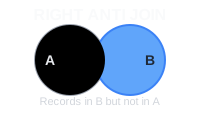
右アンチ結合は、左側のテーブルに一致する行がない右側のテーブルの行を返します。
-- Input: the authors and books tables above

SELECT b.title
FROM authors a
RIGHT JOIN books b ON a.id = b.author_id
WHERE a.id IS NULL;

-- Output:
-- title
-- -------
-- Beowulf
知っておくべきルール
-
NULL は何とも一致しません。別の NULL とも一致しません。Beowulf の NULL の
author_idはどの著者とも一致しないため、一致しない本を残す JOIN でのみ返されます。 - 行は一致する行の数だけ表示されます。上の例で Butler が2回表示されるのは、2冊の本と一致するためです。その後 authors テーブルの列を合計すると、彼女の値は2回カウントされます。
-
外部結合では、もう一方のテーブルに対する条件は
ONに書きます。WHEREに書くと結合後に評価され、結合で残したばかりの NULL の行が除外されてしまいます。
-- Input: the authors and books tables above

-- Only Butler is left: the WHERE drops every author whose title is NULL
SELECT a.name, b.title
FROM authors a
LEFT JOIN books b ON a.id = b.author_id
WHERE b.title LIKE 'K%';

-- Output:
-- name   | title
-- -------+--------
-- Butler | Kindred

-- Every author is kept, with a book only where it starts with K
SELECT a.name, b.title
FROM authors a
LEFT JOIN books b ON a.id = b.author_id AND b.title LIKE 'K%';

-- Output:
-- name    | title
-- --------+--------
-- Le Guin | NULL
-- Butler  | Kindred
-- Asimov  | NULL
代替構文
MySQL には FULL OUTER JOIN がありません。代わりに、LEFT JOIN と RIGHT JOIN の一致しない行を組み合わせます。
-- MySQL
-- Input: the authors and books tables above

SELECT a.name, b.title
FROM authors a LEFT JOIN books b ON a.id = b.author_id
UNION ALL
SELECT a.name, b.title
FROM authors a RIGHT JOIN books b ON a.id = b.author_id
WHERE a.id IS NULL;

-- Output:
-- name    | title
-- --------+---------------------
-- Le Guin | The Dispossessed
-- Butler  | Parable of the Sower
-- Butler  | Kindred
-- Asimov  | NULL
-- NULL    | Beowulf
バージョン 3.39 より前の SQLite には RIGHT JOIN も FULL OUTER JOIN もありません。テーブルを入れ替えて LEFT JOIN を使いましょう。
アンチ結合は NOT EXISTS でも書けます。この用途に NOT IN は避けてください。ここでの Beowulf の author_id のように、サブクエリが NULL を1つでも返すと、NOT IN は何も返さなくなります。
-- Input: the authors and books tables above

SELECT a.name
FROM authors a
WHERE NOT EXISTS (SELECT 1 FROM books b WHERE b.author_id = a.id);

-- Output:
-- name
-- ------
-- Asimov

SELECT a.name
FROM authors a
WHERE a.id NOT IN (SELECT author_id FROM books);

-- Output:
-- name
-- ----
-- (0 rows)
照合する列の名前が両方のテーブルで同じ場合は、ON 条件の代わりに JOIN books USING (author_id) と書けます(SQL Server を除く)。
古いコードでは、テーブルをカンマで並べて照合条件を WHERE に書くことがよくあります。これは INNER JOIN の別の書き方です。WHERE を省くと CROSS JOIN になります。
-- Input: the authors and books tables above

SELECT a.name, b.title
FROM authors a, books b
WHERE a.id = b.author_id;

-- Output:
-- name    | title
-- --------+---------------------
-- Le Guin | The Dispossessed
-- Butler  | Kindred
-- Butler  | Parable of the Sower
SQL JOIN はいつ使うべきか?
必要なデータが複数のテーブルに分かれているときは JOIN を使います。どの JOIN を使うかは一致しない行をどう扱うかで決まり、ほとんどのケースは次の5つのいずれかに当てはまります。
関連テーブルから詳細を参照する
従業員の行には部署 ID がありますが、レポートには部署名が必要です。INNER JOIN で部署名を取得でき、参照先のない行は除外されます。
一致しない行も残す
まだ部署が割り当てられていない従業員のように関連データが任意の場合、INNER JOIN ではその行が気づかないうちに消えてしまいます。LEFT JOIN ならメインテーブルのすべての行を残し、欠けた部分を NULL で埋めます。
空のものも含めてすべての項目を一覧にする
レポートでは、まだ中身がないものも含めて、すべての部署、カテゴリ、顧客が必要になることがよくあります。そのテーブルを、すべての行が残る側にしましょう。LEFT JOIN なら1つ目、RIGHT JOIN なら2つ目に置きます。
一致しない行を見つける
一度も注文していない顧客、一度も売れていない商品、部署のない従業員など、アンチ結合は欠けているものを見つけられるため、データ品質のチェックにも役立ちます。
すべての組み合わせを作る
CROSS JOIN は、まだ存在しない行を生成します。すべてのサイズとすべての色、すべての従業員とすべての研修コース、あるいはレポート期間の毎日とすべての店舗などの組み合わせです。
SQL JOIN の実例
学生と受講コース
多対多の関係では、学生とコースをつなぐ中間テーブルを介して2回の INNER JOIN が必要です。Mei は何も登録していないため、一覧に表示されません。
-- Input: students
-- id | name
-- ---+------
-- 1  | Amara
-- 2  | Lucas
-- 3  | Mei

-- Input: enrollments
-- student_id | course_id | grade
-- -----------+-----------+------
-- 1          | 10        | A
-- 1          | 20        | B
-- 2          | 10        | B

-- Input: courses
-- id | course_name
-- ---+------------
-- 10 | Databases
-- 20 | Statistics

SELECT s.name, c.course_name, e.grade
FROM students s
INNER JOIN enrollments e ON s.id = e.student_id
INNER JOIN courses c ON e.course_id = c.id;

-- Output:
-- name  | course_name | grade
-- ------+-------------+------
-- Amara | Databases   | A
-- Amara | Statistics  | B
-- Lucas | Databases   | B
プロフィールが任意のユーザー
すべてのユーザーがプロフィールを入力しているわけではありません。LEFT JOIN ならすべてのユーザーを残せます。
-- Input: users
-- id | username
-- ---+---------
-- 1  | rosa_m
-- 2  | devon
-- 3  | kai_l

-- Input: user_profiles
-- user_id | bio
-- --------+------------------------
-- 1       | Data engineer in Lisbon
-- 3       | Loves SQL puzzles

SELECT u.username, p.bio
FROM users u
LEFT JOIN user_profiles p ON u.id = p.user_id;

-- Output:
-- username | bio
-- ---------+------------------------
-- rosa_m   | Data engineer in Lisbon
-- devon    | NULL
-- kai_l    | Loves SQL puzzles
全顧客の注文数
注文のない顧客も含めるには、customers から LEFT JOIN します。そして orders テーブルの列をカウントしてください。COUNT(*) だと LEFT JOIN が Omar のために作った行もカウントされ、0 ではなく 1 になってしまいます。
-- Input: customers
-- id | name
-- ---+------------
-- 1  | Harper Lee
-- 2  | Omar Haddad
-- 3  | Yuki Tanaka

-- Input: orders
-- id  | customer_id | total
-- ----+-------------+-------
-- 101 | 1           | 59.90
-- 102 | 3           | 120.00
-- 103 | 1           | 14.50

-- Wrong: COUNT(*) counts Omar's NULL row
SELECT c.name, COUNT(*) AS order_count
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
GROUP BY c.id, c.name
ORDER BY c.id;

-- Output:
-- name        | order_count
-- ------------+------------
-- Harper Lee  | 2
-- Omar Haddad | 1
-- Yuki Tanaka | 1

-- Right: COUNT(o.id) skips it
SELECT c.name, COUNT(o.id) AS order_count
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
GROUP BY c.id, c.name
ORDER BY c.id;

-- Output:
-- name        | order_count
-- ------------+------------
-- Harper Lee  | 2
-- Omar Haddad | 0
-- Yuki Tanaka | 1
一致しない請求書と支払い
一致しない行だけを残す FULL OUTER JOIN を使えば、1つのクエリで2つのリストを突き合わせられます。請求書 502 は未払いで、支払い 9003 は存在しない請求書に対するものです。
-- Input: invoices
-- invoice_id | amount
-- -----------+-------
-- 501        | 120.00
-- 502        | 75.50
-- 503        | 300.00

-- Input: payments
-- payment_id | invoice_id | paid
-- -----------+------------+-------
-- 9001       | 501        | 120.00
-- 9002       | 503        | 300.00
-- 9003       | 504        | 42.00

-- MySQL has no FULL OUTER JOIN: use the UNION ALL form under "Alternative syntax"
SELECT i.invoice_id, i.amount, p.payment_id, p.invoice_id AS paid_invoice
FROM invoices i
FULL OUTER JOIN payments p ON p.invoice_id = i.invoice_id
WHERE i.invoice_id IS NULL OR p.payment_id IS NULL;

-- Output:
-- invoice_id | amount | payment_id | paid_invoice
-- -----------+--------+------------+-------------
-- 502        | 75.50  | NULL       | NULL
-- NULL       | NULL   | 9003       | 504
売上のない日も含めた全店舗の日次売上
店舗と日付を CROSS JOIN して店舗ごと・日ごとに1行を作り、そのグリッドに売上を LEFT JOIN します。York は10月6日に売上がありませんでしたが、それでも行が作られます。
-- Input: stores
-- store
-- -----
-- Leeds
-- York

-- Input: days
-- day
-- ----------
-- 2026-10-05
-- 2026-10-06

-- Input: sales
-- store | day        | amount
-- ------+------------+-------
-- Leeds | 2026-10-05 | 410.00
-- Leeds | 2026-10-06 | 385.50
-- York  | 2026-10-05 | 220.00

SELECT st.store, d.day, COALESCE(SUM(s.amount), 0.00) AS takings
FROM stores st
CROSS JOIN days d
LEFT JOIN sales s ON s.store = st.store AND s.day = d.day
GROUP BY st.store, d.day
ORDER BY st.store, d.day;

-- Output:
-- store | day        | takings
-- ------+------------+--------
-- Leeds | 2026-10-05 | 410.00
-- Leeds | 2026-10-06 | 385.50
-- York  | 2026-10-05 | 220.00
-- York  | 2026-10-06 | 0.00
SQL JOIN についてさらに学ぶ
このブログの記事:
- SQL JOIN チートシート: すべての JOIN の種類と図を1ページにまとめました
- MySQL FULL OUTER JOIN: MySQL に FULL OUTER JOIN がない問題を回避する他の方法
- MySQL JOIN ガイド: MySQL での JOIN を例とともに解説
- SQL Server JOIN ガイド: T-SQL での JOIN
- PostgreSQL CROSS JOIN: すべての組み合わせを作るクエリの他の使い方
- データベースのリレーションガイド: 結合するテーブル同士がどう関係しているか
- 1対1のリレーション、1対多のリレーションガイド、多対多のリレーションガイド: 各リレーションに必要な JOIN
- SQL COALESCE ガイド: 外部結合で残った NULL を置き換える
公式ドキュメント:
 Beekeeper Studioは無料のオープンソースのデータベースGUIです
これまで使った中で最高のSQLクエリ&エディタツールです。データベースの管理に必要なものがすべて揃っています。 - ⭐⭐⭐⭐⭐ Mit
Beekeeper Studioは高速で直感的、そして使いやすいツールです。多数のデータベースに対応し、Windows、Mac、Linuxで快適に動作します。
Beekeeper Studio 利用者の声
「Beekeeper Studio は以前の SQL ワークフローを完全に置き換えました。高速で直感的で、データベース作業がまた楽しくなりました。」
「多くのデータベース GUI を試しましたが、Beekeeper は機能とシンプルさのバランスが完璧です。とにかくちゃんと動きます。」